登录社区云,与社区用户共同成长
邀请您加入社区
随着大模型训练场景的多样化发展,模型需要在不同硬件平台上保持一致的训练精度。本工作旨在将 GLM-5.2 模型结构接入 MindFormers PyNative 框架,并以 GPU 上的 Megatron-LM 为参考基准,验证 Ascend NPU 与 NVIDIA GPU 在单卡训练场景下的精度一致性。通过系统化的对齐流程,确保模型在不同硬件平台上的训练行为可复现、可预期,为后续多卡扩展和实际
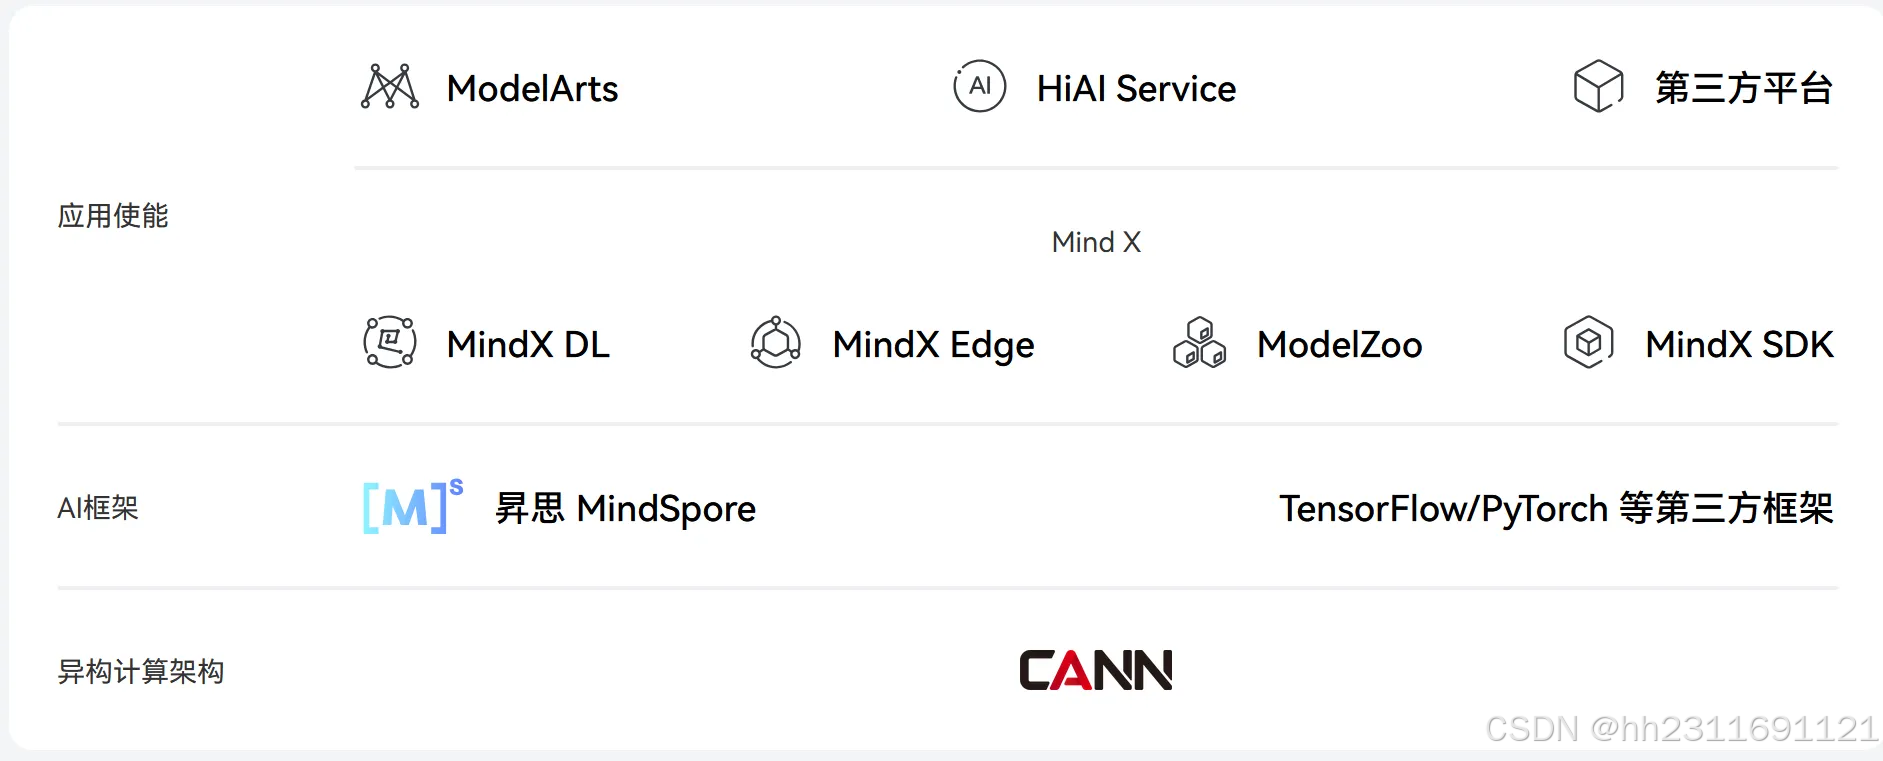
最底层是华为自主的独立计算框架CANN(类比CUDA)向上是基于CANN计算框架的开发工具,其中包括独立的MindSpore和依赖于传统框架TensorFlow/PyTorch的CANN支持方案如(torch-npu)再向上可能是类似,Mindfomers,LLama-Factory,Transfomers,Diffusers等依赖于上面框架集成的更快速的开发工具再最后就是实际应用部分下面简单介绍
MindSpore快速对Wan2.1进行适配,并将其开源至MindSpore ONE仓库,结合昇腾硬件,为开发者提供高效体验。在AI视频生成领域,Wan2.1作为最新的视觉生成模型,能够根据文本、图像或其他控制信号生成视频,以其卓越表现备受关注。可自定义prompt,生成480P个性化视频,通过调小sample_guide_scale参数增强视频画面质量,或者调大该参数以增强视频-文本匹配程度。支
在Ascend昇腾310P3推理卡上使用ATC(Ascend Tensor Compiler)工具进行模型转换
2024年人工智能应用场景算法“赛马”火热报名中,速用昇思参赛赢取千万项目!
通过本文自注意力机制self-attention的过程解析,首先通过输入词的query和key相乘计算出一个关系权重,再用这个关系权重对value进行加权求和,以提升一个序列中相关向量的权重,降低不相关元素的权重。在计算完自注意力分数后,我们看到后面还有一个softmax计算,考虑到softmax的图形,在值越大的地方梯度会越小,所以如果上一步计算出的分数值越大,那样就会出现梯度小时的情况,此时就
2024第七届CCF开源创新大赛赛题解读|昇思Mindspore赛道。
训练日志将保存在 output/logs 目录下。模型 checkpoint 会定期保存在 output/ckpts 目录。训练初期 loss 波动较大属于正常现象,建议训练超过1000步再评估效果。如遇到命令行换行符问题,可尝试去除反斜杠后在单行执行。确保系统内存充足,推荐预留50%以上空闲内存。存储 >= 1TB NVMe SSD。预训练语料库(WikiText-2)固件与驱动版本 24.1.
本届1024程序员节以“智能应用新生态”为主题,10月24日-26日在长沙盛大举行,设置了岳麓对话、技术英雄会和8场高峰/主题论坛,邀请了200+位技术专家,1024+名程序员现场参与大会!技术改变世界,开发者塑造未来。为了向奋战在各个岗位的技术人致敬,2024长沙·中国1024程序员节也如期而至。活动详情与直播:https://1024.csdn.net/
序列标注指给定输入序列,给序列中每个Token进行标注标签的过程。序列标注问题通常用于从文本中进行信息抽取,包括分词(Word Segmentation)、词性标注(Position Tagging)、命名实体识别(Named Entity Recognition, NER)等。以命名实体识别为例:如上表所示,清华大学和北京是地名,需要将其识别,我们对每个输入的单词预测其标签,最后根据标签来识别实
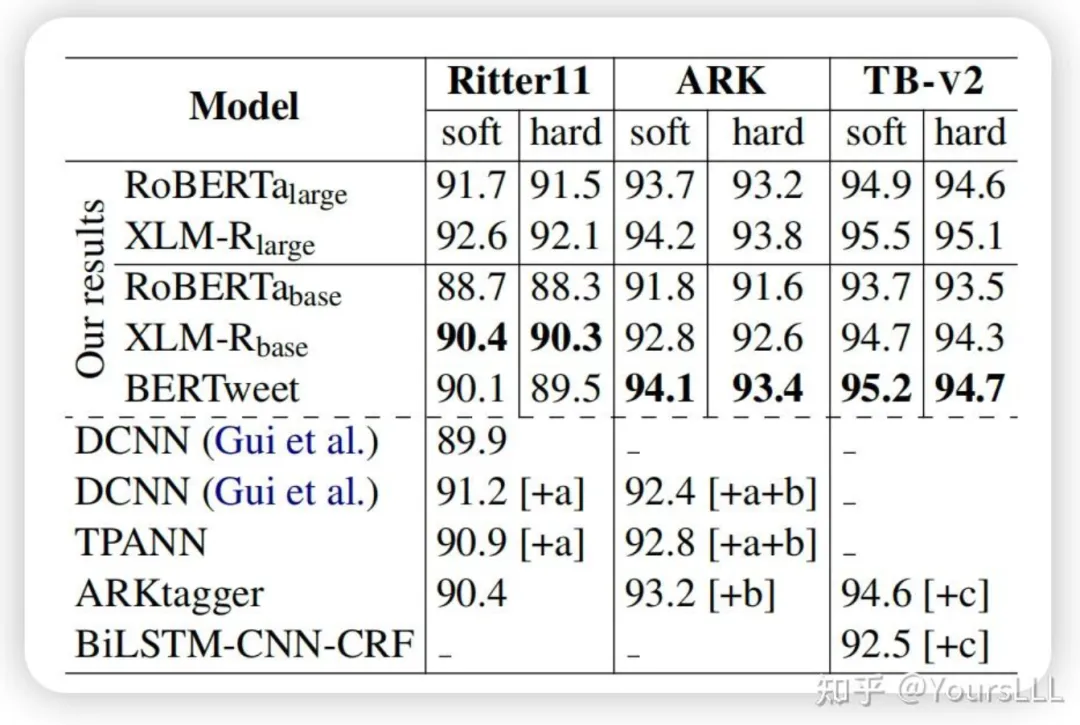
BERTweet是一款专门为英语推文设计的大规模预训练语言模型,通过RoBERTa方法在850M条推文数据上训练,使其在推文特定任务(POS、NER、文本分类)上达到最优表现。研究的结果验证了针对。尽管BERTweet的数据量小于XLM-R和RoBERTa的训练数据,但通过RoBERTa的优化预训练方法,模型在处理推文任务时能更好地提取领域特征。BERTweet利用850M条推文数据进行训练,而R
MindNLP是一个基于MindSpore的开源NLP库,旨在为自然语言处理任务提供一个解决方案平台。它包含了NLP中的许多常用方法,可以帮助研究人员和开发人员更方便快捷地构建和训练模型。全面的数据处理:封装了多个经典NLP数据集,如Multi30k、SQuAD、CoNLL等,使用起来非常方便。友好的NLP模型工具集:提供了多种可配置的组件,方便使用MindNLP自定义模型。易用的训练引擎:简化了