登录社区云,与社区用户共同成长
邀请您加入社区
本文通过pandas的sort_values方法实现订单表多维度排序。核心思路:用by指定排序列,ascending控制升序或降序。支持单列倒序(如销量从高到低)、升序(如单价从低到高),以及多列复合排序——先按单价升序,再按销量降序,优先级由列表顺序决定。为便于观察,仅读取前10行数据,提升演示直观性。代码简洁高效,体现“一行代码解决复杂排序”的Python数据分析优势。
*1970年,仙童半导体公司生产出了第一个较大容量的半导体存储器,**这块芯片的读写是非破坏性的,而且读写速度比磁芯快得多,读出一位只要70ns,但是其价格比磁芯要高。未来,基于量子、光子、碳基电子等技术构造的新型芯片或将打破电路元件的限制,衍生出运算速度更快的计算机。经历20世纪末的低谷之后,在国家产业政策和重点研发计划支持下,我国国产处理器自21世纪初奋起直追,多家处理器研发单位快速成长,逐步
后续8008、8080、8086等芯片陆续推出,处理器位宽不断提升,从8位、16位逐步发展到现在的64位处理器。我们日常所说的计算机,一般都指电子数字计算机,也叫电脑。本章从计算机分类、发展历史入手,自上而下介绍计算机的基本构成,帮助我们建立对计算机软硬件体系的整体认知。国内处理器起步相对较晚,经过多年科研攻关,龙芯、海光、鲲鹏、飞腾等国产处理器已经实现自主设计,在服务器、嵌入式等场景落地应用,逐
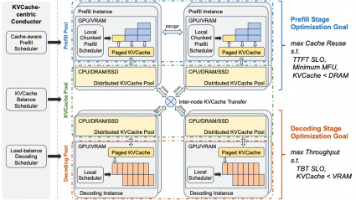
生成式推荐(GR)因请求高密、前缀稳定,导致KV Cache重复计算与显存瓶颈。本文介绍了用户粒度KV Cache和池化管理方案,通过将KV Cache从单卡显存扩展到集群级池化存储,提升前缀命中率和缓存容量,从而降低首token延迟和单位请求成本。文章深入解析了vLLM-Ascend的落地设计,包括Prefix Cache和PD分离、用户粒度管理、Mooncake内存池等技术细节,为优化GR大模
print(df.groupby(“书名”)[“字数”].sum().sort_values(ascending=False))print(df.groupby(“分类”)[“字数”].agg([“count”,“sum”,“mean”]))print(“历史分类平均字数:”, df.loc[df[“分类”]==“历史”,“字数”].mean())仓库:https://github.com/hao
昇思大模型提示学习的多样性,是 OrangePi Alpro 实现边缘轻量化大模型落地的关键技术。通过指令、格式、少样本、推理控制四大类多样化设计,无需模型微调即可适配问答、分类、摘要、故障检测等多场景任务。结合鲲鹏 ARM64 硬件加速与 INT8 量化,在低功耗、轻资源条件下实现稳定高效推理,真正做到一模型多用、低成本部署。
在昇腾环境中,我使用 AISBench 通过 OpenAI-compatible vLLM API,对 Qwen3.6-35B-A3B 模型进行能力评测。在完成 BoolQ 和 GSM8K 后,mentor 希望进一步评价模型在中文金融、经济和法律专业知识方面的表现,因此从 CEval 中选择了六个相关子任务:六科验证集共计 233 道单项选择题,评价指标为 Accuracy。3. CEval 数
基础准备(1-2周):掌握PyTorch和Attention基础原理入门(2-3周):理解FlashAttention原理,复现V1代码实战(3-4周):掌握Ops-Transformer,在昇腾NPU上部署性能调优(2-3周):学会性能分析,速度提升50%社区贡献(持续):提交PR,成为Contributor总时长:10-12周(每天2-3小时)学习资源论文:FlashAttention系列(V
平台发布者支持语言易用性大规模训练能力定位PyTorchFacebookPython/C++★★★★优秀学术研究首选TensorFlowGoogle★★★优秀工业部署广泛KerasGooglePython★★★★★一般入门友好百度Python★★★良好中文生态完善MindSpore华为Python★★★良好昇腾硬件适配目前PyTorch因其动态图机制和易用性,已成为学术界的主流选择,约80%的研究