登录社区云,与社区用户共同成长
邀请您加入社区
先采集、再定界;先 device、后 host;先微基准、后端到端;每项 env 门控、逐项验证、负结果入档。这套纪律让性能优化从「凭经验试」变成了可测量、可复现、可回退的工程流程——这正是科研模型最需要的。
过去,团队的开发机是 Intel/AMD 芯片,编译出来的 Docker 镜像自然都是架构。然而一旦把介质包送进国有大行、电网、电信运营商或政府政务云机房,现场的物理服务器清一色是基于国产 ARM64 架构的芯片(如华为鲲鹏 920、飞腾腾云 S2500)。如果交付团队没有在出厂阶段做好多架构交叉编译,到了现场一执行docker run。
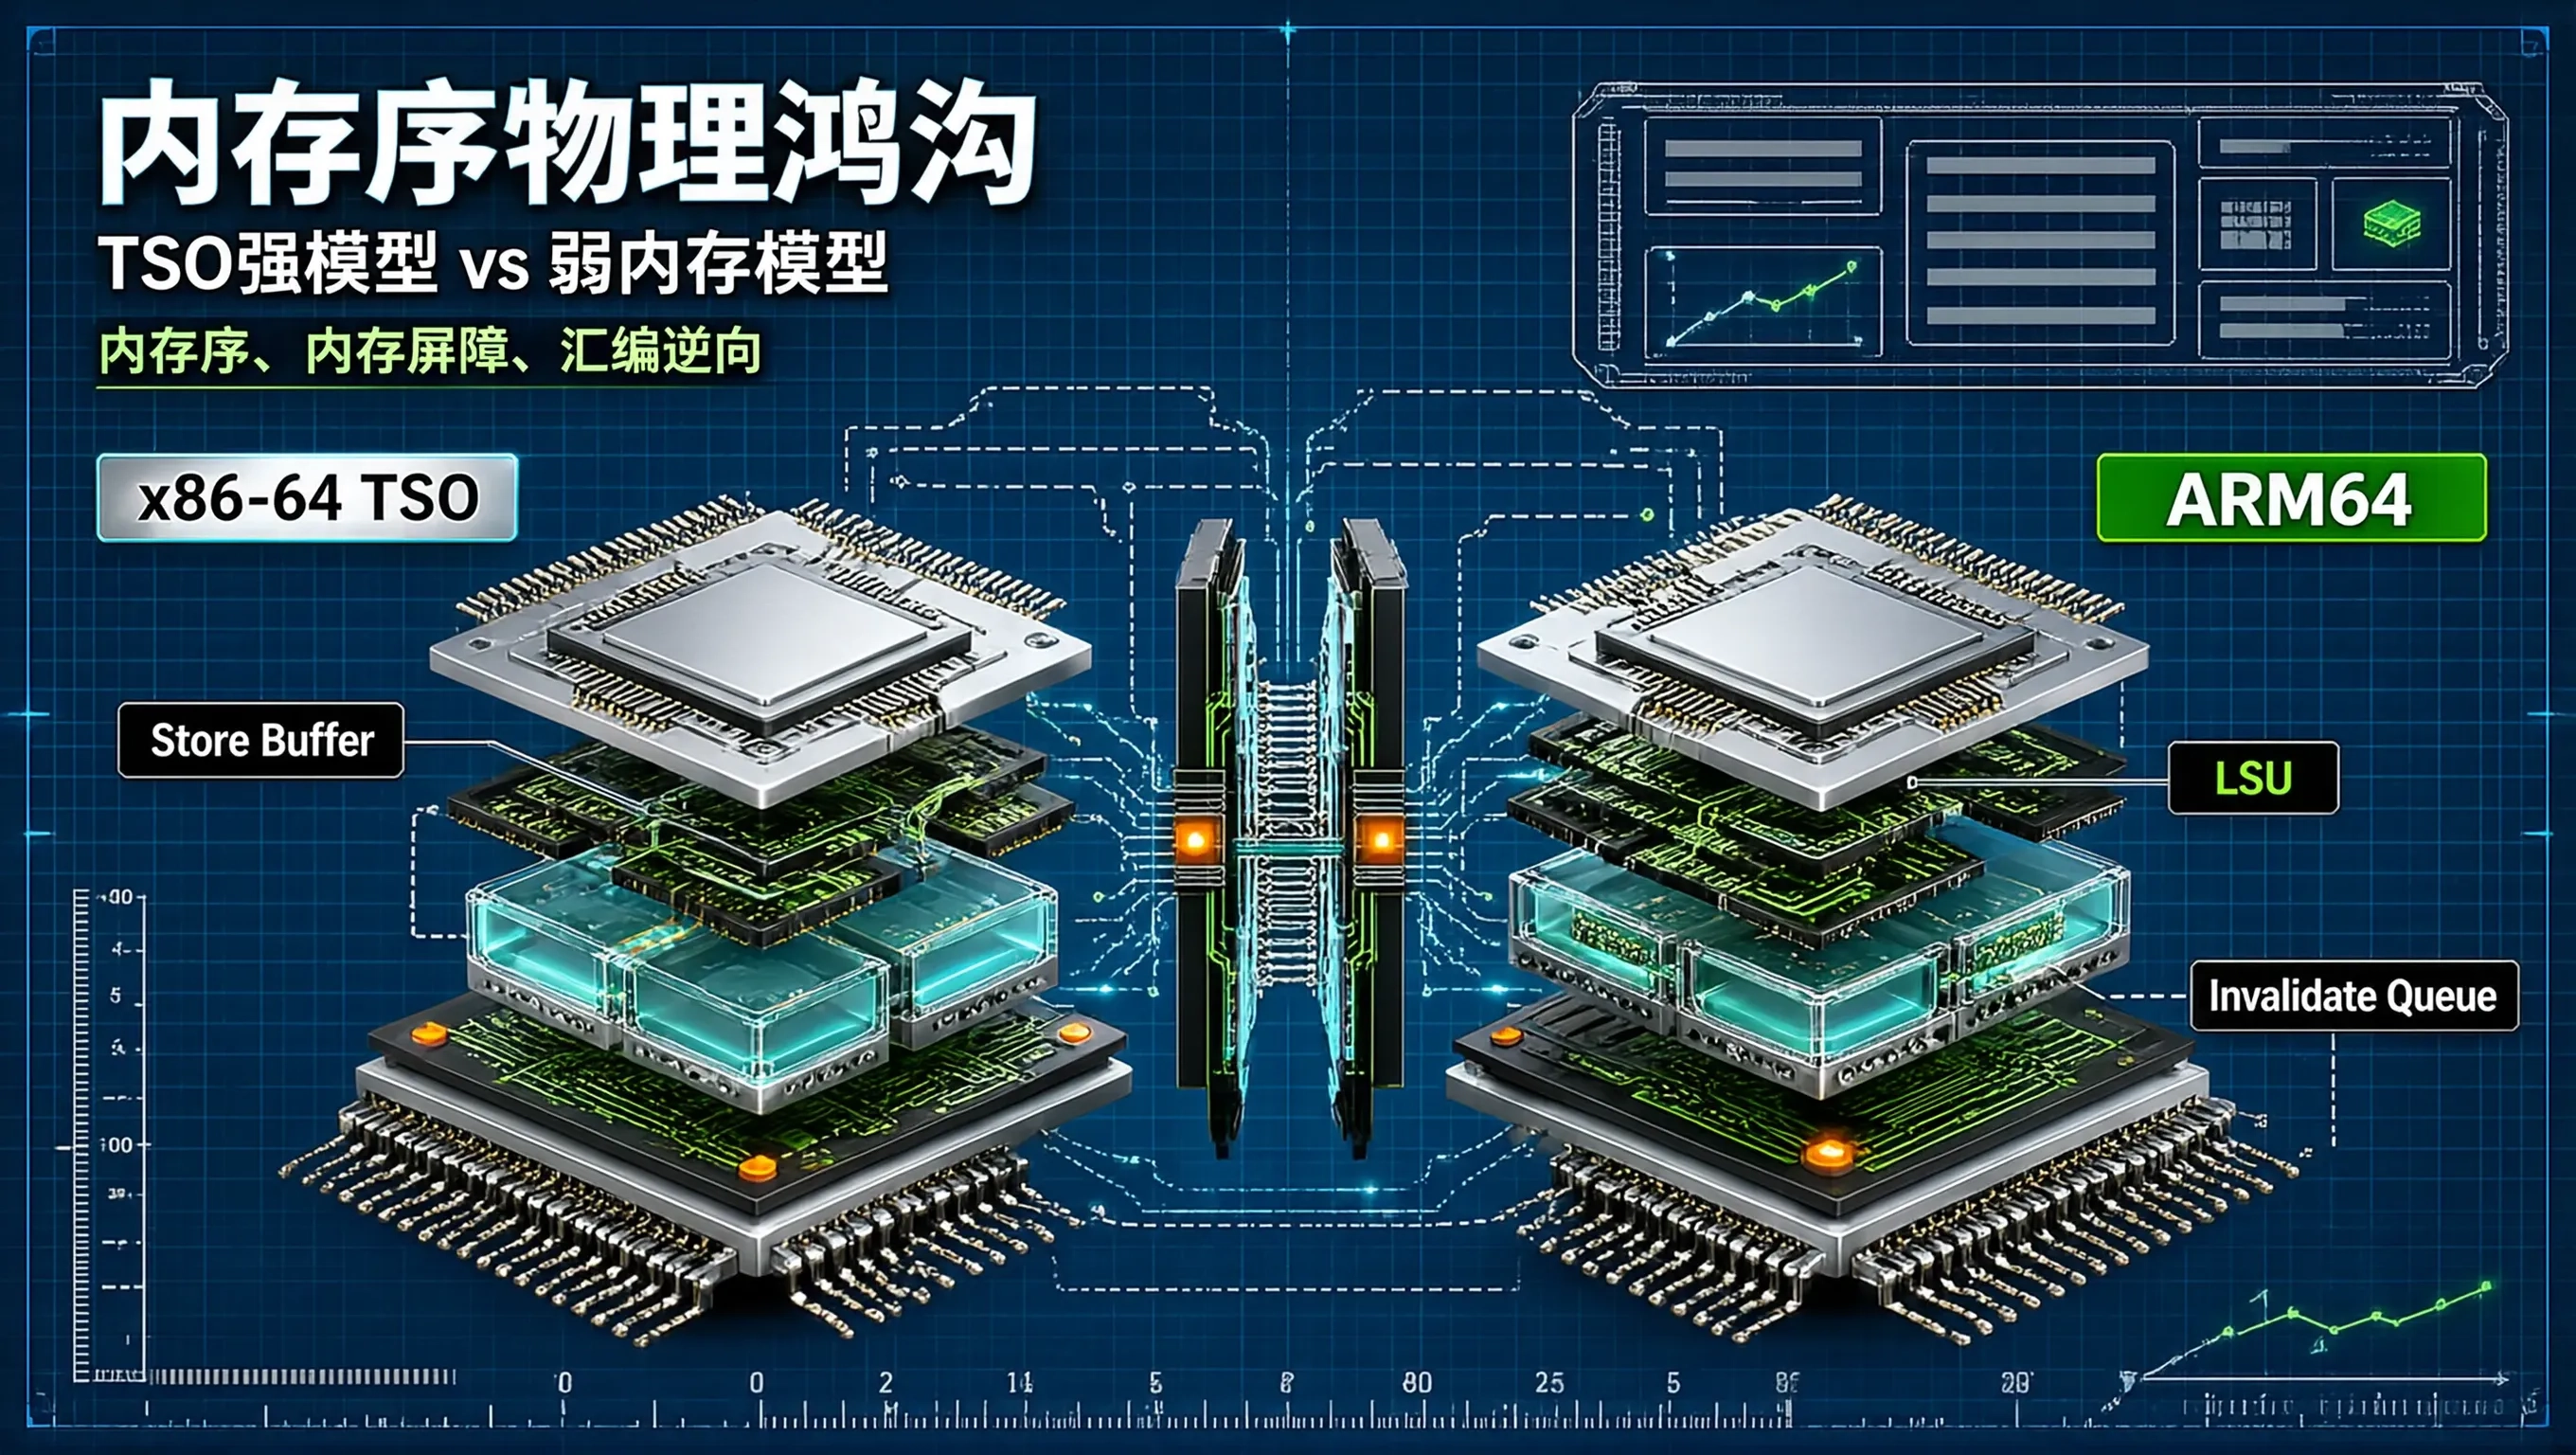
在现代高性能系统级编程(C++、Rust、Go)中,内存序(Memory Ordering)与原子操作是无锁并发数据结构(如无锁队列、原子引用计数、无锁跳表)中最深奥、也最容易引发诡异并发 Bug 的微架构深水区。然而,高级语言层面上完全相同的 Acquire-Release 代码,在 x86-64 架构芯片(Intel / AMD)与 ARM64 架构芯片(Apple Silicon、AWS G
时间里程碑核心变化2023 年LMDeploy 开源MMRazor + MMDeploy 团队联合发布2024 年PyTorch Engine 成熟支持 DeepSeek-V2、华为 Ascend、CUDA Graph2025 年DeepSeek 优化集成 FlashMLA、DeepGemm、DeepEP2025 年 9 月V100 起支持,H800 上达 vLLM 1.5 倍性能2026 年 2