登录社区云,与社区用户共同成长
邀请您加入社区
*语言识别机制**:原生通过**文件后缀**识别源语言,通过 `_write_ninja_file` 里**硬编码的编译器变量**(`$cxx`/`$nvcc`/`$sycl`)和**硬编码的编译规则**(`compile`/`cuda_compile`/`sycl_compile`)路由编译。| 注册 `.asc` 到 `src_extensions` | NPU 适配层(`_LazyBuild
本文记录了在AscendNPU上使用PyTorch 2.14.0+TorchNPU训练Qwen3.5模型时,启用DVM编译所遇问题及解决方案。涉及Triton后端(引入aprof_pub.h、优先加载TorchNPU ACL头文件、升级至C++20)、TorchNPUInductor适配层(修复非张量参数处理、关闭FlexAttention自定义Lowering、补齐Grid维度)以及模型代码修改
在 Ascend NPU 上使用进行 FLUX 模型训练时,开发者可能会遇到编译链路和分布式通信方面的基础设施问题。本文基于实际训练场景,系统梳理了从环境搭建、DVM 后端验证到常见报错修复的完整流程,旨在帮助开发者快速定位并解决类似问题。环境信息基于 torchtitan main 分支修改报错一:编译器 IR 类型兼容问题,让提前返回即可解决。报错二:分布式通信端口问题,为当前任务分配独立的
本文通过pandas的sort_values方法实现订单表多维度排序。核心思路:用by指定排序列,ascending控制升序或降序。支持单列倒序(如销量从高到低)、升序(如单价从低到高),以及多列复合排序——先按单价升序,再按销量降序,优先级由列表顺序决定。为便于观察,仅读取前10行数据,提升演示直观性。代码简洁高效,体现“一行代码解决复杂排序”的Python数据分析优势。
数字人赛道正从概念验证走向规模化落地。行业调研数据显示,2025年国内数字人带动的整体市场规模已进入千亿级区间,中小实体商家的接入需求持续上升。在这一背景下,深圳启元智胜科技有限公司旗下品牌盈启鲲鹏,围绕AI数字人直播系统开放区域合作,其招商政策的构成逻辑值得关注。
随着大模型训练场景的多样化发展,模型需要在不同硬件平台上保持一致的训练精度。本工作旨在将 GLM-5.2 模型结构接入 MindFormers PyNative 框架,并以 GPU 上的 Megatron-LM 为参考基准,验证 Ascend NPU 与 NVIDIA GPU 在单卡训练场景下的精度一致性。通过系统化的对齐流程,确保模型在不同硬件平台上的训练行为可复现、可预期,为后续多卡扩展和实际
在 Ascend NPU 环境下运行 PyTorch 模型时,需要正确配置 PyTorch、torch_npu 插件以及 CANN 基础软件栈。由于各组件之间存在严格的版本依赖关系,配置过程若操作不当,容易导致运行时错误。本文旨在提供一套清晰、可复现的配置流程,帮助开发者快速搭建或定制开发环境。快速二进制包安装(适用于日常开发和快速部署)和源码编译安装(适用于源码级问题定位与功能增强)。
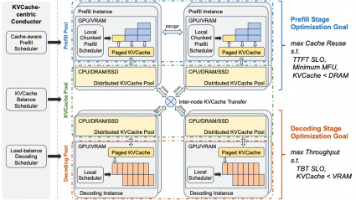
生成式推荐(GR)因请求高密、前缀稳定,导致KV Cache重复计算与显存瓶颈。本文介绍了用户粒度KV Cache和池化管理方案,通过将KV Cache从单卡显存扩展到集群级池化存储,提升前缀命中率和缓存容量,从而降低首token延迟和单位请求成本。文章深入解析了vLLM-Ascend的落地设计,包括Prefix Cache和PD分离、用户粒度管理、Mooncake内存池等技术细节,为优化GR大模