
Ascend C 学习(个人学习总结,如有侵犯我会删除)
算子的基本概念:

算子就是在神经网络中的每个节点的技术处理,即:在前馈神经网络中每个神经元都要对一个样本的特征进行线性处理,激活处理,这里一个神经元的处理过程就是一个算子概念。
-
算子的名字:
算子的名字,用于标志网络
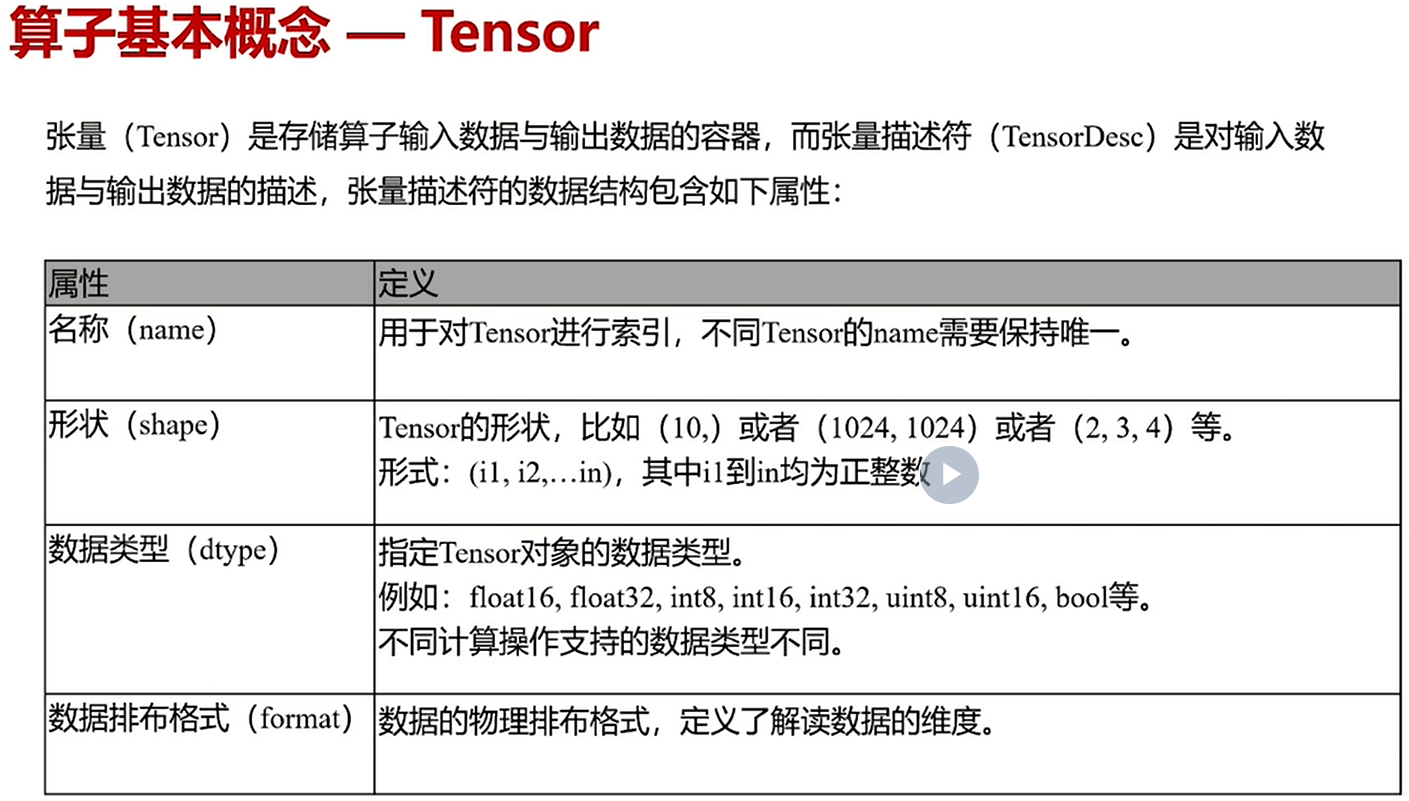 中的,某个算子,统一网络中的名称需要保持一致。例如:conv1,pool1就是算子名称
-
算子的类型:
神经网络中,每一个 算子根据算子类型进行算子实现匹配,相同算子实现逻辑相同。一个网络中,同类型算子可能有多个,例如:cov1、conv2就是同类型算子。
-
数据容器:
算子在计算中需要输入,这个输入的数据就是张量,张量承载算子的计算结果容器。
CANN 与 Ascend C
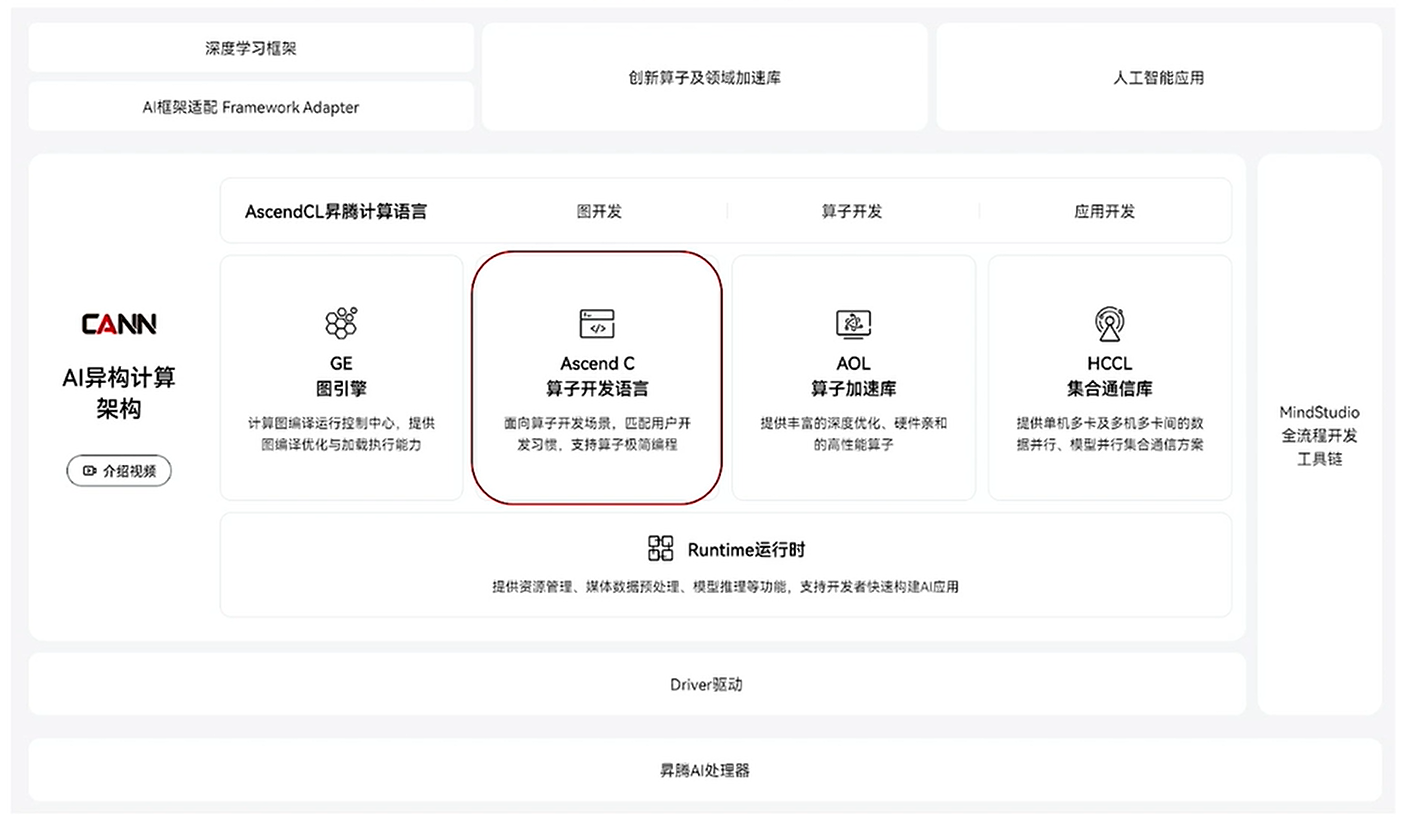
CANN
组成:GE、Ascend C 、AOL、HCCL
开发者在使用这些算子时,需要调用统一的接口,这个统一的接口叫做:AscendCL-昇腾计算语言,其中包括但不限于图开发,算子开发,应用开发等。
ai处理器
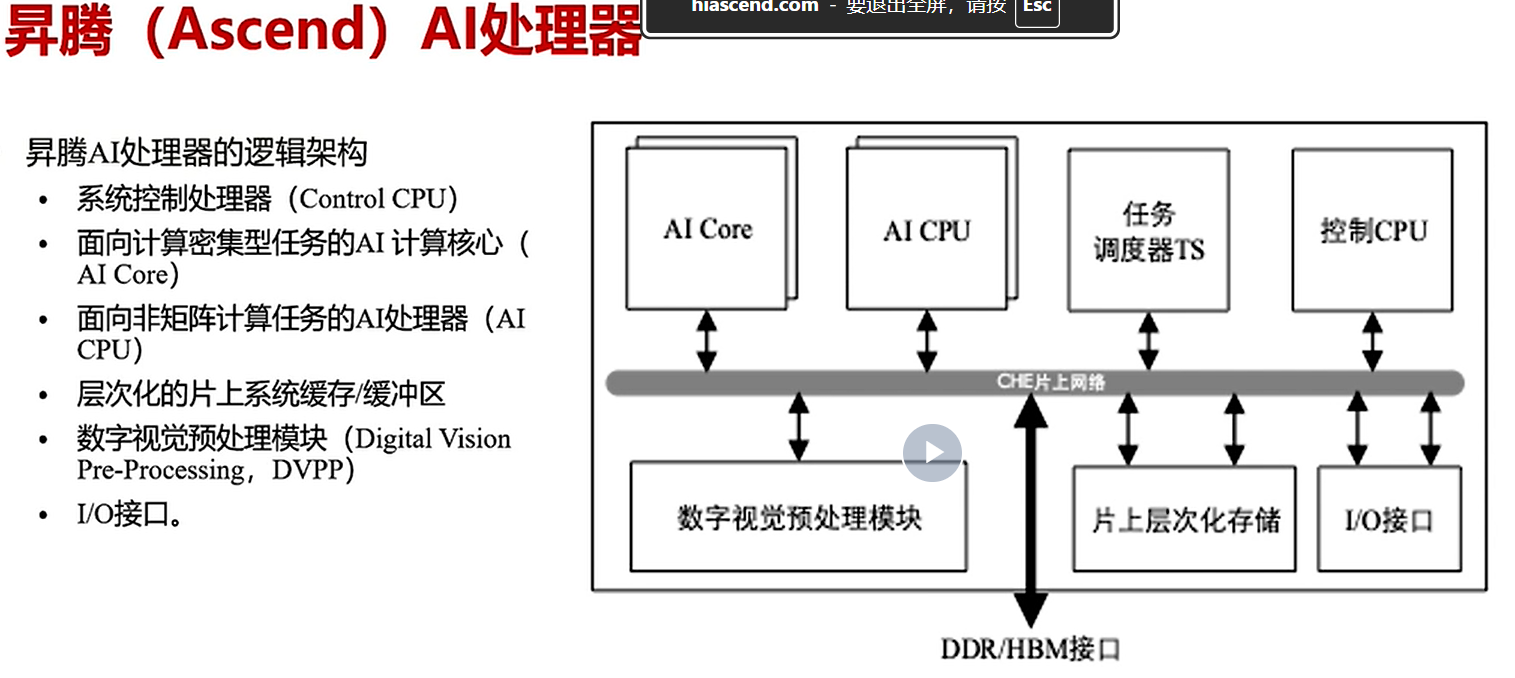
组成:cup,ai core,数字视觉处理模块,缓冲区等,算子计算主要在ai core 中做计算。
ai core介绍:
ai core是昇腾ai处理器的计算核心,采用达芬奇架构。
ai core早期逻辑图
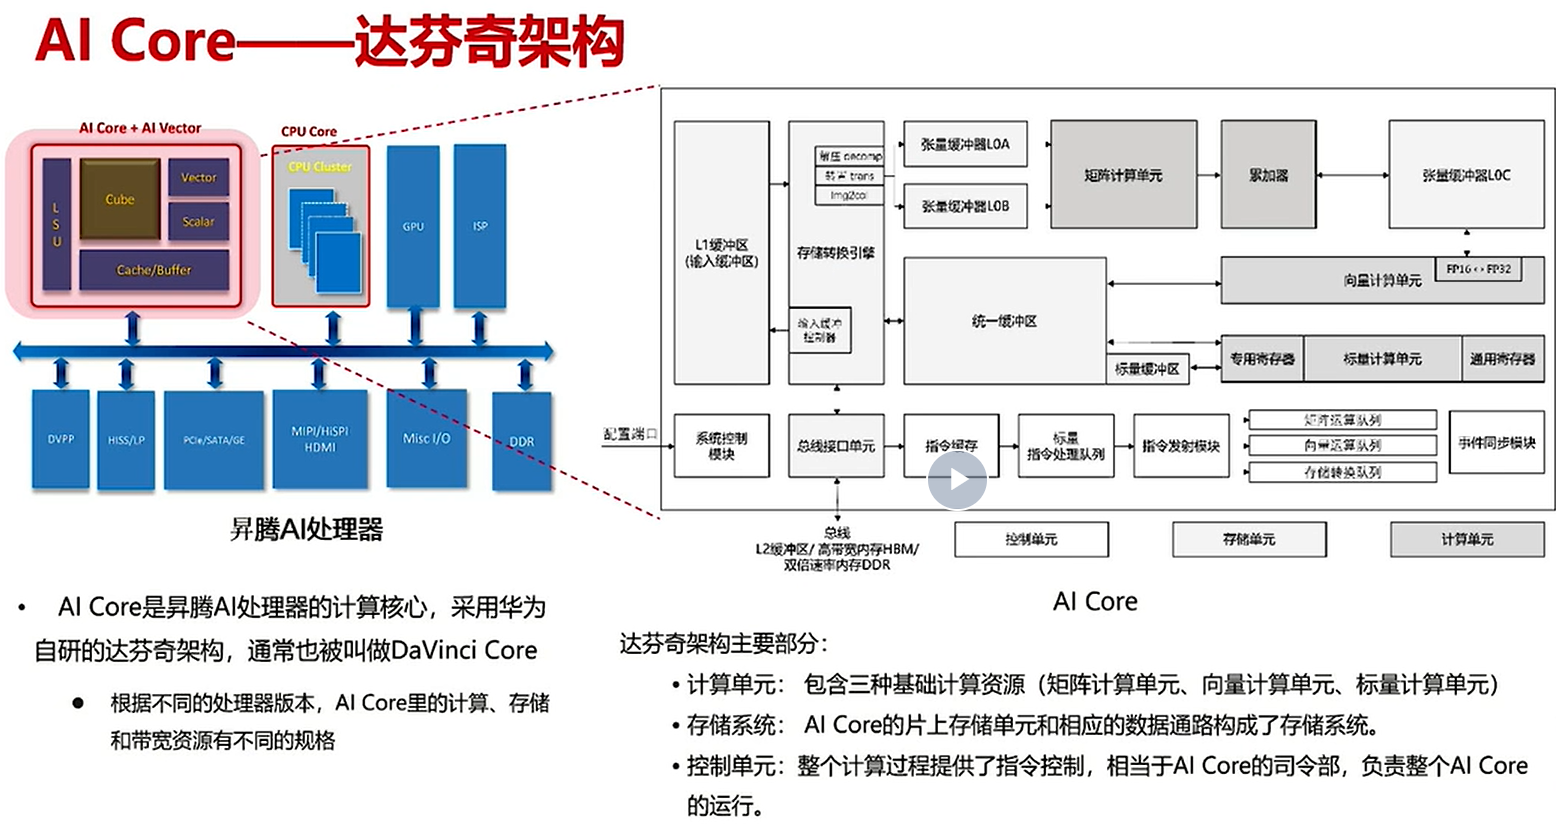
这张图抽象地展示了昇腾(Ascend)AI处理器核心——AI Core的内部并行计算架构。其核心思想是“控制与计算分离,搬运与计算并行”。
以下是根据图片内容对AI Core架构的详细总结:
一、 AI Core 的三大核心组件
AI Core 内部主要由计算单元、存储单元和搬运单元三大部分组成:
-
计算单元(包含三种基础计算资源)
-
Scalar(标量计算单元):充当“指挥官”或“CPU”的角色。负责执行地址计算、循环控制等标量任务,并负责将指令下发给Vector、Cube、DMA等单元,同时负责各单元间的同步。
-
Vector(向量计算单元):充当“向量计算引擎”。专门负责执行向量(一维数组)运算,如逐元素的加、减、乘、除及激活函数等。
-
Cube(矩阵计算单元):充当“矩阵加速引擎”。专门负责执行矩阵(二维数组)乘加运算(如GEMM、卷积等),是深度学习中最核心的算力来源。
-
-
存储单元(Storage Unit)
-
Local Memory(片上局部内存):是 AI Core 内部的高速缓存(通常为SRAM)。它是所有计算单元(Vector/Cube)直接读取数据和存放结果的“工作台”,速度极快但容量有限。
-
Global Memory(全局内存):指AI Core外部的存储,通常是DDR内存。容量大但速度相对较慢,用于存放输入和输出的大规模数据。
-
-
搬运单元(搬运单元)
-
DMA(Direct Memory Access,直接内存访问):充当“高速数据搬运工”。
-
包含 MTE2(数据搬入引擎) 和 MTE3(数据搬出引擎)。
-
它不占用计算单元的资源,专门负责在慢速的 Global Memory 和快速的 Local Memory 之间进行大批量数据的搬运,以掩盖内存访问的延迟。
-
二、 内部三大“生命线”(数据与指令流)
图例中展示了维持AI Core运转的三种关键信号流:
-
指令流(蓝色箭头):从顶部的“算子指令序列”发出,由Scalar单元进行调度和分发。
-
数据流(红色箭头):数据从Local Memory流入计算单元进行消费,并将结果写回Local Memory。
-
同步信号(黄色箭头):由Scalar单元发出,用于协调DMA搬运单元与计算单元之间的先后顺序(例如:必须等数据搬入完成后,才能通知Vector单元开始计算)。
三、 逻辑执行顺序(算子运行过程)
在一个AI Core上执行一个深度学习算子时,其内部逻辑通常遵循以下并行处理流程:
-
指令下发:AI Core 接收算子指令序列,Scalar 计算单元解析指令,进行循环展开和地址计算。
-
数据准备(搬运与计算并行)
:
-
Scalar 单元发出指令,DMA 搬运单元开始工作,通过 MTE2 将 Global Memory (DDR) 中的原始数据“搬入”到 Local Memory 中。
-
-
并行计算
:
-
当数据在 Local Memory 中准备就绪后,Scalar 单元发出同步信号,通知 Vector 计算单元和 Cube 计算单元。
-
Vector 单元从 Local Memory 读取数据,执行向量运算;Cube 单元从 Local Memory 读取数据,执行矩阵运算。
-
-
结果写出:
-
计算完成后,新的数据被写回 Local Memory。
-
最后,DMA 搬运单元再次工作,通过 MTE3 将 Local Memory 中的计算结果“搬出”并写回 Global Memory (DDR) 供后续使用或输出。
-
总结核心思想:Scalar 负责统筹全局,DMA 负责“喂数据”,Vector/Cube 负责“做数学题”,Local Memory 是核心中转站。通过合理的调度和同步,实现“计算与搬运的重叠”,最大化芯片的利用率。
总结:数据指令到达指令集---》标量计算负责地址分发给memory从外部gm拷贝到lc,同时指令分发给v,c。----》v从lc中的UB缓存找数据,c从L1 buffer中找数据。最后从lc到gm
后续ai昇腾处理器使用的架构
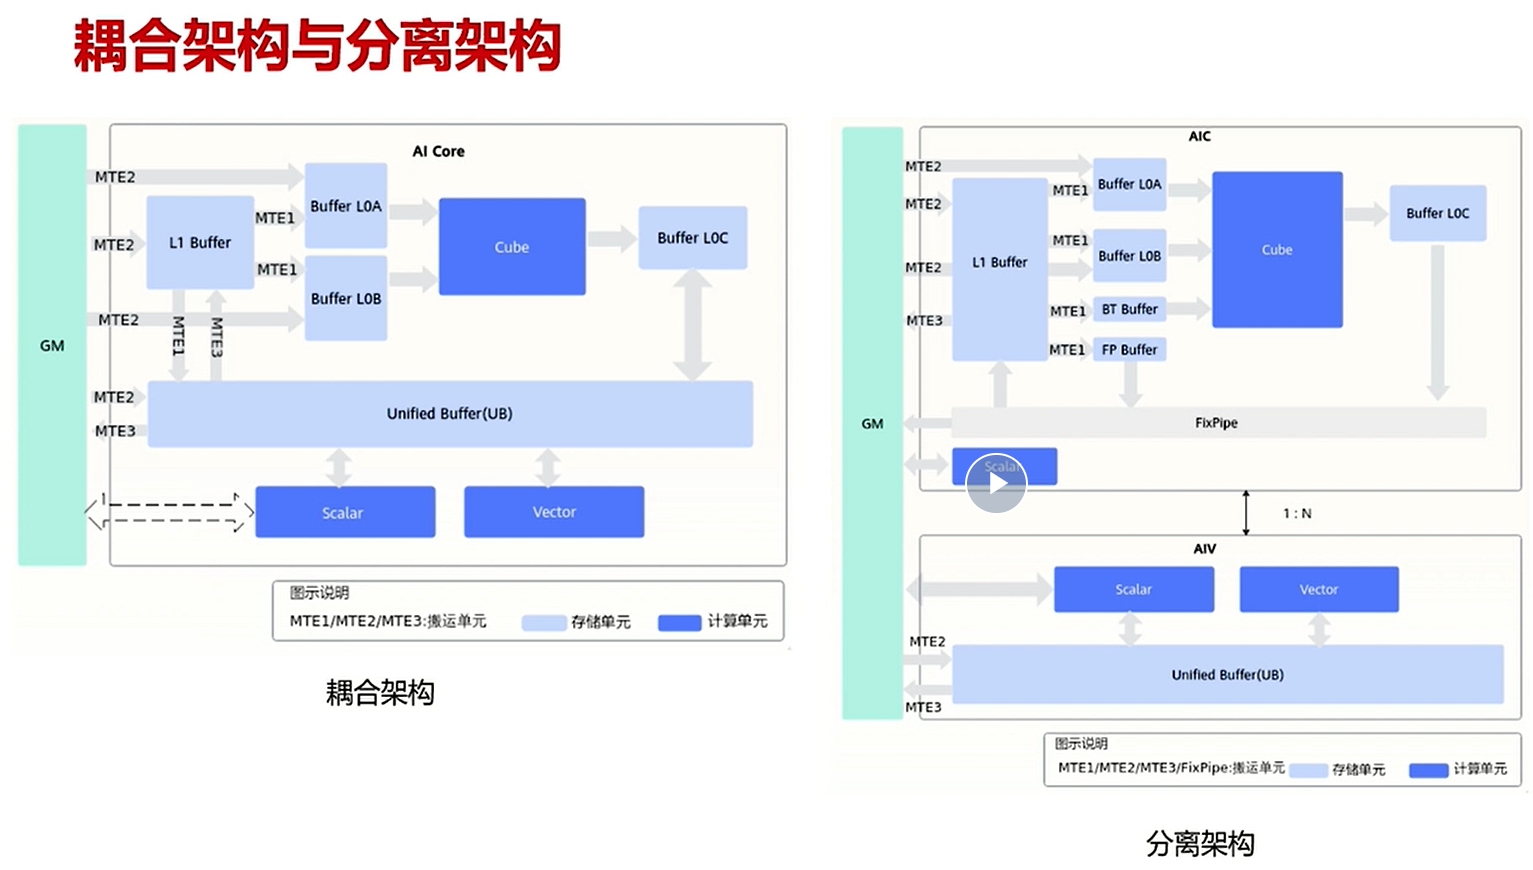
| 名称 | 概念层级 | 主要服务对象 | 物理对应 |
|---|---|---|---|
| Local Memory | 逻辑概念 | 泛指 AI Core 内所有片上缓存 | 包含 UB, L1 Buffer 等 |
| UB | 物理实体 | Vector 和 Scalar 计算单元 | 图1中 AIV 模块内的 "Unified Buffer" |
| L1 Buffer | 物理实体 | Cube 计算单元 | 图1中 AIC 模块内的 "L1 Buffer" |
为什么使用Ascend C语言开发快?
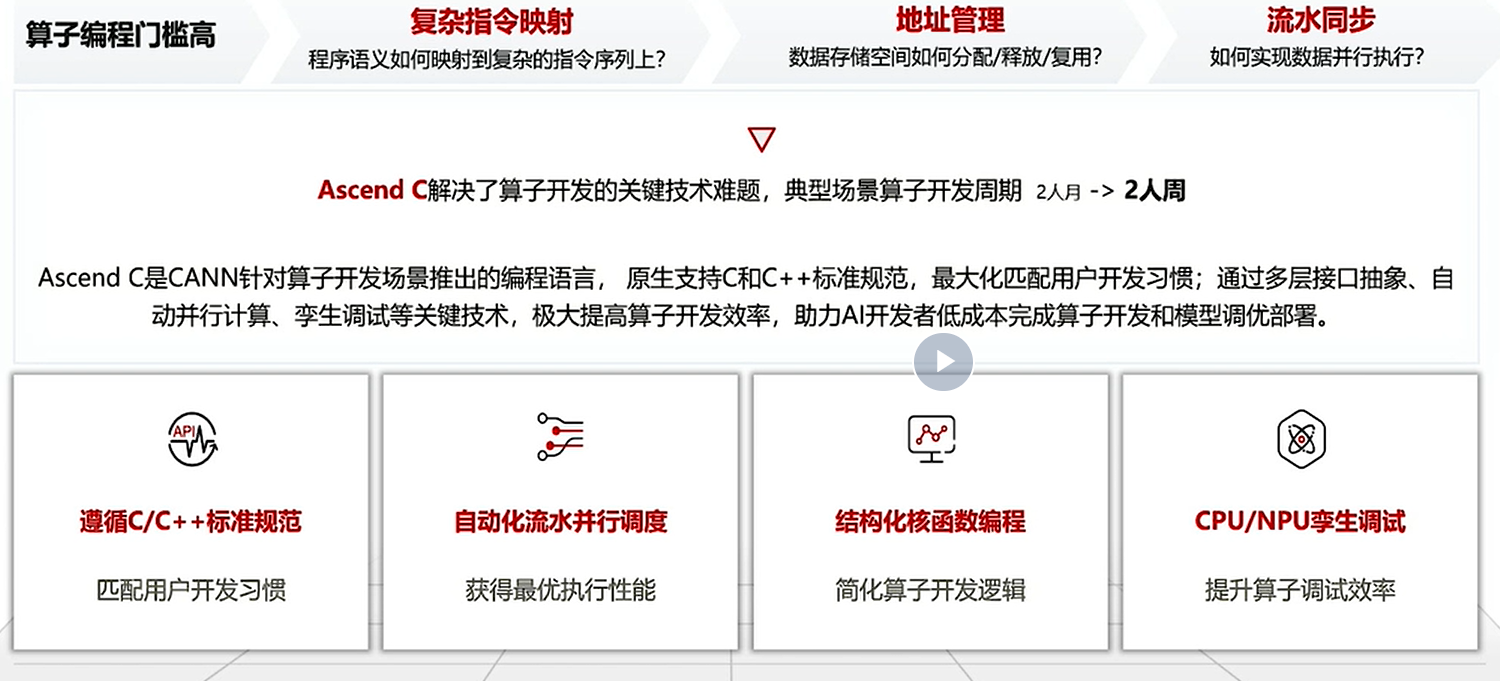
Ascend C可以通过API做张量的计算操作,
AI Core的逻辑架构图

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)