如何看待DeepSeek 开源昇腾基础组件?
想到之前梁文锋讲过TileLang解决的是CUDA卡脖子的问题,之前DeepSeek V3训练的时候用的英伟达的卡和CUDA生态,但这次V4就直接用TileLang生态直接在华为卡上跑,解决了华为卡生态不好的问题,是非常非常大的突破。
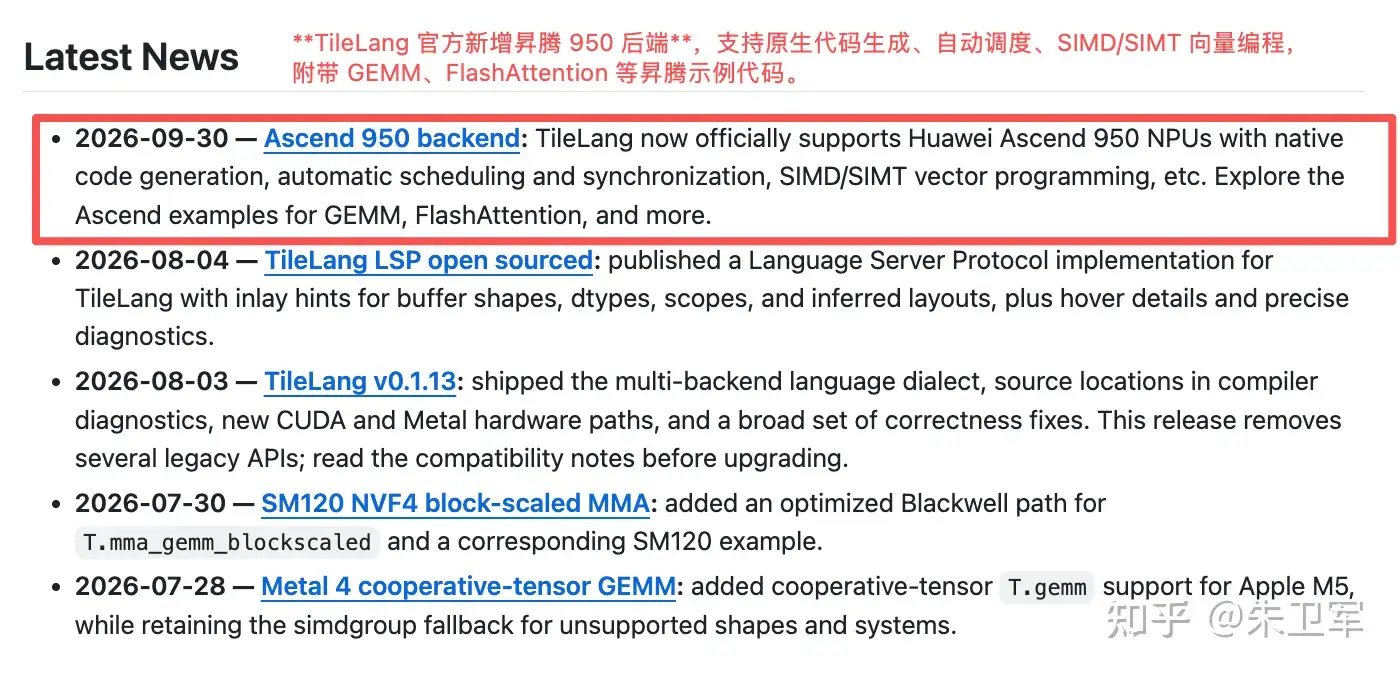
这次开源的最核心组件TileLang for Ascend,等于是给昇腾做了一套对标CUDA的算子开发工具链,以后国产大模型可以直接基于TileLang 在华为卡上跑。
大家离不开英伟达GPU,其实核心之一在于CUDA,它和GPU的关系相当于汽车电控系统和发动机的关系,凡开发AI都要在CUDA上写算子和指令,用它的工具包,而且它不支持AMD、华为的GPU,这就导致你必须用英伟达的卡来跑模型。
后来北大几位研究员开源了tilelang,不光适配各种GPU,还能把CUDA 算子直接移植到昇腾上,可以见当时的论文《TileLang : A Composable Tiled Programming Model for AI Systems》。
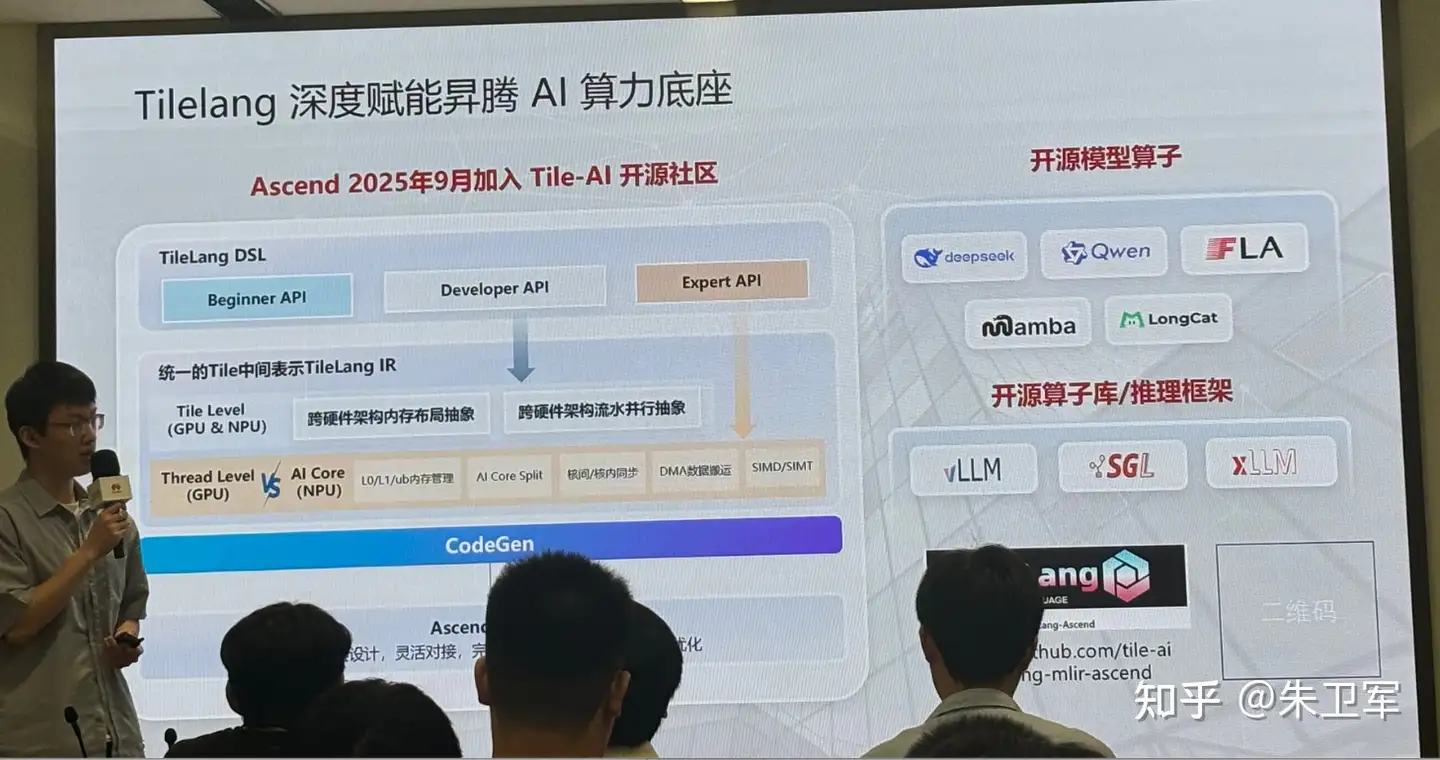
因此,华为在2025年9月开始支持昇腾接入TileLang,从DeepSeek-V3.2-Exp开始用TileLang来训练模型,算是TileLang的重度用户了。
我在2026年华为HC大会上还看到了TileLang核心开发者王磊的讲座,它的三层API分层确实比如CUDA开发简单很多,现在已经支持DeepSeek、Qwen、FLA等开源模型算子,而且基于昇腾NPU做了很多优化,比如编译优化、存储栈。
这次DeepSeek干脆直接开源V4实战的组件,包括DeepGEMM、FlashMLA等整套的算子库,分布式通信组件DeepEP等,等于在TileLang社区基础上开放了一套高级能力,直接把昇腾的TileLang生态提升了一个位次。
引用DeepSeek官方的话,这次是DeepSeek和华为共同的战果,非常直接肯定。
在面向昇腾平台的研发过程中,华为团队给予了毫无保留的大力支持。双方紧密合作,共同推进基于 昇腾 950 的 128 卡超节点方案、共同对计算与通信进行了深度优化。我们将持续推进技术创新,与社区共同建设开放的软件生态、共同进步。
附开源项目链接:
TileLang:
https://github.com/tile-ai/tilelang
DeepGEMM Ascend:
https://github.com/deepseek-ai/DeepGEMM-Ascend
DeepEP Ascend:
https://github.com/deepseek-ai/DeepEP-Ascend
TileKernels:
https://github.com/deepseek-ai/TileKernels
FlashMLA:
https://github.com/deepseek-ai/FlashMLA
DeepSelect:
鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)