DeepSeek 开源昇腾“全套底座“:6 个组件里,真正值钱的是 TileLang 这一层
9 月 30 日,DeepSeek 没发模型,而是开源了一整套面向华为昇腾算力平台的基础设施组件。
海外媒体第一时间把它解读成"中国 AI 往英伟达 CUDA 护城河上砸了一锤"。这话不算错,但太宏观了,落到工程上其实没什么信息量。
我更想聊的是这 6 个组件里的一个:TileLang。因为剩下 5 个都是"把活干了",只有 TileLang 是"把路修了"。
先把事情讲清楚。
一、6 个组件,各管一段
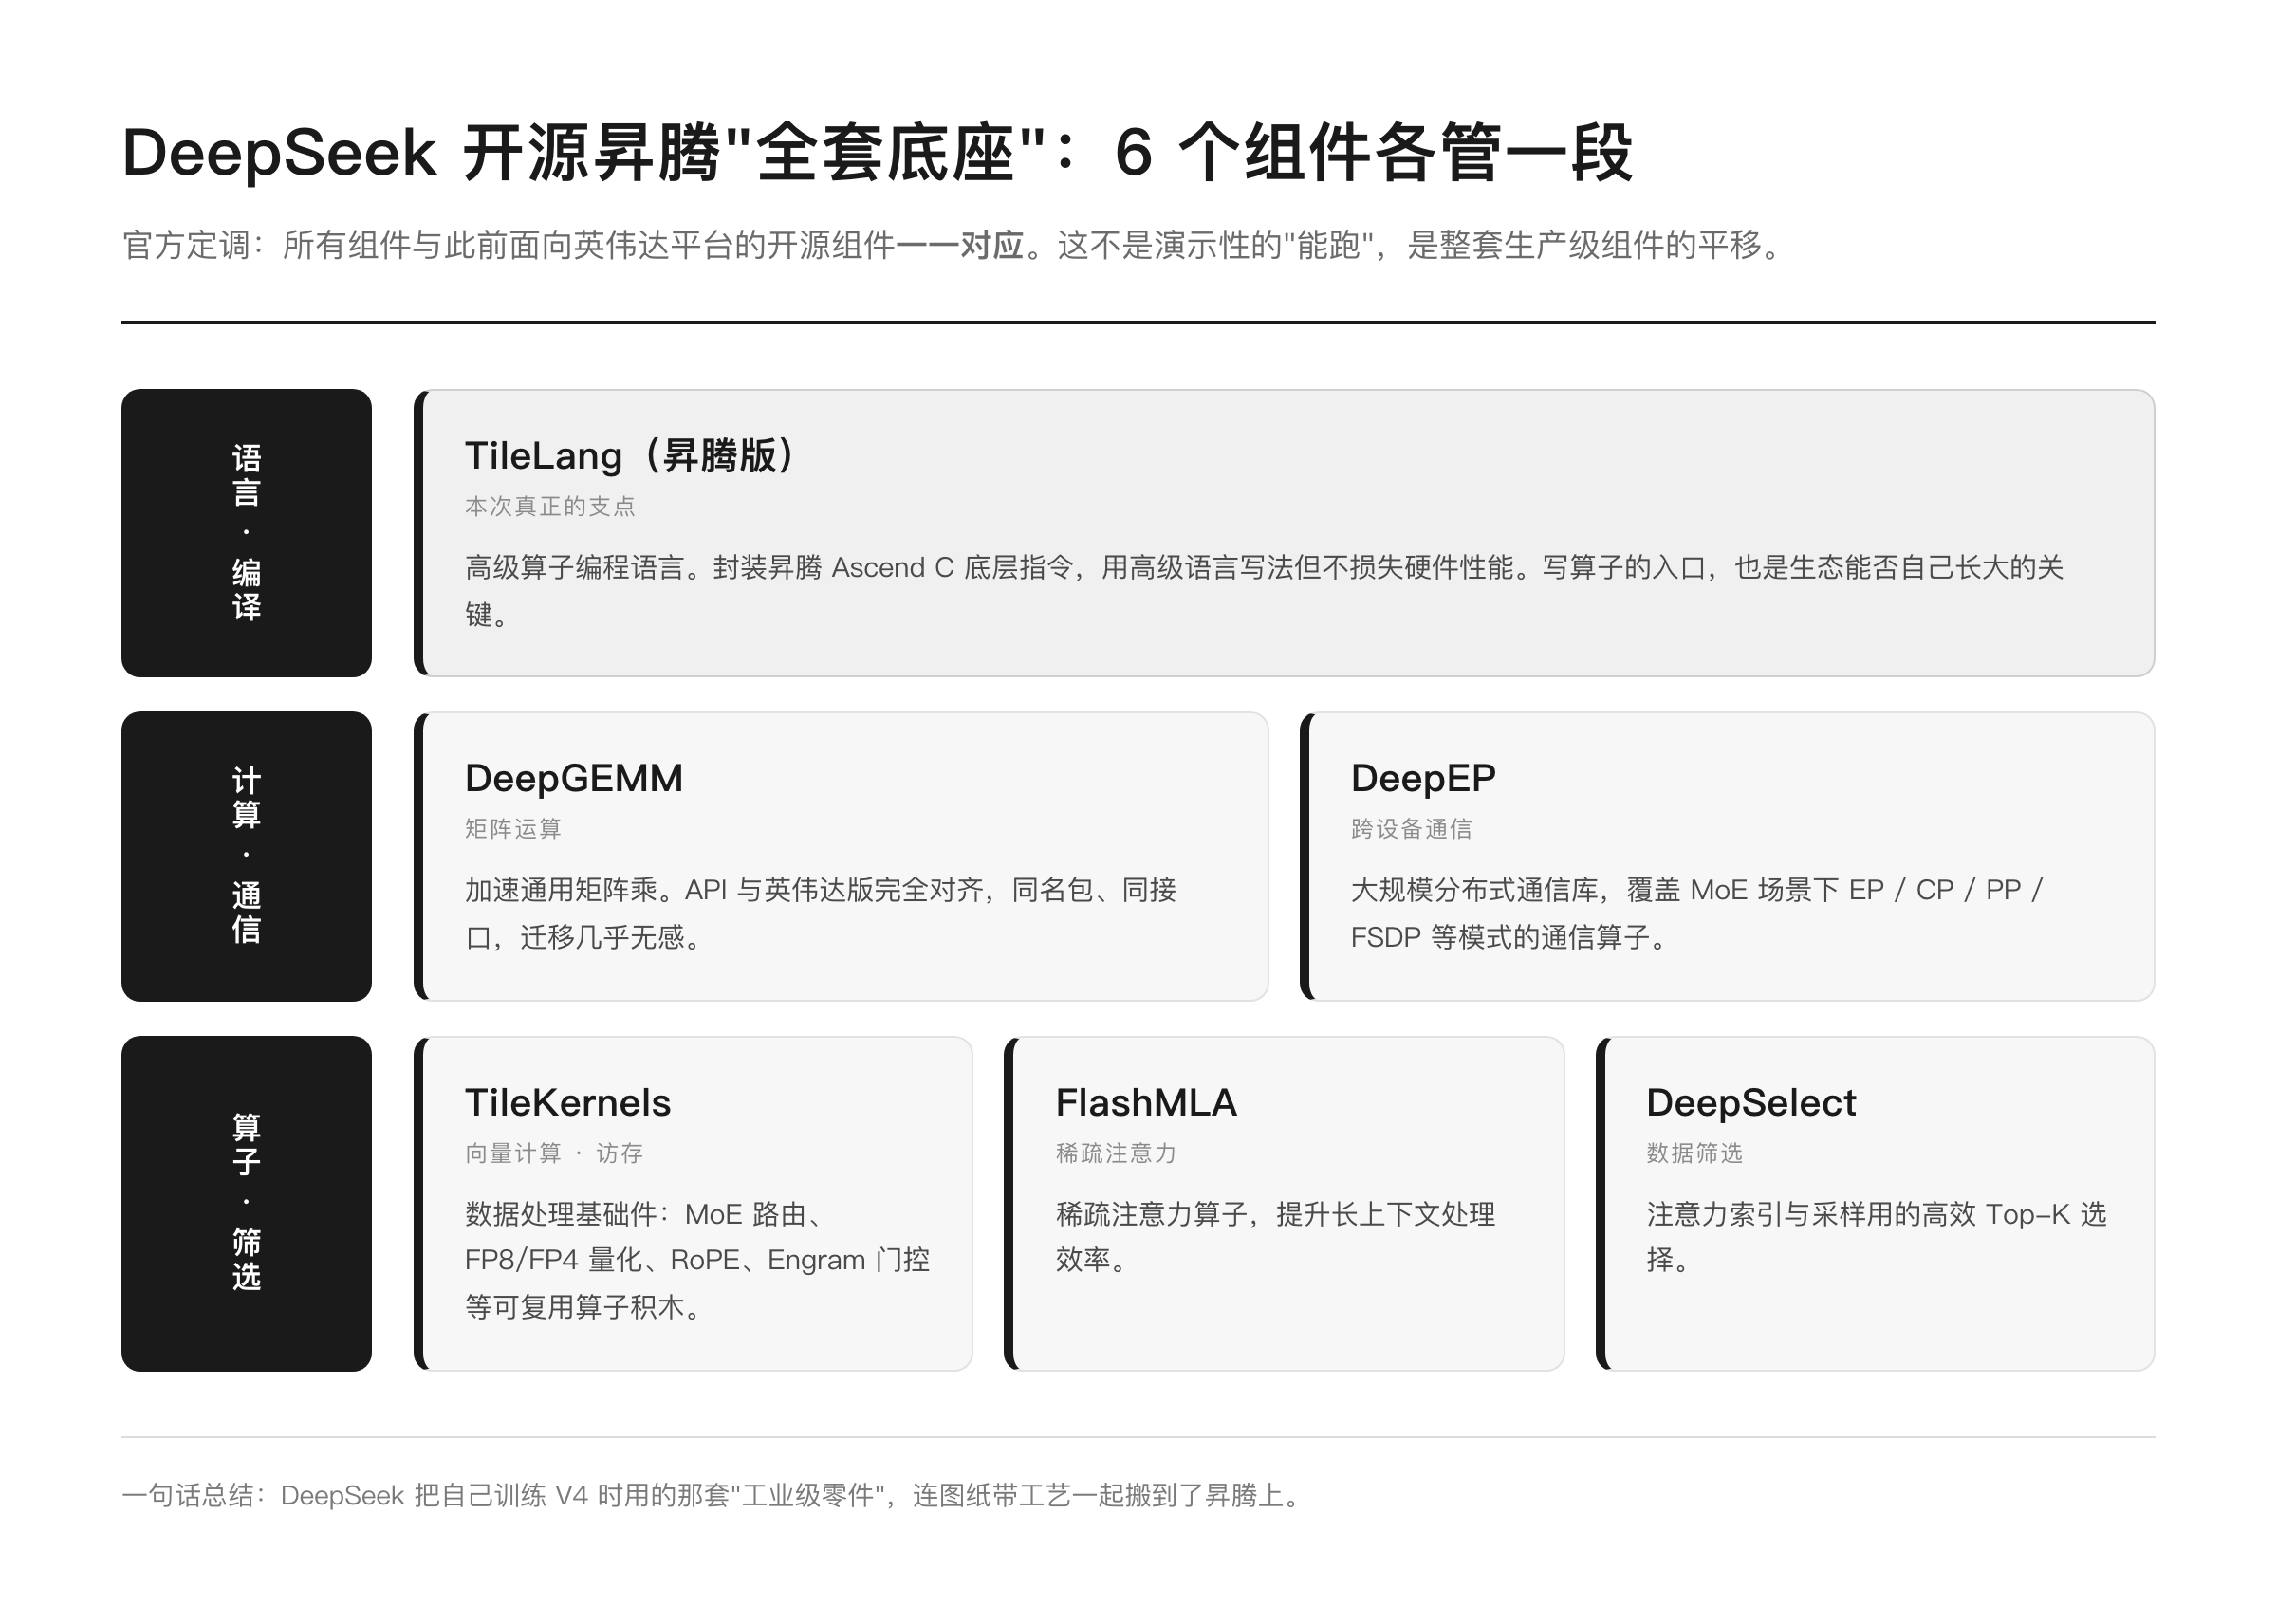
DeepSeek 官方给的定调是"所有组件与此前面向英伟达平台的开源组件一一对应"。翻译一下就是:当年开源周那套家底,原封不动做了一份昇腾版。
| 组件 | 管什么 | 值得注意的点 |
|---|---|---|
| TileLang(昇腾版) | 高级算子语言 + 编译 | 封装昇腾 Ascend C 底层指令,不牺牲性能 |
| DeepGEMM | 通用矩阵运算加速 | API 完全对齐英伟达版,同名包、同接口 |
| DeepEP | 大规模跨设备通信 | 面向 MoE 的 EP / CP / PP / FSDP 通信算子 |
| TileKernels | 向量计算与访存算子 | MoE 路由、FP8/FP4 量化、RoPE、mHC 等"算子积木" |
| FlashMLA | 稀疏注意力算子 | 长上下文场景 |
| DeepSelect | 高效数据筛选 | 注意力索引与采样用的 Top-K 选择 |
一句话总结这 6 个东西的定位:DeepSeek 把自己训练 V4 时用的那一整套"工业级零件",连图纸带工艺一起搬到了昇腾上。
而且 DeepSeek 放了一句很重的话,我建议你逐字读:"目前训练中用到的每一个 TileLang 算子,在昇腾上都有对应的高性能实现。"
这句话的产业含义是——训练一个 DeepSeek 量级的前沿模型,在软件栈层面,不再唯一依赖英伟达。不是"能在昇腾上跑个 demo",是"我训练时用的每个算子都有对应实现"。
二、先澄清一个容易搞错的事:TileLang 不是 DeepSeek 的项目
这一点很多人会误会,包括一些解读文章也没说清。
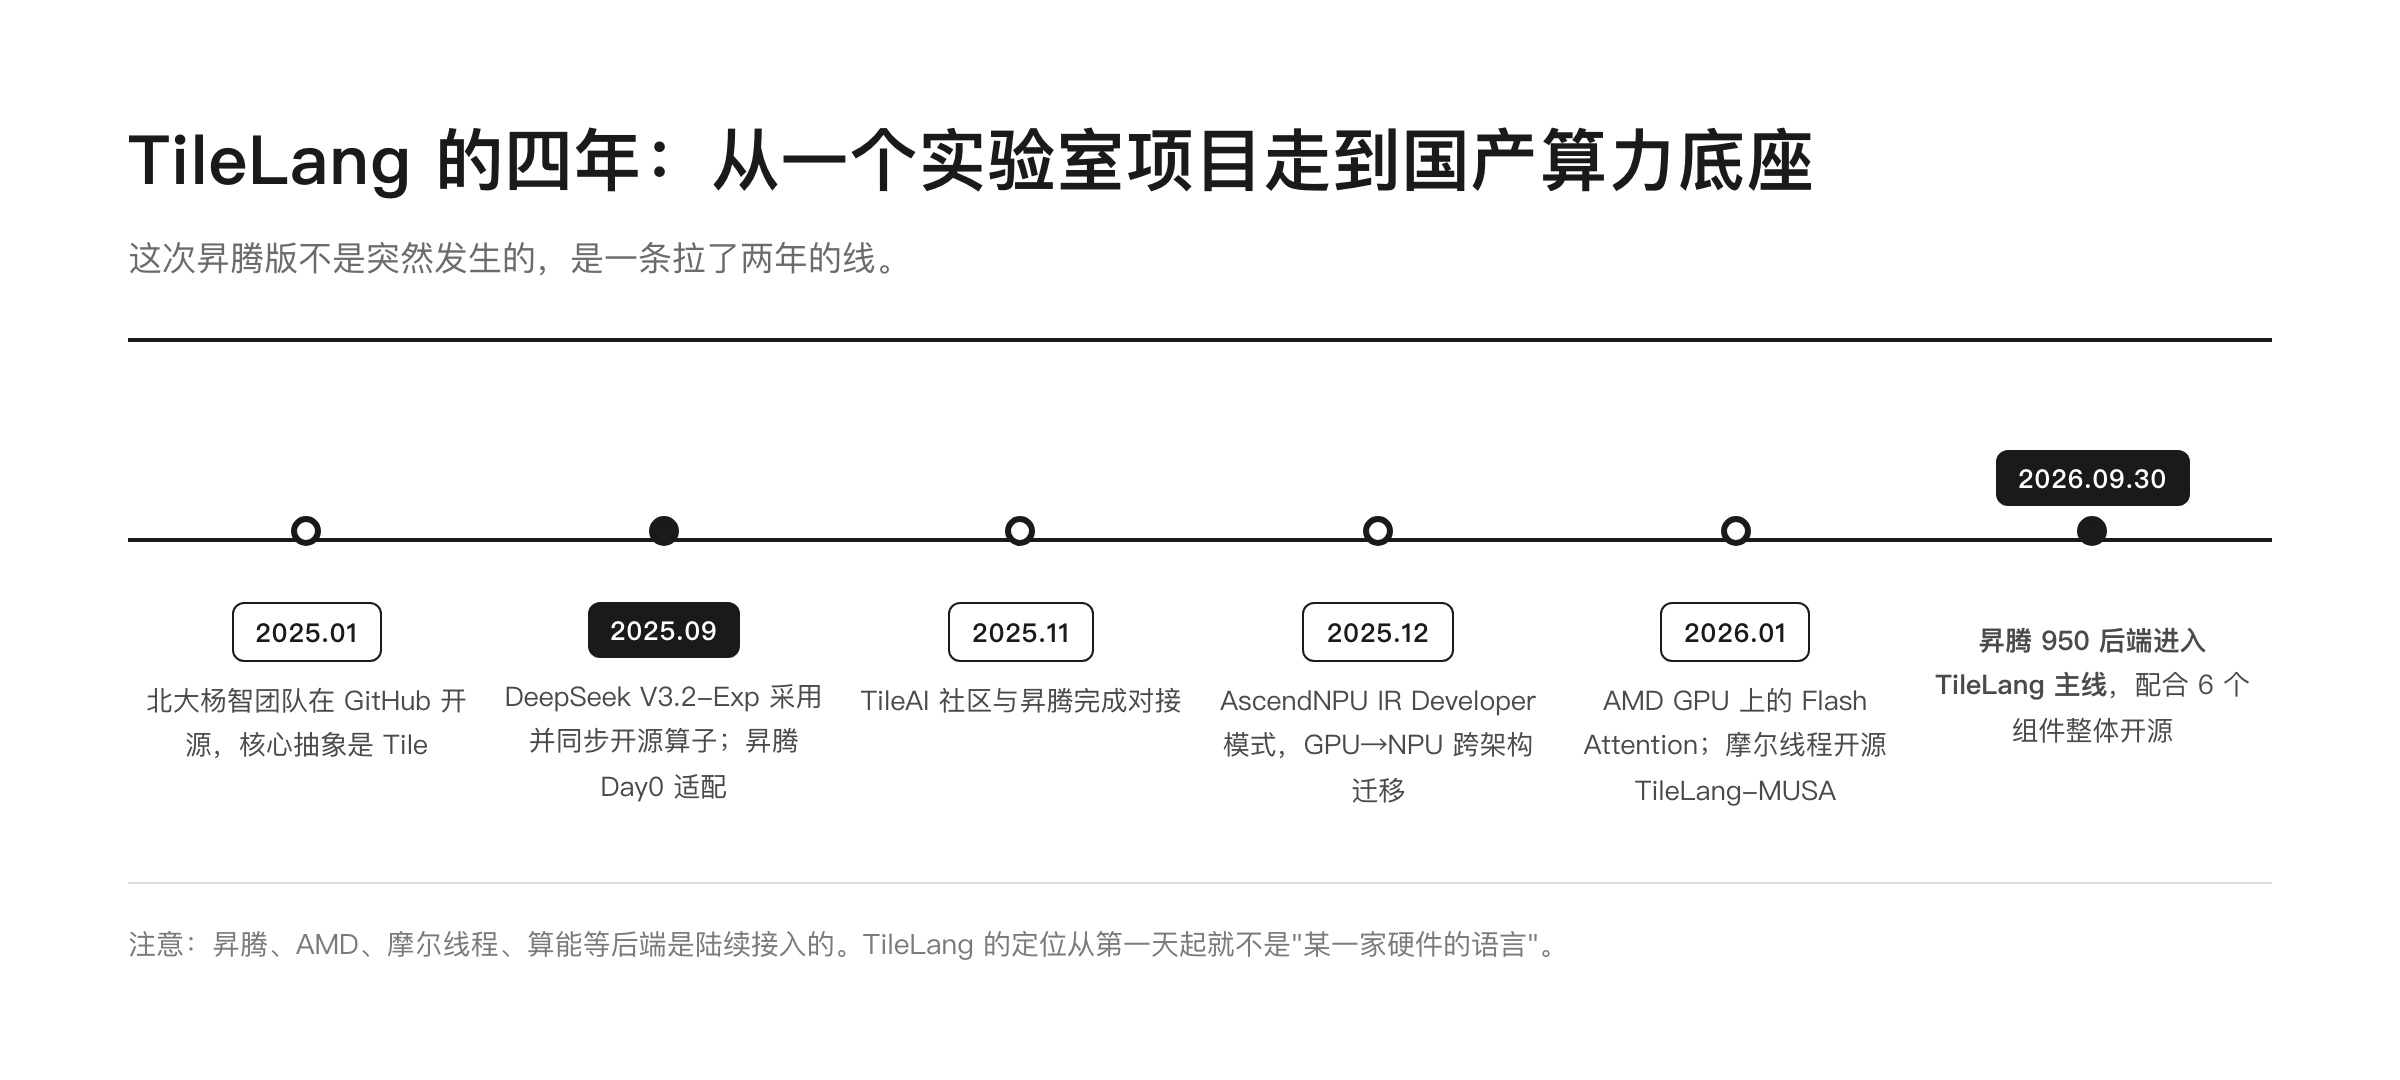
TileLang 的主仓库是 tile-ai/tilelang,由北京大学计算机学院杨智副教授团队主导开发,2025 年 1 月才在 GitHub 正式开源。它的社区叫 TileAI,维护者是一批北大博士和社区开发者。DeepSeek 是深度使用方和共建方,不是所有者。
为什么这件事重要?因为它决定了这个项目的天花板。
如果 TileLang 是某一家公司的私有语言,那它顶多是个"更省事的内部工具"。但它从中立社区长出来,就具备了做硬件中立层的前提。这次昇腾版也一样——代码是提交到 tile-ai/tilelang 主线的(社区里能看到 [Public Release 9/30] Introduce Ascend 950 backend 这样的提交),不是 DeepSeek 自己开个分支关起门来改。
这也是我在过去这一年里,看到 DeepSeek 做的所有技术决策中最"不像中国公司"的一步——它没有在自己主场里再造一个轮子,而是去扶一个已经存在的中立项目。
三、TileLang 到底抽象掉了什么
大模型算子开发长期是个两难:
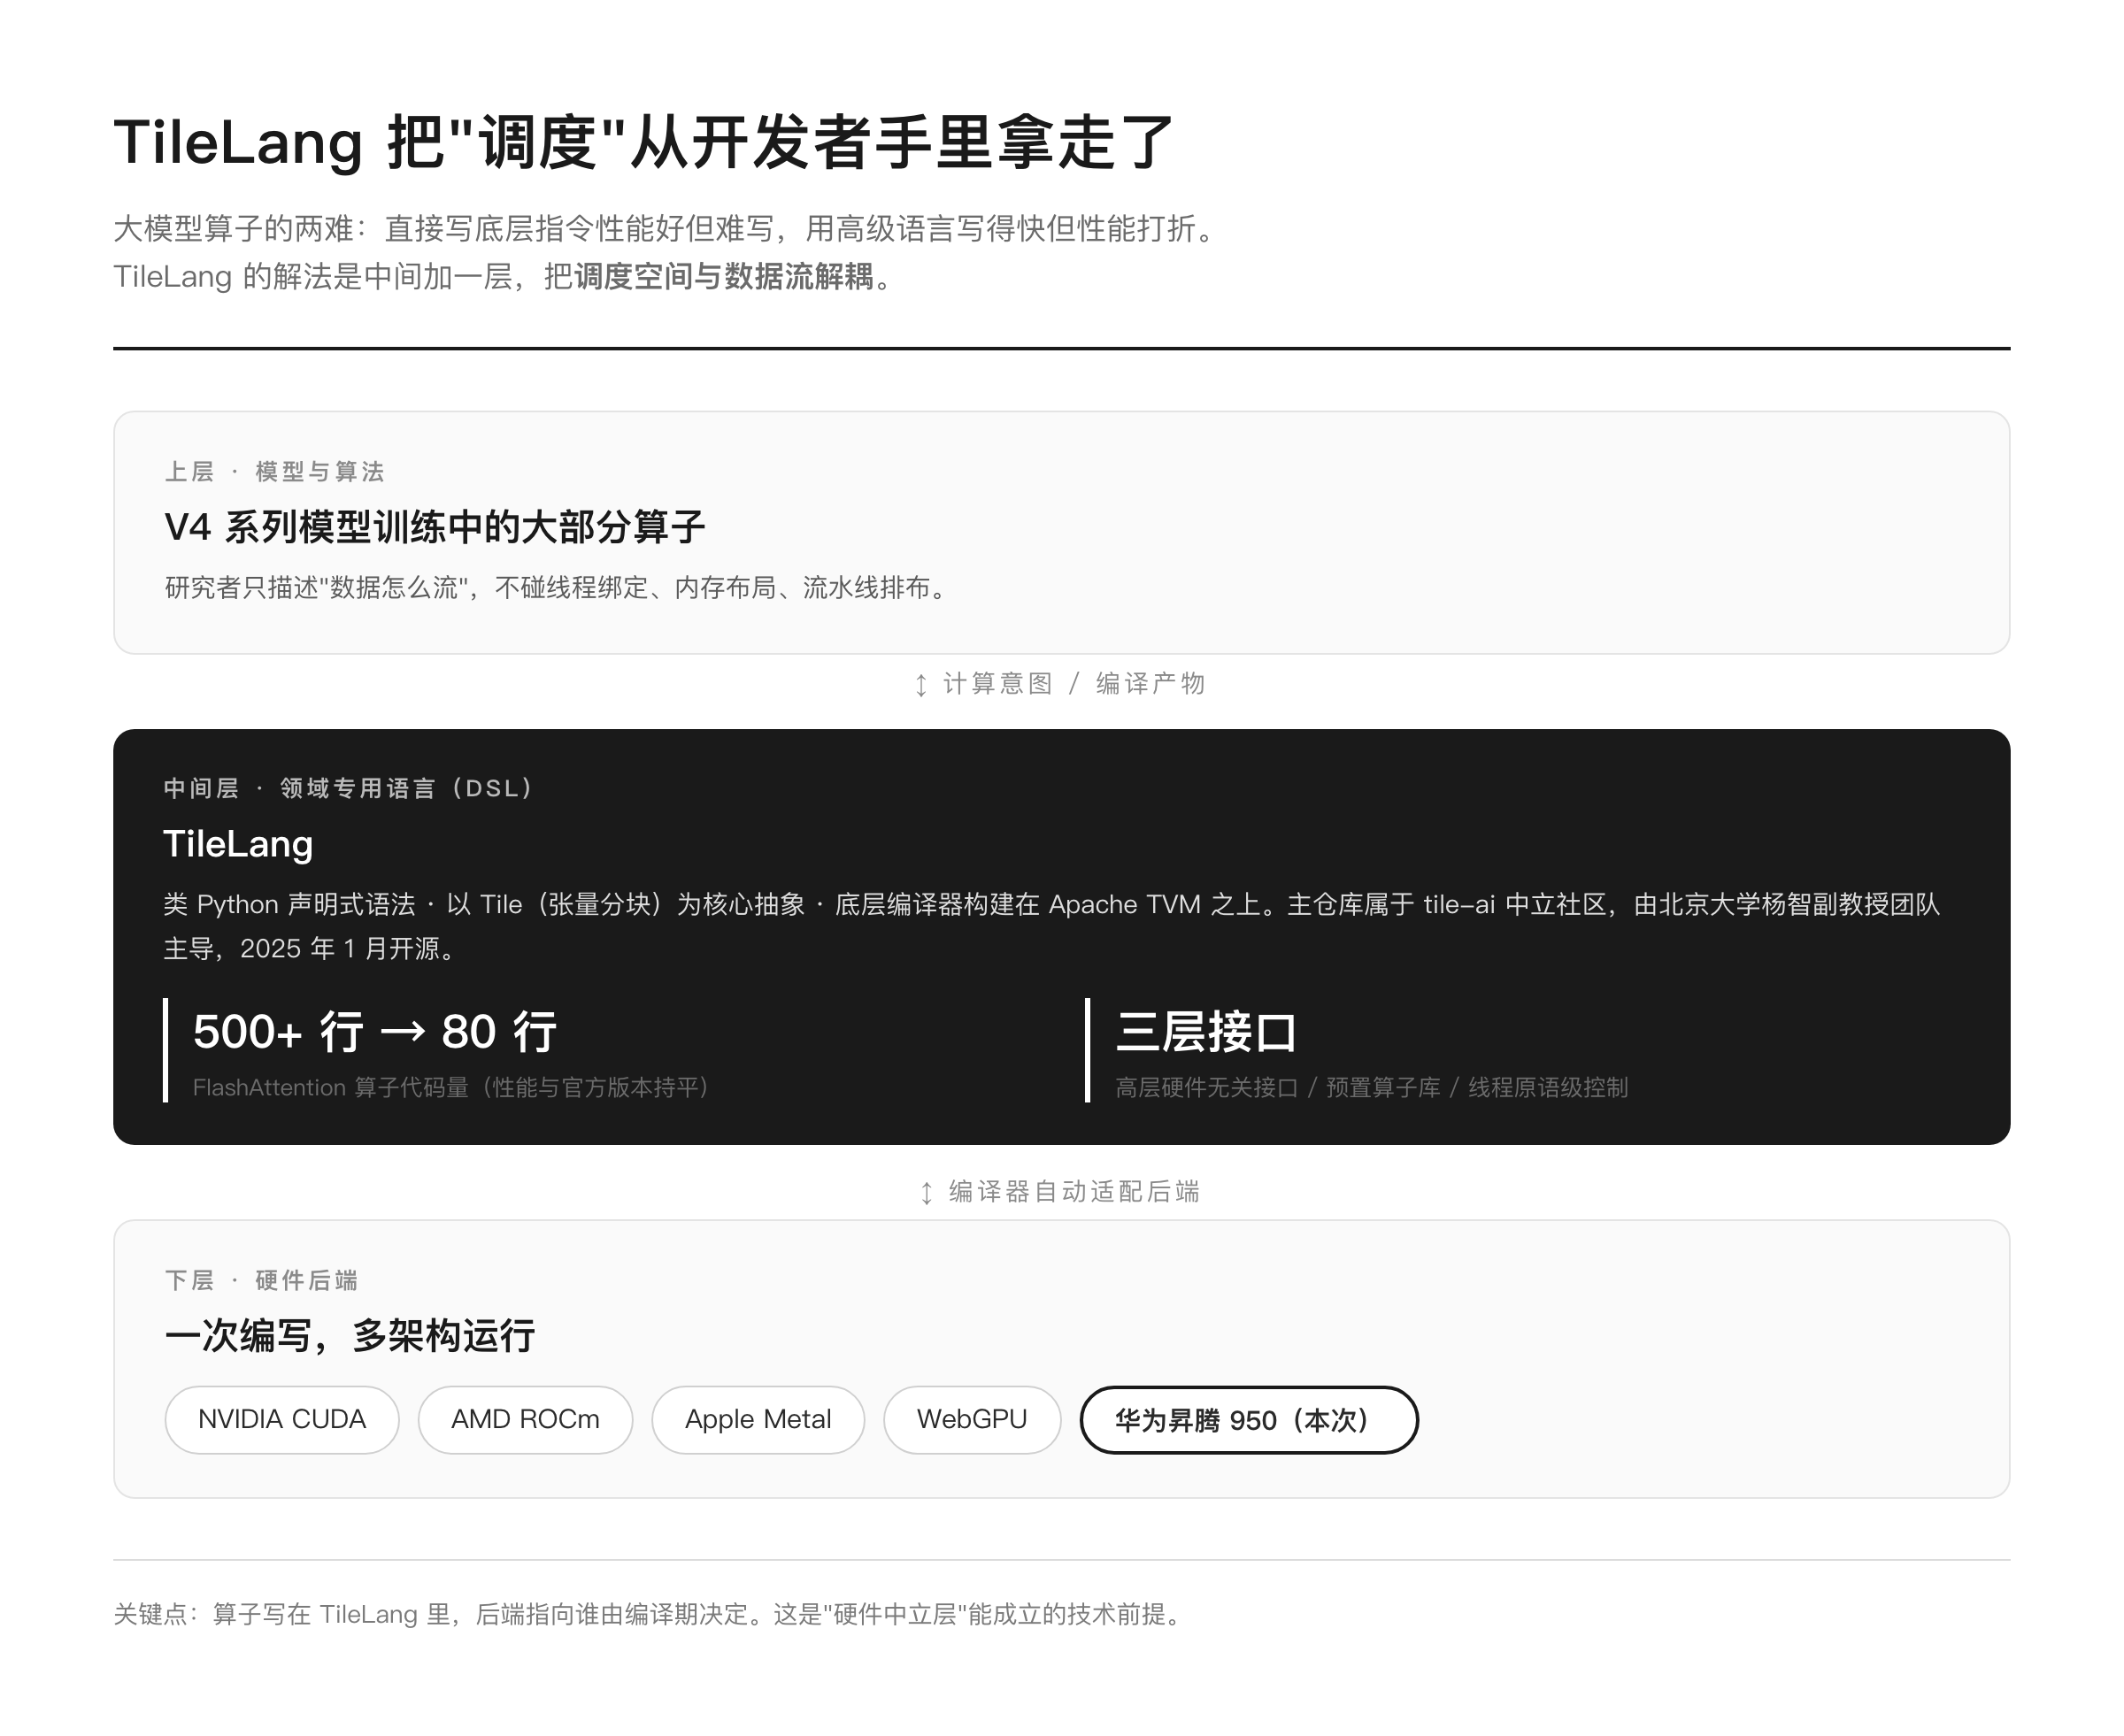
直接写底层指令(CUDA,或昇腾的 Ascend C),性能最好,但难写、难调、难维护。一个 FlashAttention 的官方 CUDA 实现,500 多行代码,里面全是线程绑定、数据复用、同步这些调度细节。
用高级语言写,写得快,性能打折。
TileLang 的解法是在中间加一层。它把调度空间和数据流解耦:你只描述"数据怎么流",编译器负责"线程怎么绑、内存怎么布局、流水线怎么排"。
核心概念是 Tile(张量分块)——显式地让你控制数据在全局内存、共享内存、寄存器之间的流动。语法是 Python 式的声明式,写起来接近数学公式。底层编译器构建在 Apache TVM 之上。
实测案例很直观:同样实现 FlashAttention 算子,代码量从 500+ 行压到 80 行左右,性能与官方版本持平。在 AMD GPU 上做 Flash Attention,延迟做到 PyTorch 实现的约 37%,代码量同样从 500 多行缩到 80 行以内。
而且它给了三层接口:新手用硬件无关的高层接口,熟手用预置算子库,专家直接用线程原语。这个分层设计是它能在工业界活下来的关键——DeepSeek 这种"追求极致性能的专家用户",早期用它快速做原型,后期再下沉到更底层优化。
四、从门户时代看这件事:中立层从来都是权力的转移点
干我们这行时间长的,对"中间层"这三个字应该有肌肉记忆。
广告时代最有价值的不是哪家 DSP,而是那套统一的投放接口。谁定接口,谁就定规则,剩下的玩家只需要实现适配层。后来云服务打仗,打的也不是机器本身,是 API 和 SDK 的兼容性。
放到芯片上,逻辑一模一样。
CUDA 的护城河从来不是"CUDA 这门语言",而是它背后二十年积累的算子库、调试工具、文档,以及数百万习惯了它的开发者。硬件参数谁都能追,开发者习惯追不了。
那怎么破?不在 CUDA 的主场跟它比谁更 CUDA,往上走一层,做一个硬件中立的算子语言。
算子写在 TileLang 里,后端可以指向英伟达,可以指向昇腾,也可以指向任何愿意实现编译后端的芯片。目前 TileLang 的后端已经覆盖 NVIDIA CUDA、AMD ROCm、Apple Metal、WebGPU,加上这次的昇腾 950。
这条路一旦成立,国产芯片第一次有机会拥有跨芯片共享的算子生态——芯片厂只需要提供编译后端和底层指令接口,上层算子生态可以复用。碎片化这个老问题,才真正有了技术解。
已有先例:摩尔线程年初开源了 TileLang-MUSA,代码量较手写 MUSA C++ 减少约 90%;算能的 TPU 通过高校合作接入了 TileLang;微软的 BitNet 量化算子和 BitBLAS 也是基于 TileLang 开发的。
这已经不是"某一家的适配"了,是一个在成形的生态位。
五、把数字摊开看,但要看口径
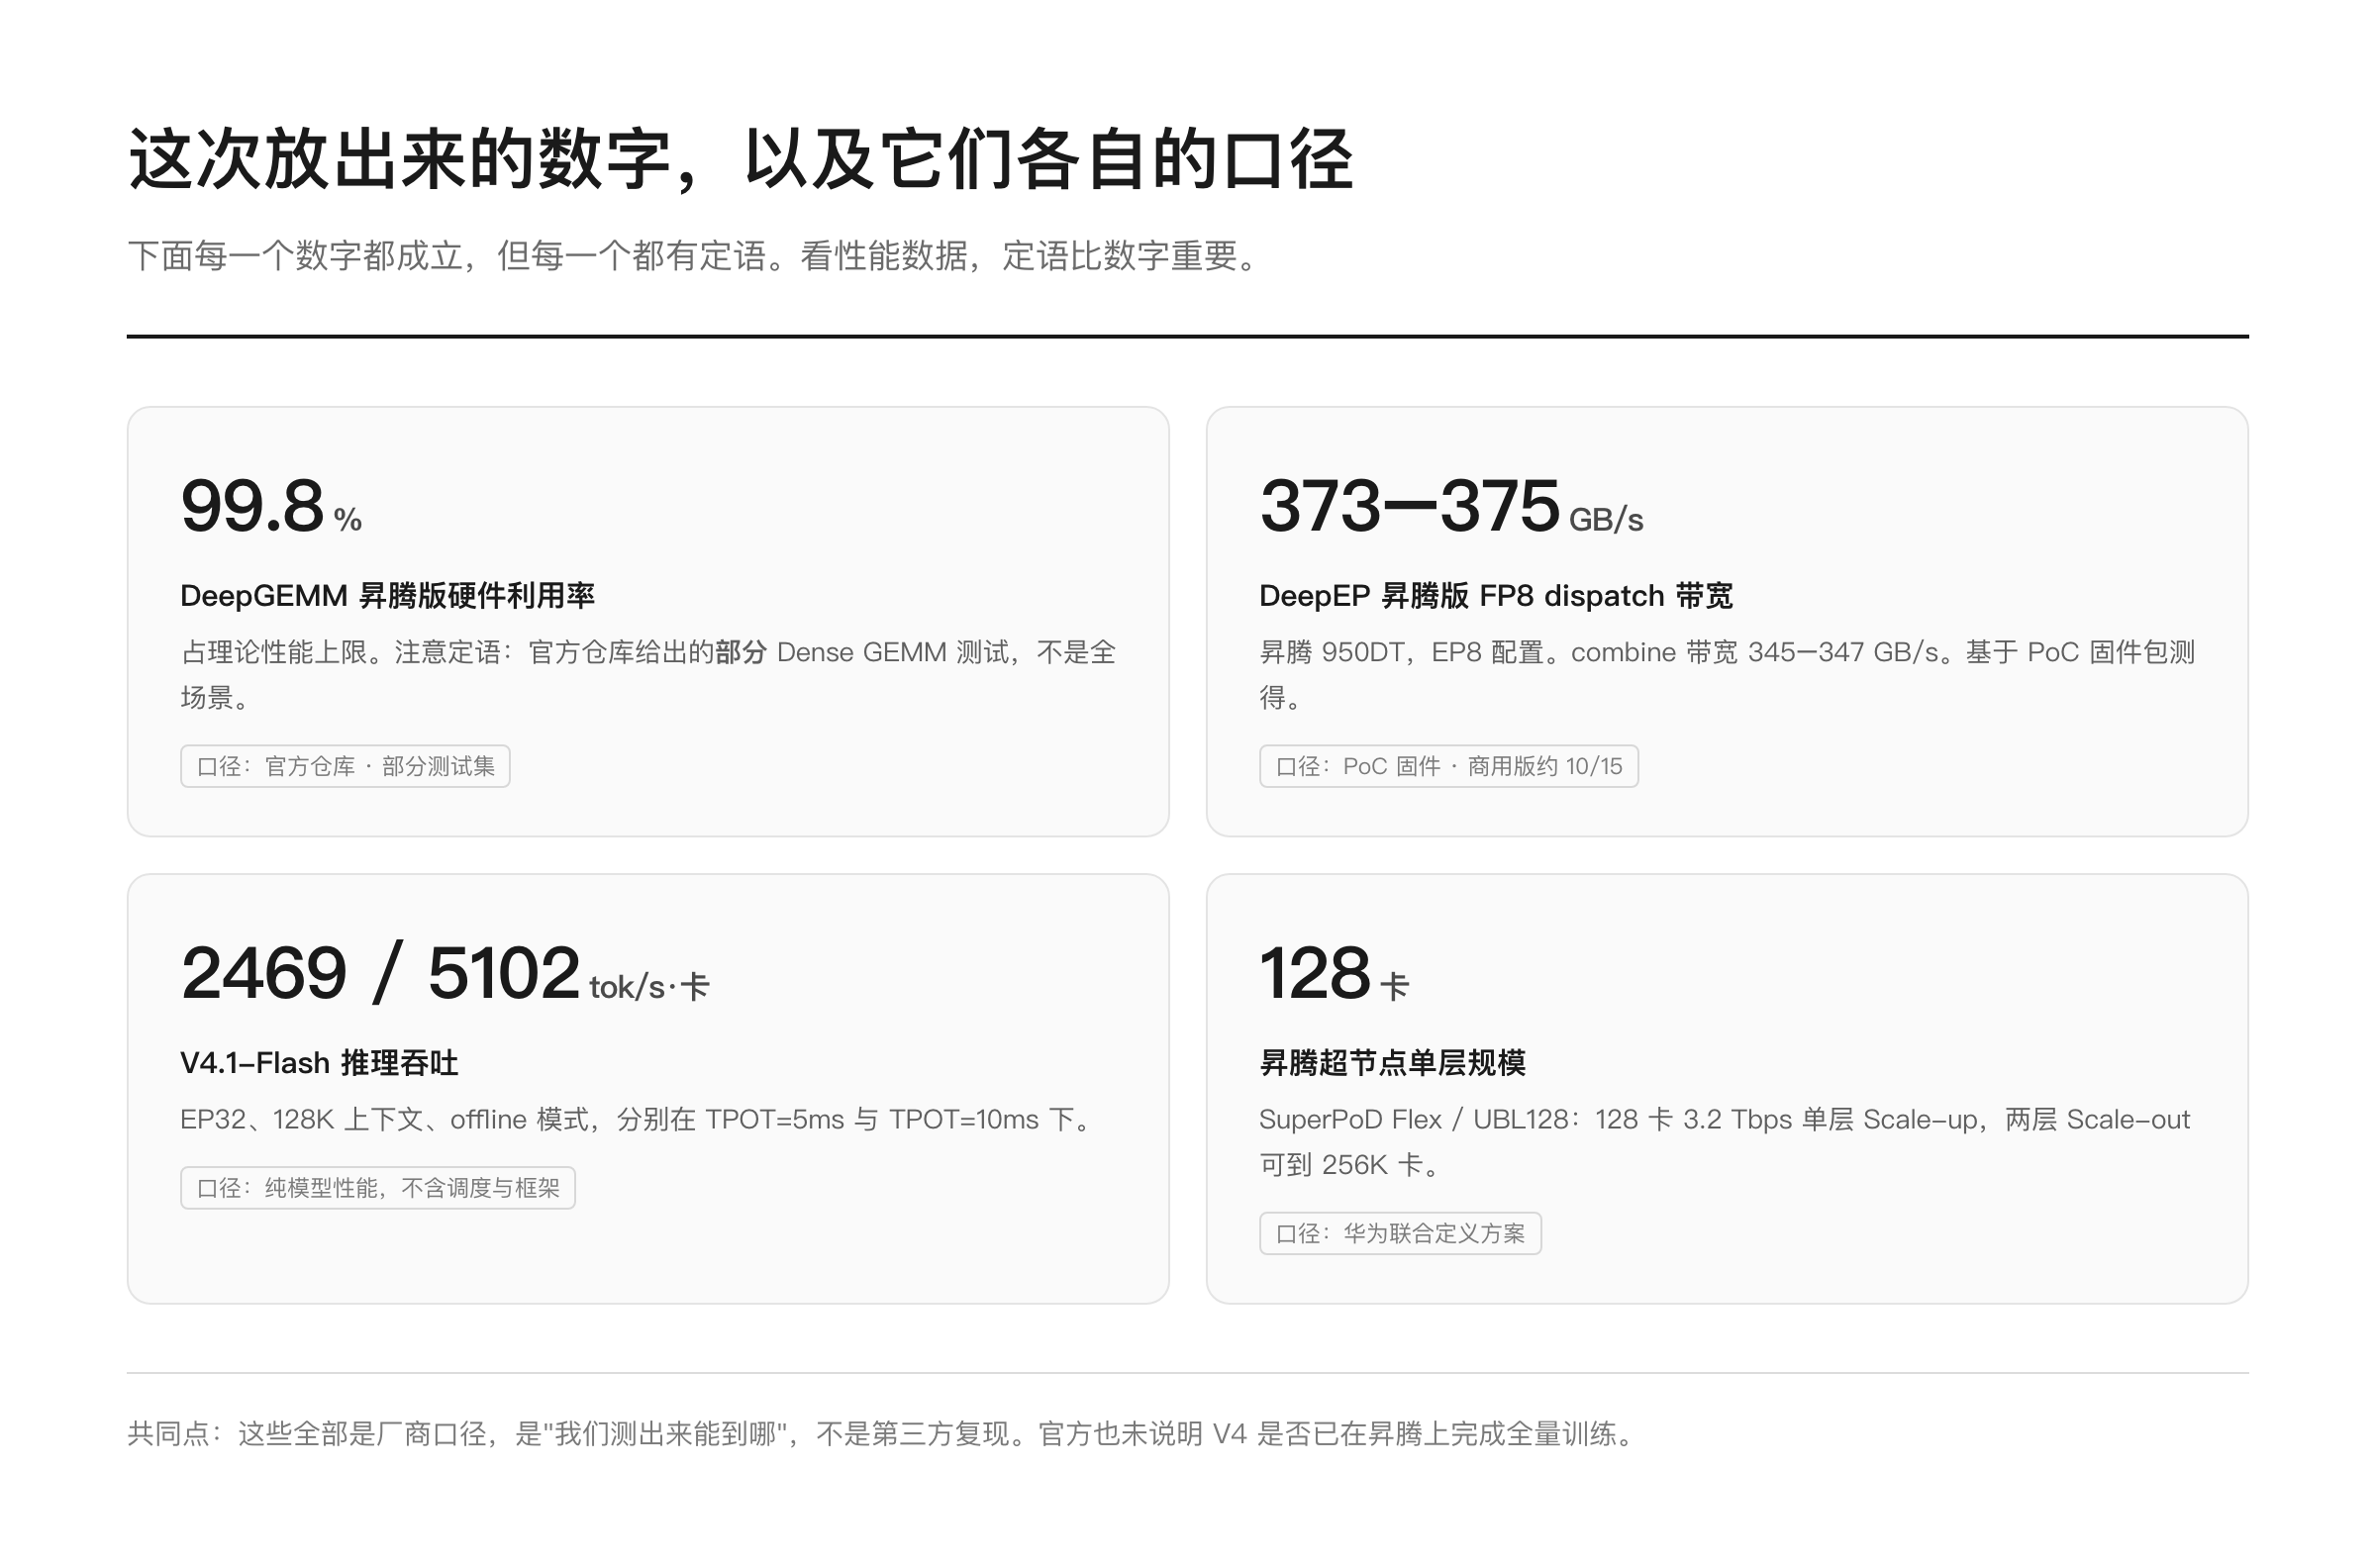
这次官方和合作方放出来的性能数字不少,我挑几个有信息量的,顺便标注口径:
DeepGEMM 昇腾版:官方在仓库里给出的部分 Dense GEMM 测试中,昇腾上的硬件利用率最高达到理论上限的 99.8%。这个数字很炸,但注意定语——"部分测试集",不是全场景。
DeepEP 昇腾版:在昇腾 950DT 上,EP8 配置下 FP8 dispatch 带宽 373~375 GB/s,combine 带宽 345~347 GB/s。这个数字要注意一个细节:官方明确说是基于 PoC 固件包测的,商用版本预计 10 月 15 日左右发布。 这个诚实度值得肯定。
超节点:华为提供了联合定义的 SuperPoD Flex 和 UBL128 组网方案,128 卡实现 3.2 Tbps 单层交换的 Scale-up 网络,两层交换的 Scale-out 网络可以做到 256K 卡。
推理吞吐:EP32 部署、128K 上下文、offline 模式下,DeepSeek-V4.1-Flash 在 TPOT=5ms 时每卡输出 2469 tokens/s,TPOT=10ms 时每卡 5102 tokens/s。口径是"不带框架的纯模型性能",不含服务调度和框架负载均衡。
华为还把这些联合成果在 CANN 社区开源了,包括大 EP 低延时推理部署、单卡/单机部署、大规模训练、超长文本 KV cache 池化、Agentic RL 这几套 recipe。
这些数字的共同点是:都是厂商口径,是"我们测出来能到哪",不是第三方复现。 看的时候把这句话挂在心上。
六、冷静一下:这次开源没解决的问题
捧完之后得说说没解决的部分,不然就是给厂商写软文了。
第一,官方没说 V4 已经在昇腾上完成全量训练。 通稿里讲的是"有对应实现""接近硬件上限",是能力声明,不是结果声明。这两件事之间有距离。
第二,PoC 固件和商用版本之间还有一段路。 DeepEP 那个 10 月 15 日的时间点就是个提醒——现在测出来的数字,跑在临时的固件包上。
第三,从"可用"到"好用"再到"开发者主动选择",中间隔的是社区运营。 这是最慢的一环,也是最难的一环。CUDA 的双向飞轮转了十几年,几百万开发者的肌肉记忆不是靠一次开源发布会能改的。工具链的成熟度、踩坑时的搜索结果、Stack Overflow 上有没有人回答过你的问题——这些东西才是真正的门槛。
第四,软件优化逼近硬件上限,不等于硬件上限被抬高。 软件能把现有的卡榨得更干,但下一代的算力天花板还是得靠芯片本身迭代。
第五,单卡差距还在。 之前就有公开报道提到,梁文锋在投资人场合表达过类似判断:短期内国产芯片单卡性能仍有差距,但"能拿到"比"跑分高"更重要。这个逻辑成立,但它是一句战略判断,不是性能结论。我没有看到官方对具体倍数的正式表述,所以这里不引用任何具体倍率。
七、如果你是干活的,这套东西怎么用
说点落地的。
如果你在做国产芯片适配:别急着自己从零造一套 DSL。芯片厂提供编译后端和底层指令接口,上层接 TileLang,可能是比自己造轮子更快的路径。这次昇腾版就是范本——封装 Ascend C,复用上层生态。
如果你在做算子开发:TileLang 的性价比在往上走。一套 Python 接口跑 GPU 和 NPU,底层按硬件选实现——TileKernels 就是这么设计的。学一次,多个后端能用,这个账很好算。
如果你在做模型训练平台的选型:关注算子覆盖度,而不是盯着 benchmark 的峰值。DeepSeek 那句"训练中用到的每一个算子都有对应实现",价值远大于任何单个算子的跑分——因为决定你能不能迁过去的,是那块最短的板。
如果你只是想看看风向:这次最值得记的不是 6 个仓库,而是"中立层"这三个字背后的方法论——不在别人的主场比谁更熟,往上走一层,重新定义接口。这个打法在过去二十年里被反复验证过。
八、小结
把这件事压成三句话:
DeepSeek 这次开源的是一整套训练底座,不是单个工具,重点在"一一对应"——迁移成本被当成第一性问题来解决。
TileLang 是这套东西的支点,而且它属于中立社区而非某一家公司,这才是它有机会成为"芯片中立层"的前提。
技术乐观归技术乐观,从可用到好用之间隔着社区运营和硬件迭代两道关,这两关都不快。
最后回到我的老本行。互联网这些年,每一次真正改变格局的动作,都不是"做出了更强的产品",而是"把入口往外挪了一格"。
CUDA 强,不是强在卡,是强在人。这次挪的是人的入口。
鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)