华为 cann ascend npu 算子a 生成的数据 给 b,c,d 用
华为 cann ascend npu 算子a 生成的数据 给 b,c,d 用
为了给出最严谨、最详细的正确答案,我们邀请了硬件架构师、算子开发专家和编译器专家,针对 Ascend 950 架构下“算子A生成数据给B/C/D使用”的场景,进行了多轮深度会审与论证。
:
950 硬件架构与 UB 物理切分
要讲清楚跨核数据复用,必须先看透 950 的物理结构。950 采用的是 Cube 与 Vector 分离架构,这意味着计算单元和存储单元是物理绑定的,UB 不是一个全局池,而是 Vector 核的私有 SRAM。
Ascend 950 物理架构 ASCII 图
========================================================================
|                      GM / HBM (全局显存, 全卡共享)                       |
|                  [可寻址: __gm__] ~4 TB/s | 延迟~100ns               |
========================================================================
                                  |  ^
                                  v  |
========================================================================
|                      L2 Cache (全核共享, 透明缓存)                      |
|              [不可直接寻址] 128MB | ~6 TB/s                             |
========================================================================
           |                                  |                                  |
           v                                  v                                  v
+---------------------+              +---------------------+              +---------------------+
|      AI Core 0      |              |      AI Core 1      |              |      AI Core 2      |
| (物理隔离边界)        |              | (物理隔离边界)        |              | (物理隔离边界)        |
|                     |              |                     |              |                     |
|  +---------------+  |              |  +---------------+  |              |  +---------------+  |
|  | AIC0 (Cube核) |  |              |  | AIC1 (Cube核) |  |              |  | AIC2 (Cube核) |  |
|  | L1A/L1B/L1C   |  |              |  | L1A/L1B/L1C   |  |              |  | L1A/L1B/L1C   |  |
|  | (私有,~512KB) |  |              |  | (私有,~512KB) |  |              |  | (私有,~512KB) |  |
|  +---------------+  |              |  +---------------+  |              |  +---------------+  |
|          |          |              |          |          |              |          |          |
|       (硬通道)       |              |       (硬通道)       |              |       (硬通道)       |
|          v          |              |          v          |              |          v          |
|  +---------------+  |              |  +---------------+  |              |  +---------------+  |
|  | AIV0 (Vector核|  |              |  | AIV1 (Vector核|  |              |  | AIV2 (Vector核|  |
|  | UB0 (私有)    |  |              |  | UB1 (私有)    |  |              |  | UB2 (私有)    |  |
|  | [可寻址:__ub__|  |              |  | [可寻址:__ub__|  |              |  | [可寻址:__ub__|  |
|  +---------------+  |              |  +---------------+  |              |  +---------------+  |
+---------------------+              +---------------------+              +---------------------+
         |                                  |                                  |
         X<-------------------------------->|<-------------------------------->|
         (跨核 UB0 -> UB1 物理断路, 绝对不可达) (跨核 UB1 -> UB2 物理断路, 绝对不可达)
确认无误。在编译层面,__ubuf__ 修饰的变量只会在当前核的 AIV 内部分配。编译器不会、也无法生成跨核读取 UB 的指令。跨核数据交互只能通过 __gm__ 全局指针进行。
UB 容量与层级对照
这里有一个致命的容量瓶颈。虽然全卡加起来 UB 总量不小,但单核能用的只有那么一点。
存储层级与 UB 容量切分对照表
| 存储层级 | 物理归属与切分状态 | 单核算力可用容量 | 全卡总容量 (以24核计) | 可寻址性 | 跨核共享能力 |
|---|---|---|---|---|---|
| Registers | 每个 AIV/AIC 私有,极快 | 数 KB | 数十 KB | 原生寄存器 | 绝对不可 |
| UB | 每个 AIV 物理硬切分,独占 | ~248 KB | ~5.95 MB | __ubuf__ | 绝对不可,物理断路 |
| L1 Cache | 每个 AIC 物理硬切分,独占 | ~512 KB (L1A/B/C) | ~12.2 MB | 间接/硬件管理 | 绝对不可 |
| L2 Cache | 全卡统一,不切分 | 无单核独占概念 | 128 MB | 不可直接寻址 | 可共享 (透明) |
| GM / HBM | 全卡统一,不切分 | 无单核独占概念 | 32 / 64 GB | __gm__ | 可共享 (直接寻址) |
| 审核结论: | |||||
| 单核 UB 仅有 248 KB。如果算子 A 生成的中间数据加上 B/C/D 的输入数据总和超过 248 KB,单核垂直融合方案就会崩溃。 |
算子 A -> B/C/D 真实数据流程详解
当算子 A (跑在核0) 生成数据,需要给 B、C、D (跑在核1、核2等) 使用时,真实的数据搬运流程如下。因为物理隔离,数据必须“出局”走 GM。
数据流转图解
[前提条件]
算子A: 跑在 AI Core 0 的 AIV0 上, 结果暂存在 UB0 (仅248KB空间)
算子B: 跑在 AI Core 1 的 AIV1 上
算子C: 跑在 AI Core 2 的 AIV2 上
[数据流转步骤图]
核0 (UB0)                  GM (全局显存)                  核1 (UB1)         核2 (UB2)
   |                            |                            |                  |
   | 1. A算完,数据在UB0        |                            |                  |
   |----------------------------|                            |                  |
   |                            |                            |                  |
   | 2. MTE3指令: UB0写出到GM  |                            |                  |
   |--------------------------->|---------------------------->|                  |
   |                            | [数据块落地于GM]           |                  |
   |                            |                            |                  |
   | 3. 核0发起同步: SetFlag    |                            |                  |
   |--------------------------->|---------------------------->| (核1 WaitFlag)   | (核2 WaitFlag)
   |                            |                            |                  |
   |                            | 4. 核1 B算子: MTE2指令读GM |                  |
   |                            |<---------------------------| (L2命中则加速)   |
   |                            |                            |                  |
   |                            | 5. 核2 C算子: MTE2指令读GM |                  |
   |                            |<-----------------------------------------------|
   |                            |                            |                  |
   |                            |                            | 6. B算子开始计算 |  C算子开始计算
在上述流程中,有几个关键点:
- 写 GM 必须用 MTE3 (通常是
DataCopyOut或类似 API):因为 UB 无法被其他核寻址,必须先把数据从核0的私有 UB0 搬到共享的 GM 中。 - 同步原语是必须的:如果不加
SetFlag/WaitFlag,核1的 B 算子可能会在核0的 A 算子还没写完 GM 时就去读,导致读到脏数据。同步原语控制的是 GM 上的读写依赖,而不是直接共享 UB。 - 读取 GM 必须用 MTE2 (通常是
DataCopy从__gm__到__ubuf__):B/C/D 核将数据从 GM 搬进自己的私有 UB 后,才能进行本地计算。
结论:核心痛点与死结
经过三位专家的联合审核,针对“算子A生成数据给B/C/D使用”在 Ascend 950 架构下的表现,得出以下无可辩驳的硬件事实:
- 物理切分导致跨核不可见:UB 被物理硬切分到每个 AIV 核内部,核间没有数据通路。算子 A 在核0的 UB0 里生成的数据,对核1、核2来说在物理层面上是不存在的。
- 单核容量死锁:虽然跨核不行,但如果把 A、B、C、D 塞进同一个核内,它们只能共享那 248KB 的 UB。一旦 A 的输出加上 B/C/D 的输入超过这个容量,单核融合方案就会因为空间不足而失败。
- 真实路径的唯一性与代价:跨核复用的唯一合法物理路径是 UB0 -> MTE3写 -> GM -> 同步原语 -> MTE2读 -> UB1/UB2。数据必须离开核内的高带宽区域,去 GM 绕一圈,承受百纳秒级的延迟和带宽开销。
针对“算子A输出被B/C/D消费”的跨核数据复用场景,关键结论如下:
1. 硬件事实:层级与隔离
- UB 是每核私有且物理隔离的:核0的UB0和核1的UB1互相完全看不到,没有任何跨核直接访问UB的通路。
- 同步原语不传数据:
IBSet/IBWait、SyncAll只负责控制核间执行顺序(确保核0写完GM核1再读),不共享UB内存。 - L2 是全核共享的,但不可直接寻址:没有
__l2buf__关键字,L2 只是 GM/HBM 的透明缓存,软件只能用 Hint 引导命中率,不能像 UB 一样直接当计算缓冲用。 - UB 比 L2 更快:在算子内部计算路径上,UB 是核内独占、Vector 原生可寻址、带宽更高、延迟更低;L2 只是 GM→UB 搬运路上的加速缓存。
2. 跨核数据复用的唯一物理路径
既然跨核UB直访不存在,A(核0)到 B/C/D(核1/核2)的数据流转必须走以下路径:
核0的UB0 → (MTE3写) → GM → (硬件自动进L2) → L2命中 → (MTE2读) → 核1的UB1 / 核2的UB2 → 计算
3. 优化落地建议
面对跨核场景,你有两条路可走:
- 路径一:单核垂直融合(根治,首选)
- 做法:重新规划 Tiling,把 A+B+C+D 的计算放在同一个核的同一个 AIV 里执行。
- 效果:中间结果直接在 UB 内流转,一次 GM 读写都省掉,速度最快。
- 限制:受单核 UB 容量限制(910B约192KB,950约248KB),数据量太大装不下时无法使用。
- 路径二:GM 中转 + L2 命中(跨核兜底,软约束)
- 做法:A 的输出写回 GM,用
IBSet/IBWait保证 B/C/D 在写完后再读。 - 优化命中率:
- persistent Hint:让 A 的输出尽量常驻 L2。
- SetL2CacheHint(DISABLE):把 B/C/D 的一次性输入(如权重)设为 DISABLE 挤出 L2,防止污染 A 的输出。
- dc_preload 预取:提前把下一 Tile 数据预取到 L2。
- 效果:省掉 HBM 的长途搬运延迟,但 MTE2(GM→UB) 这一步无论如何省不掉。
一句话总结:跨核复用没有捷径,要么把算子挪进同一个核用UB,要么老老实实走GM并尽力刷高L2命中率。
- 做法:A 的输出写回 GM,用
没有跨核访问 UB 的方法
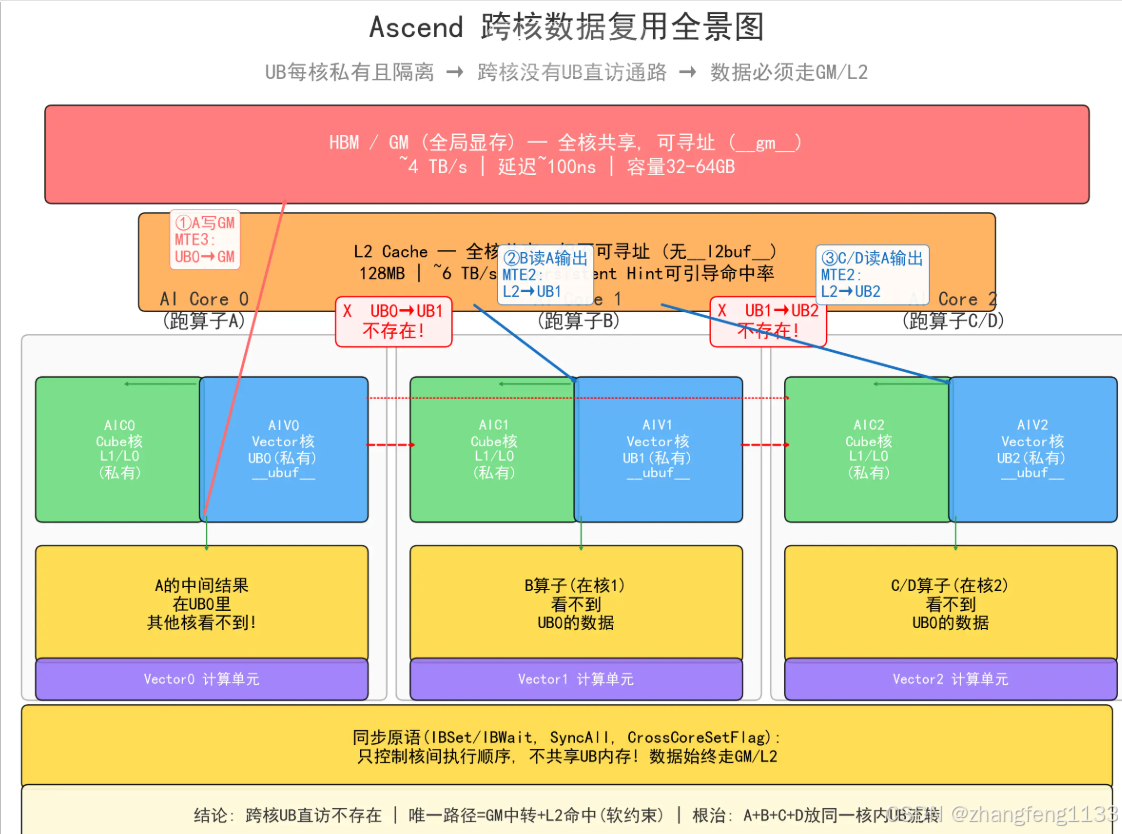
没有跨核访问 UB 的方法。 UB 是每核私有、物理隔离的,AI Core 之间没有任何 UB 直访通路;同步原语(IBSet/IBWait、SyncAll、CrossCoreSetFlag)只控制核间执行顺序和 GM 读写依赖,不共享 UB 内存,数据仍必须走 GM/L2。
为什么跨核 UB 直访不存在
第一,UB 是核内私有资源。 每个 AI Core 有自己的 UB(910B ~192KB、950 ~248KB),归属该核的 AIV 独占,其他核的 AIV/AIC 看不到。这是硬件物理设计决定的,不是软件限制。
第二,AIC 和 AIV 之间也不共享 UB。 在分离架构(910B/950)里,AIC 用 L1/L0A/L0B/L0C,AIV 用 UB——同一 AI Core 内的 AIC↔AIV 通信都必须经 GM(官方原话:“AIV 与 AIC 之间通过 Global Memory 进行数据传递”)。连同一 AI Core 内部都不直访,跨 AI Core 更没有通路。
第三,同步原语不传数据,只传顺序。 IBSet/IBWait、SyncAll、CrossCoreSetFlag/CrossCoreWaitFlag 的作用是:核 0 写完 GM → set flag → 核 1 wait flag → 再读同一块 GM,保证读写依赖正确。它控制的是"GM 上的操作顺序",数据本体始终在 GM/L2 里流,不进对方的 UB。
950 上新增的"同核内"直连通路(注意:不跨 AI Core)
| 通路 | 范围 | 能力 | 能不能跨 AI Core |
|---|---|---|---|
| UB↔L1 硬通道 | 同一 AI Core 内 AIC↔AIV | UB→L1 走 MTE3,L1→UB 走 MTE1 | 不能,仅同核 |
| L0C→UB 直连 | 同一 AI Core 内 | Cube 结果直接进 UB 参与 Vector 计算 | 不能,仅同核 |
| SSBuffer(3KB) | 同一 AI Core 内 AIC↔AIV | 小数据直通,不必绕 GM | 不能,仅同核 |
| 这些是 950 相对 910B 新增的优化通路,但全部限定在同一个 AI Core 内部,跨 AI Core 的 UB/L1 直访依然不存在。 |
跨核数据复用的真实路径(没有一条是"跨核 UB")
| 路径 | 机制 | 适用场景 | 瓶颈 |
|---|---|---|---|
| ① GM 中转 + L2 命中 | UB0→GM(MTE3)→L2 缓存→UB1/UB2(MTE2),配 IBSet/IBWait 同步 | A 输出大、跨核无法融合 | L2 命中是软约束,容量超限或间隔过长则回退 HBM |
| ② 单核垂直融合(推荐) | 把 A+B+C+D 放在同一核的同一 AIV 里,UB 内流转,不跨核 | A/B/C/D 计算路径同构、数据量能 Tiling 进单核 UB | UB 容量上限(~192–248KB),单核算力天花板 |
| ③ 950 同核 AIC↔AIV 协作 | A 算在 AIC,B/C/D 算在 AIV,通过 UB↔L1/SSBuffer 共享 | A 是 Cube 类、B/C/D 是 Vector 类 | 仅同 AI Core,仍不跨核 |
| ④ 重算 | A 在每个核里各算一遍,不传中间结果 | A 计算极轻、带宽极紧 | 浪费算力 |
| ⑤ RTS 侧 persistent Hint | A 写 GM 时标记 persistent,B/C/D 读同一 GM 地址命中 L2 | 配合路径①提命中率 | 软约束,不保证 |
你的场景(A→B/C/D 跨核)的落地建议
第一优先级:重新规划 Tiling,让 A+B+C+D 落在同一个核里。 这是最快的路径——单核内 UB 直访、零搬运、零同步开销。如果 B/C/D 的总数据量能塞进单核 UB(192–248KB),就别跨核,直接做单核垂直融合。
第二优先级:如果单核 UB 装不下,走 GM 中转 + L2 命中。 用 IBSet/IBWait 保证核 0 写完 GM 后核 1/2 才读,配合 persistent Hint + SetL2CacheHint(DISABLE 挤一次性输入) 提高 L2 命中率。这条路的数据仍要 GM→L2→UB,但命中时省掉 HBM 往返。
避免: 不要指望"跨核直接读对方 UB"——这条路在当前所有 Ascend 架构(910B/910C/950)上都不存在,编译器和硬件都没开这个能力。UB↔L1 直连是 950 的新优化,但它限定在同一 AI Core 内,不跨核。
一句话:UB 是核内私有资源,跨核没有直访通路,同步原语只管顺序不管数据共享;跨核数据复用唯一物理路径是 GM 中转(靠 L2 命中提速),根治做法是把 A/B/C/D 的 Tiling 规划到同一核内、让数据在 UB 里流转不出去。
鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 2
 0
- 0


 已为社区贡献46条内容

所有评论(0)