一次“转置”,半张算力:DeepSeek SwapAB 漂流史——从 H20 社区 PR 到 NVIDIA 官方命名
摘要:SwapAB 是近两年开源 AI 基础设施领域最漂亮的微观样本之一:在矩阵乘指令里交换 A/B 操作数,把硬件最僵硬的维度分配给模型里最静态的张量。它的旅程横跨两代架构与六方生态:2025 年 9 月,社区贡献者 Wangzheee 在 DeepGEMM PR #192 中为 Hopper 写下 wgmma(desc_b, desc_a, …)(H20 上最高 +66.7%);一年半后,NVIDIA 在官方技术博客中将同一技巧命名为 SwapsMmaAb,披露 Blackwell 上稀疏 MLA 吞吐提升 47.03%。本文沿这条"上游化"路径完整拆解 SwapAB 的机制、代价与边界,并以五组真实数字为标本,讨论 kernel 级收益从社区 PR 流向集成方日志、厂商博客与官方 README 的过程中,口径是如何变形的。
0. 引子:一个社区 PR 的上游之旅
2026 年 9 月 26 日,NVIDIA 发布 TensorRT-LLM 技术博客第 15 期《Optimizing DeepSeek-V3.2 on NVIDIA Blackwell GPUs》。其中一节以 SwapsMmaAb 为名,专门介绍了一个矩阵乘优化技巧:在矩阵乘中交换 A、B 操作数,以提升张量核利用率。
追根溯源,这个技巧最初既不出自 NVIDIA,也不出自 DeepSeek 的正式员工——它来自 2025 年 9 月社区贡献者 Wangzheee 向 DeepGEMM 提交的 PR #192,最初跑在 Hopper 架构的 H20 上。一年半、两代架构、六方生态(社区、DeepSeek、NVIDIA、vLLM、FlashInfer、昇腾),一个几十行代码的技巧完成了从社区 PR 到芯片厂商官方命名的"上游化"之旅。
这件事值得拆开写,因为它同时具备三个特殊性:
- 技术上是深的:它触及张量核指令最底层的形状约束,且横跨 Hopper 与 Blackwell 两代架构;
- 传播上是广的:它横跨社区贡献者、DeepSeek、NVIDIA、vLLM、FlashInfer、华为昇腾六方生态;
- 叙事上是有戏剧性的:最初的手笔并非出自 DeepSeek 内部,而是一位社区贡献者;最终却被芯片厂商的官方博客收编命名——开源史上"上游化"的罕见案例。
先把可核实的东西钉在墙上(第 4 节将用它解剖五组真实数字):
|
数字 |
口径 |
硬件 |
来源 |
|---|---|---|---|
|
+52.5% ~ +66.7% |
masked grouped FP8 GEMM(m=32 档两行) |
H20(Hopper) |
DeepGEMM PR #192 自带基准 |
|
~+40% |
vLLM 集成 DeepGEMM 的 GEMM kernel 提升:#19820 初次集成报 ~40%;适配 DeepGEMM breaking 更新(上游 PR #112)后以 #20087 合入,"特定 batch size 下 ~40%" |
B200 |
vLLM 贡献者 Wentao Ye 开发日志(yewentao256.github.io);初版曾因 breaking 变更经历 revert/重提(社区记录 #20049) |
|
+47.03% |
FP8 稀疏 MLA 吞吐提升 |
GB300(Blackwell Ultra) |
NVIDIA blog15 |
|
+32.64%–64.20% |
各项 kernel fusion 的端到端收益区间 |
同上 |
NVIDIA blog15 |
|
+1.5% |
DeepGEMM Linear 对端到端吞吐的提升 |
Blackwell |
vLLM v0.10.2 release notes |
不看清张量核的"行数之笼",就理解不了这些数字为什么会相差五倍——下面先从硅片层面开始。
1. 两代张量核,同一个"行数之笼"
1.1 指令形状:被硅片焊死的 M 维
从 Volta 到 Blackwell,张量核的宏观趋势是"单条指令的块头越来越大",而 M 维(输出矩阵的行)始终被硬件数据通路焊死:
- Volta / Ampere(SM70/SM80):
mma.m16n8k8/16,M = 16。块头小,浪费有限; - Hopper(SM90):
wgmma.mma_async,M = 64 固定,N 可在 {8, 16, …, 256} 中选取但为编译期立即数; - Blackwell(SM100):
tcgen05.mma(UMMA),单 CTA 发射时 M ∈ {64, 128},两个 CTA 组成 cluster 走cta_group::2时 M ∈ {128, 256};N 为 8 的倍数且最大 256,关键在于——支持运行时改写;K 由数据类型决定(如 FP8/FP6/FP4 混合精度的kind::mxf8f6f4每次 UMMA 吃 K=32)。
Blackwell 的累加器也搬了家:不在寄存器文件,而在 SM 私有的张量内存(TMEM,128 行 × 512 列 × 32bit)。TMEM 的 128 行与数据通路一一对应,第 m 行结果由第 m 条数据通路持有——这就是 M 刚性的物理来源。
铁律:任何自然"行数"远小于指令 M 的 GEMM,都要在 M 维上空转。 图 1 把这行铁律画成了两张脸谱:同一个小 token 数的 GEMM,摆在 M 维利用率上限 25%,swap 到权重侧再落到 N 维则接近打满。后文所有收益,都可以回溯到这两张脸谱之差。
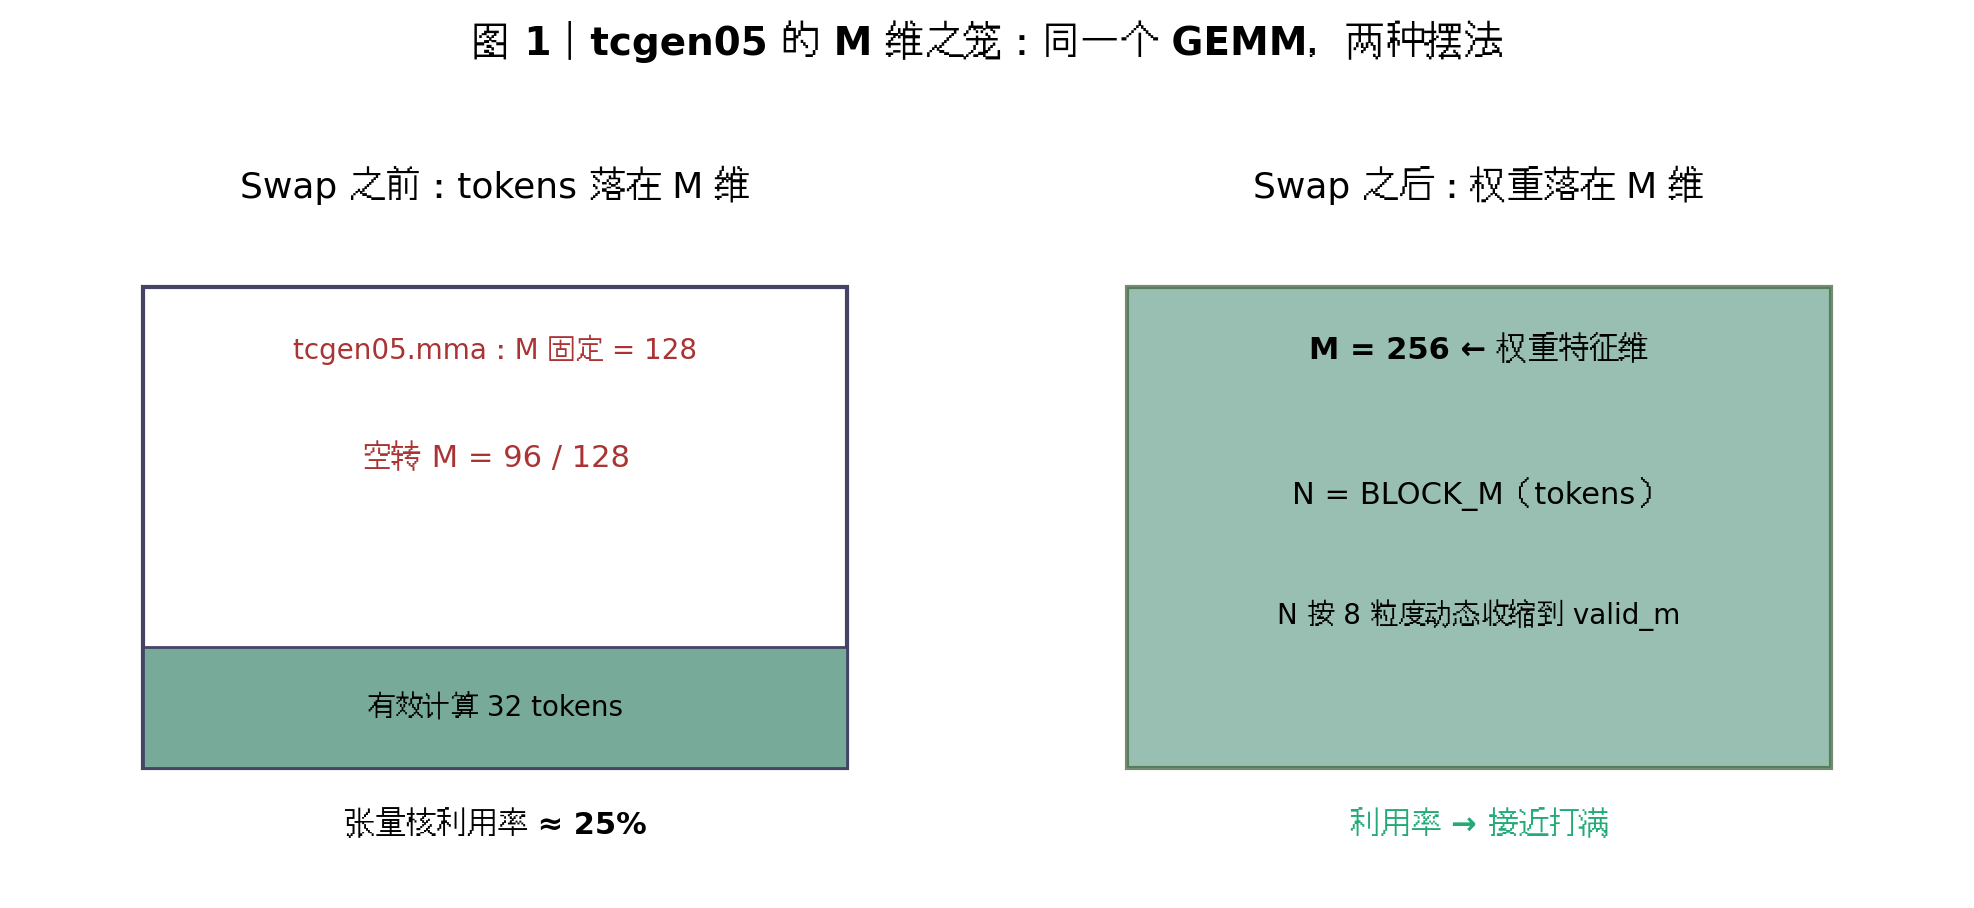
图 1|M 维之笼:swap 前后 M/N 维的分配对比(本文自制示意图)
1.2 历史纵深:为什么 SwapAB 在 Hopper 萌芽、在 Blackwell 绽放
M 的笼子不是 Blackwell 才有,为什么 swap 技巧到这一代才"出圈"?把时间线拉长看,答案在 N 维身上。
Hopper 上社区已经做出了 swap——PR #192 的原文写得明白:"Swap A B: WGMMA::wgmma(desc_b, desc_a, accum, k)",即把权重描述符塞进 wgmma 的 M=64 侧、激活塞进 N 侧。它有效,但天花板清晰可见:wgmma 的 N 是编译期参数,expert 尾块不足一个 tile 时只能在软件层补齐,"动态收缩到 valid_m"做不到。这个痛处当时就写在 PR 自己的 TODO 里——"LowLatency 场景下 BLOCK_M/BLOCK_N 如何选择仍待探索",一句话,编译期 N 让尾块问题无解,作者只能把它留给未来。
Blackwell 把 N 变成了运行时可改写的指令描述符字段(desc.n_dim_ = umma_n >> 3),再配合 2-CTA 的 TMA multicast 语义,swap 才从"一个补救动作"升级成"换维 + 动态结算 + 搬运减半"的完整三连招。硬件刚性的形状没变,变的是刚性的"可编程性"——这是 SwapAB 故事的隐藏主线。
2. 病灶:当 token 比行数还少
1.2 节给出了一半答案:Blackwell 的可编程刚性让 swap 的收益倍增;另一半同样关键——真正把矛盾推到嗓子眼的,是 DeepSeek 的负载形态。撞墙的位置有两处:
- MoE 解码:V3/V4 的 MoE 层有 256 个 expert、top-k=8。decode 时 batch 的 token 数本就不大,经 router 稀释后,单个 expert 摊到的 token 常常只有几十。Grouped GEMM 的每个子 GEMM 以 token 数为"行数",离 64/128 差着数量级;
- 稀疏 MLA + 张量并行:V3.2 的 DSA 保留 128 个 Q 头的设计,TP 切分后每 rank 只剩 128/TP 个头(TP4 时 32),注意力 GEMM 又一次以小行数撞 M 维。
写成算术:自然 M=32、指令 M=128,利用率上限 32/128 = 25%——权重照读、电照耗,四分之三的张量核空转。
这种空转格外贵,原因藏在负载的算术强度里:decode 是低算术强度负载,本就贴着带宽墙跑,Blackwell 的 roofline ridge 点比 Hopper 更靠右,同样的 decode 负载在新硬件上"离计算上限更远、贴带宽更近"(图 2)——也就是说,带宽的账一分省不下来,计算的账却在大把白付。
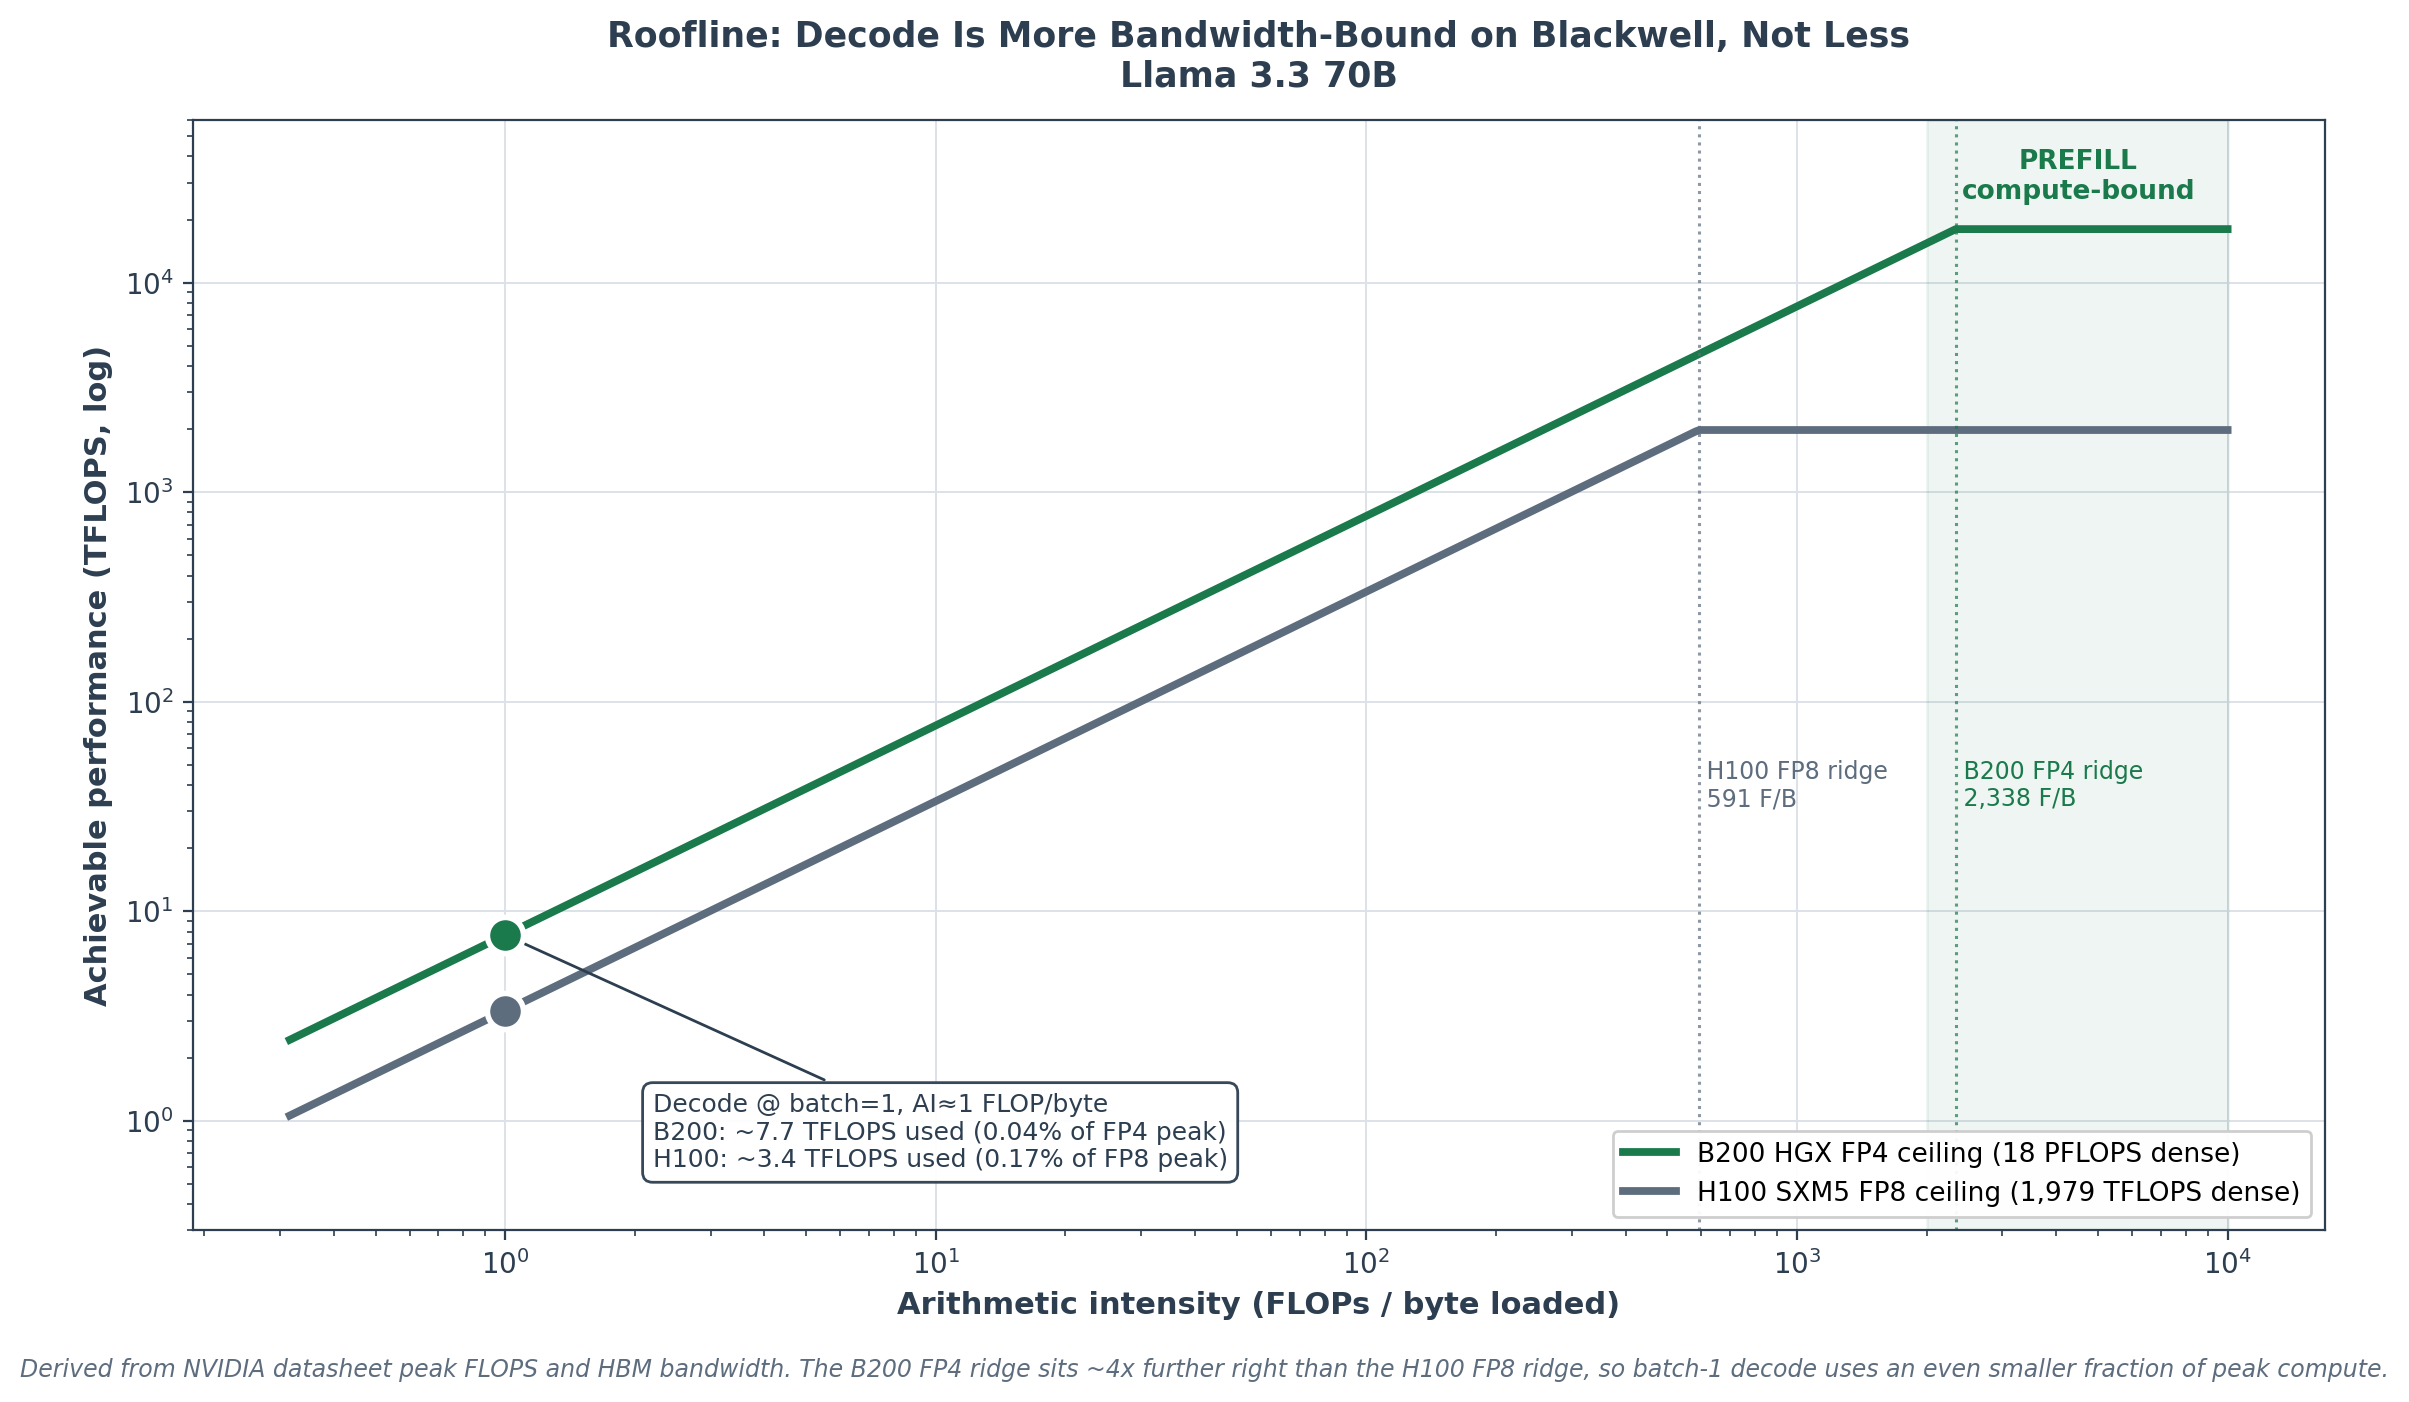
图 2|decode 的 roofline 位置:带宽受限,且 ridge 点右移(来源:thesoftwarefrontier.com)
补充一句避免误读:上面的"带宽受限"是 decode 小批量下的典型形态,不是算子的宿命——batch 足够大时 MoE 同样转入计算受限,长上下文 prefill 里的 MLA 也会变重带宽。真实的分界是算术强度,不是算子名字。
3. SwapAB:把最僵硬的维度,分给最静态的张量
3.1 起源:一位社区工程师和一张 H20 基准表
先纠正传播中的一个"理所当然的误会":swapAB 的第一作者不是 DeepSeek 员工。2025 年 9 月,社区贡献者 Wangzheee 向 DeepGEMM 提交 PR #192《support swapAB for m_grouped_fp8_gemm_nt_masked》——目标是 DeepSeek-V3/R1 MoE 解码用的 masked grouped FP8 GEMM,测试卡是 H20(Hopper)。开关方式朴素得可爱:export ENABLE_SWAPAB=1。
PR 描述里附了完整基准(后文第 4 节将逐行解剖这张表)。此刻先看规律:M 越小收益越大,m=32 时两组配置分别提升 +66.7% 与 +52.5%,m=96 回落到 +26%~47%,m=160 仍有 +56%~61%(图 3)。一条清晰的画像:swapAB 是"小 M 专科医生",M 越大越不需要它。 这个画像在第 3.5 节还会回来收账。
这张表还自带一个坦诚的细节:作者在 TODO 里写明"如何为 LowLatency 场景选 BLOCK_M/BLOCK_N 仍待探索",并计划把 H100/H800 的支持补上。它是一份社区 PR 的原始面貌,不是厂商白皮书——这种颗粒度的开放,是整个故事的地基。
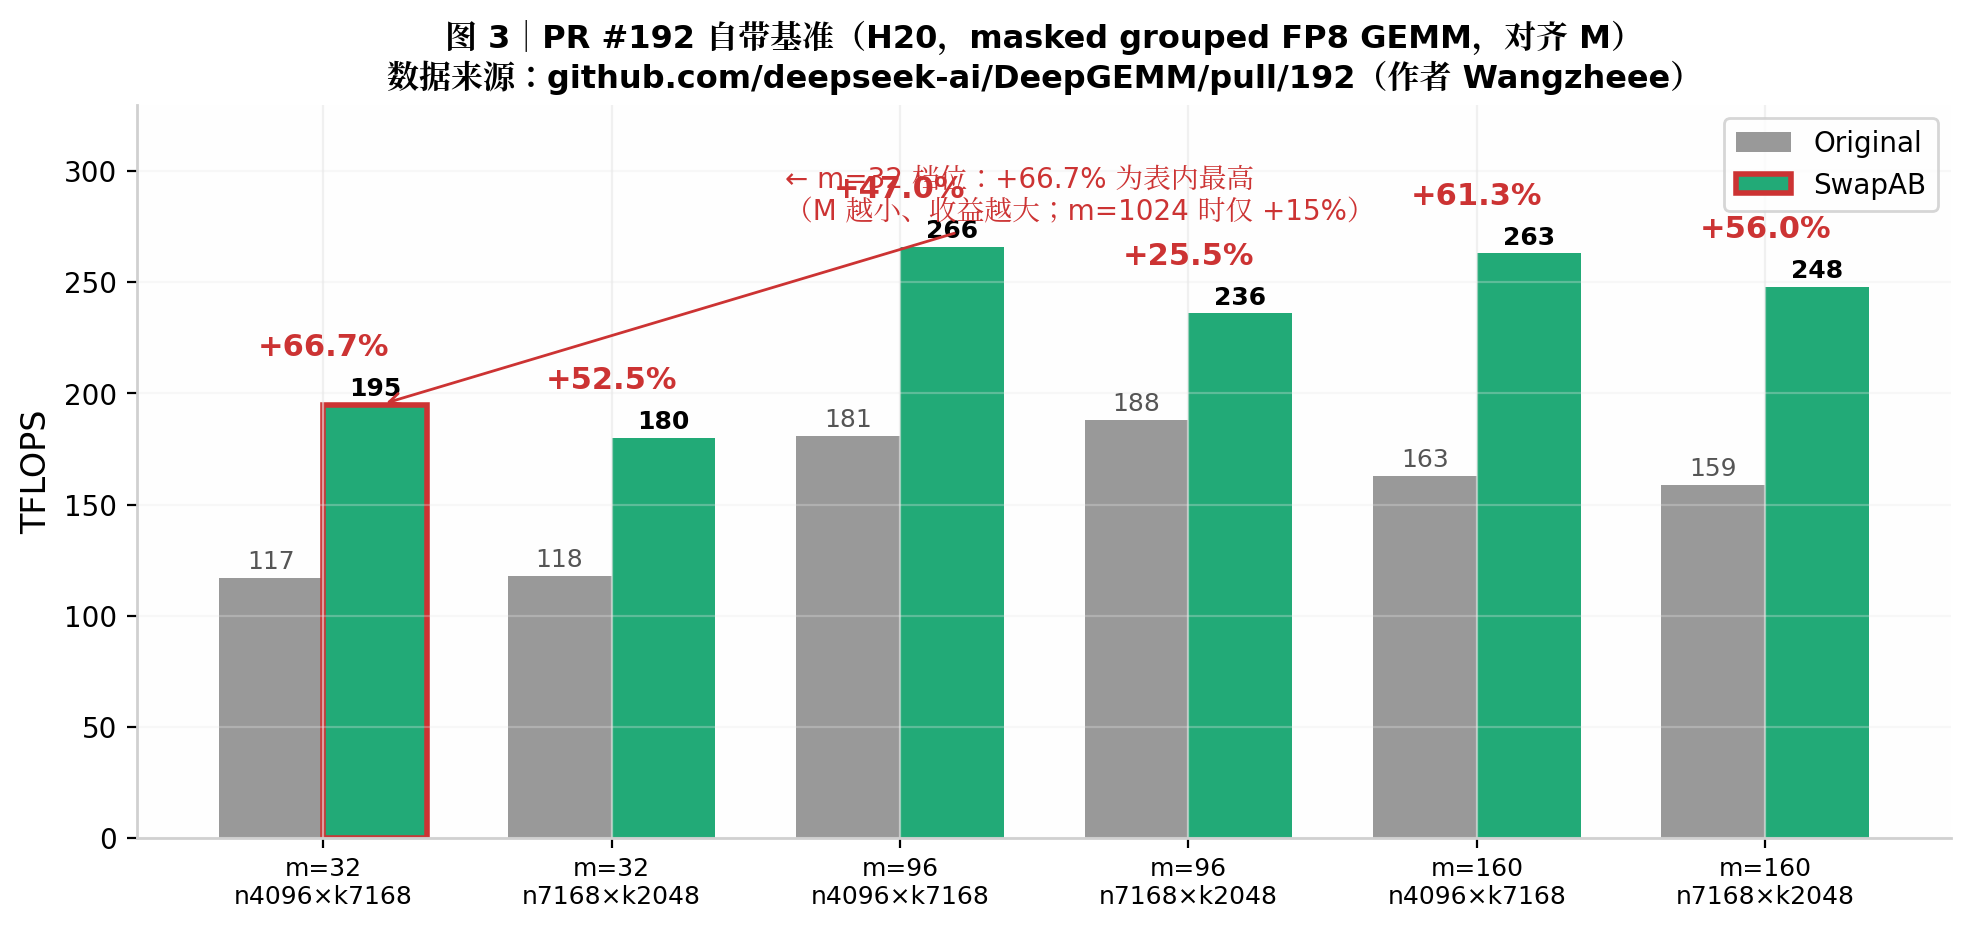
图 3|PR #192 自带基准可视化。测试条件:H20,num_groups=16,对齐 M;n/k 为权重维度(数据取自 PR 原文,本文制图)
3.2 手法:Blackwell 版把 swap 写进了静态断言
先看可验证的一手证据。PR #192 的 diff 里,swap 的核心动作只有两行(Hopper/WGMMA 路径,读者打开 PR 即可自行核对):
# PR #192 diff 节选(Hopper /WGMMA 路径)
exportENABLE_SWAPAB=1                        # 运行期开关,默认关闭
WGMMA::wgmma(desc_b, desc_a, accum, k);       # 描述符对调:权重上 M=64 侧,激活上 N 侧
一行环境变量加一行描述符对调,就是 swapAB 的初始形态。传统摆法里 A = 激活(行 = token)、B = 权重(行 = 输出特征)——直觉来自训练,batch 维天然是"行"。
SwapAB 摆法:A = 权重,B = 激活。权重的特征维(1536/4096/7168……)去对齐 MMA 的 M 硬约束;token 数落到灵活的 N 维。到 DeepSeek-V4 的 MegaMoE SM100 kernel 里,这条规则已固化:
// deep_gemm/include/deep_gemm/impls/sm100_fp8_fp4_mega_moe.cuh
// MMA 配置:固定 swap A/B(A 为权重维、B 为激活维);2-CTA UMMA;K-major
constexpruint32_t LAYOUT_AD_M =128;// 单 CTA 的 TMEM 布局高度
constexpruint32_t UMMA_M      = LAYOUT_AD_M *2;// = 256,2-CTA 发射后的有效高度
constexpruint32_t UMMA_N      = BLOCK_M;// Swap 后,N 维 = expert token 块
constexpruint32_t UMMA_K      =32;// mxf8f6f4 单条 UMMA 的 K 宽
constexpruint32_t LOAD_BLOCK_M = BLOCK_M /2;// A 做 multicast 后单 CTA 只读一半

DG_STATIC_ASSERT(BLOCK_M %16==0,"Invalid block M");
DG_STATIC_ASSERT(BLOCK_N == LAYOUT_AD_M,"Invalid block N");// 权重维必须 = 128
DG_STATIC_ASSERT(BLOCK_K ==128,"Invalid block K");
代码出处说明:以上及 3.3 节的代码片段转引自第三方源码解析(langcopilot.com 对 DeepSeek-V4 MegaMoE 的系列分析),尚未在公开 DeepGEMM 仓库的一手代码中逐字核对——截至发稿,无法在公开仓库中检索到对应文件(或因版本迭代,或该文件未公开)。该 kernel 的存在性有独立旁证:vLLM PR #53040 描述"将 V4 的 replicated FP8 shared expert 融合进 DeepGEMM 的 persistent SM100 MegaMoE kernel",SGLang 的 release notes 亦提及"DeepSeek V4 的 DeepGEMM 与 FlashMLA kernel,含 MegaMoE"。引用时请以"思路级证据"而非"仓库级证据"对待。
同样需要说明版本关系,避免读者混淆:PR #192 属于 V3/R1 时代的 Hopper kernel;上面这段代码来自 V4 时代的 Blackwell MegaMoE kernel——同一思路在两代架构上的两代实现。V4 已随 TRT-LLM 的 "DeepSeek V4 Pro QA" 测试用例与大量第三方部署公开存在。
3.3 第二招:N 维动态收缩到 valid_m
Swap 之后的意外之喜:N 维不仅容忍小尺寸,还能运行时改写。expert 尾块不足 BLOCK_M 时,直接改指令描述符:
// mma/sm100.cuh:UMMA_N 以 8 为编码单位写入指令描述符
voidupdate_instr_desc_with_umma_n(UMMA::InstrDescriptorBlockScaled& desc,
constuint32_t& umma_n){
    desc.n_dim_ = umma_n >>3;// 有效 token 数 valid_m,其余由 TMA OOB 补零忽略
}
// K 循环内发射(注意 fma 的 a/b 描述符与 SFA/SFB 槽位全部对调)
ptx::SM100_MMA_MXF8F6F4_2x1SM_SS::fma(
    b_desc, a_desc,// ← SwapAB:b_desc 在前
    accum_stage_idx * UMMA_N,
    k_block_idx >0|| k >0,// 首条 UMMA 用 scale::0 顺便清零累加器
    runtime_instr_desc,
    kTmemStartColOfSFB, kTmemStartColOfSFA);
尾块不再"补到 128 再算"——算多少写多少,空转税从"按 128 收"变成"按 8 的粒度收"。这一招是 Blackwell 独有的:Hopper 的 wgmma 里 N 是编译期立即数,想做也做不到(1.2 节那行 TODO 就是它的墓志铭)。
3.4 第三招:TMA multicast 顺势白嫖
2-CTA UMMA 的硬件约定:操作数 A 由两个 CTA 各持 M 的一半,操作数 B 由两个 CTA 共享完整 N。Swap 前 A=激活,两个 CTA 各读不同的 token 行;Swap 后 A=权重,两边读同一块权重——权重加载天然走 TMA multicast:
tma::copy<BLOCK_K, LOAD_BLOCK_N, kSwizzleBMode, b_dtype_t>(
    tensor_map_b_ptr, full_barriers[stage_idx], smem_b[stage_idx],
    k_idx, n_idx,2);// ★ num_tma_multicast = 2:一次加载,广播两半集群
权重流量减半,累加器按"列 = tokens"落在 TMEM、由 epilogue 按列取数。对"权重远大于激活"的 MoE,这一页是带宽账本上实打实的进账。
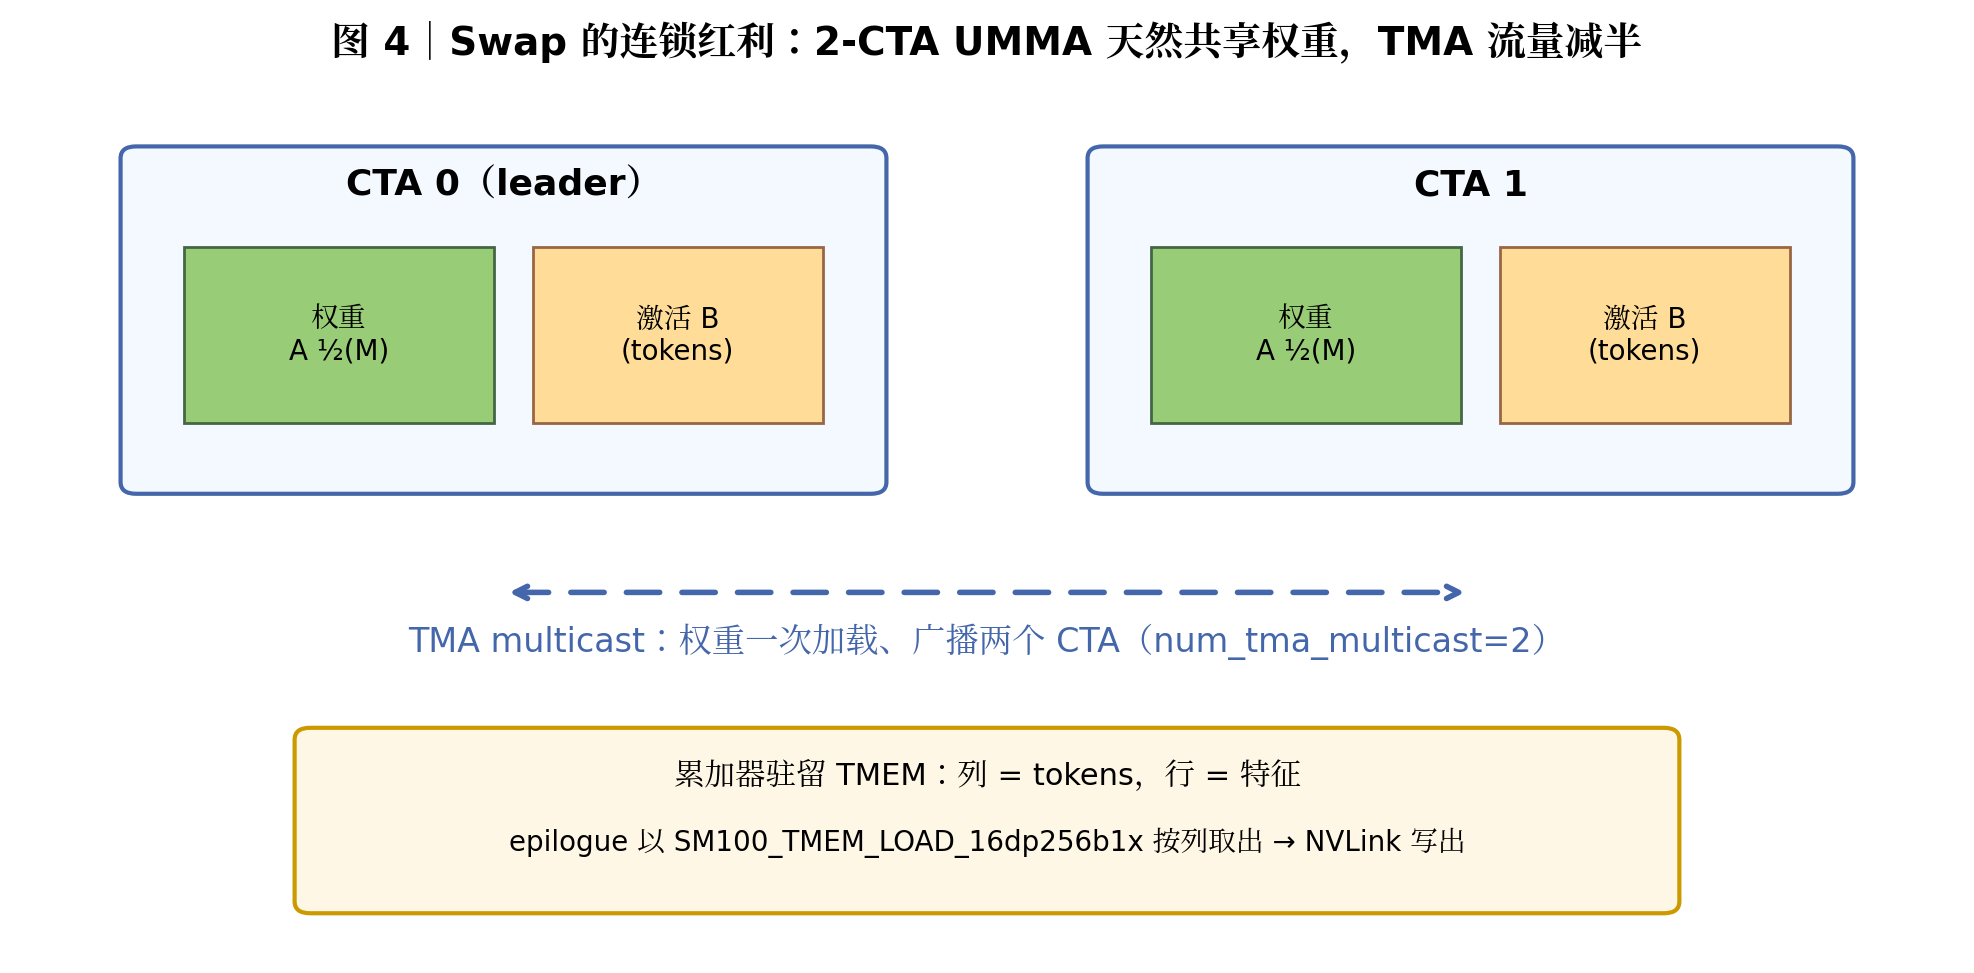
图 4|swap 后的 2-CTA 数据流:共享权重、TMA multicast、TMEM 按列存 token(本文自制示意图)
3.5 代价与边界:五笔账
SwapAB 不是开关一拨就万事大吉,这笔账至少有五笔:
- 布局锁死:
BLOCK_N必须等于 128(DG_STATIC_ASSERT),权重在 SMEM 的 swizzle 模式、TMA 描述符的构建都随之定死,kernel 的通用性让位给特化; - 大 M 时收益消失甚至倒贴:PR #192 自己的数据表明 m=1024 的对齐场景仅 +15%——M 本来就满时 swap 只是增加约束。因此 adaptive kernel selection 是这套技巧不可分割的一半,而且阈值随硬件而变:TRT-LLM PR #4430 的 host 端选择逻辑在 H20(78 个 SM)上是 m_per_expert < 64 启用 swap,在 H100/H200 上则收紧到 < 32——切换线同时取决于问题形状与 GPU 的 SM 数量;
- 特化的组合爆炸:每增加一个 (数据类型 × layout × swap 开关 × tile 形状) 组合,JIT 就多编译一个 kernel 变体。DeepGEMM 在 PR #112 之后以"低 CPU 开销的 JIT + 编译缓存"应对,但面对 serving 端千变万化的 shape 流,变体数量与编译耗时的平衡仍是部署中的现实约束;
- TMEM 列占用:swap 后累加器按列存放、列数=tokens。N 维过大的 batch 会吞掉 TMEM 的 512 列配额,挤压流水线的双缓冲余量;
- 全链路重构成本:TMA→SMEM→UTCCP→UMMA→TMEM→epilogue 每一环的地址推导都要按"列即 token"重写(epilogue 里
SM100_TMEM_LOAD_16dp256b1x的列偏移链),这也是模仿者多、做对者少的原因。
4. 数字的口径:同一个技巧,五组数字
SwapAB 的收益数字散落在一年半的传播链上,几乎每一组都带着不同的口径字段。把它们并排放在一起,比任何单点数字都更能说明问题。
第一组:PR #192 的 H20 基准(2025-09,kernel 级,Hopper)。 前文已经见过这张图,这里把六行数据完整列出(H20,num_groups=16,对齐 M):
|
配置 |
Original |
SwapAB |
提升 |
|---|---|---|---|
|
m=32, n=4096, k=7168 |
117 TFLOPS |
195 TFLOPS |
+66.7%(表内最高) |
|
m=32, n=7168, k=2048 |
118 TFLOPS |
180 TFLOPS |
+52.5% |
|
m=96, n=4096, k=7168 |
181 |
266 |
+47.0% |
|
m=96, n=7168, k=2048 |
188 |
236 |
+25.5% |
|
m=160, n=4096, k=7168 |
163 |
263 |
+61.3% |
|
m=160, n=7168, k=2048 |
159 |
248 |
+55.9% |
规律依旧:M 越小收益越大;而一旦 M 对齐(m=1024),收益立刻回落到 +15%——这组数字天生属于小 M 场景(图 3,见 3.1 节)。
第二组:vLLM 集成实测(2025-06 起,B200,"特定 batch size")。 vLLM 贡献者 Wentao Ye 的开发日志记录:#19820 初次集成报 "~40% GEMM perf improvement";DeepGEMM SM100 重构(上游 PR #112)带来 breaking 变更,初版集成随之 revert 并重提,最终以 #20087 合入——表述也谨慎地改为 "特定 batch size 下 ~40%"。同一段旅程的后续 PR 还报告了 ~15% 的端到端提升。限定词本身就是信息:一个 batch size 敏感的技巧,离开它的主场,数字立刻缩水。
第三组:NVIDIA blog15(2026-09-26,GB300,厂商口径)。 FP8 稀疏 MLA 吞吐 +47.03%;Top-K 索引 7.41×;kernel fusion 端到端 +32.64%~64.20%。这是全链条中口径最完整的一组:厂商博客不需要取悦任何一方,因此同时给出了吞吐、端到端与单项数据。
第四组:vLLM E2E(v0.10.2,+1.5%)。 这组数字提醒:kernel 收益 × 负载占比 ≠ 端到端收益。摊薄是非线性的(随 batch size 剧烈变化)、存在木桶效应(GEMM 提速后瓶颈立即转移到访存与调度)、kernel 收益本身还受 L2 命中与带宽余量约束。+1.5% 是全部约束共同作用后的诚实结果。
第五组:DeepGEMM README(对基线 1.1×–1.2×)。 官方 README 的保守标注与 PR 里的 +66.7% 并存:同一事实的两种文体——面向潜在用户的 README 需要数字长期站得住,面向评审的 PR 只需要数字当下站得住(图 6)。
五组数字,五套口径:硬件不同(H20 / B200 / GB300)、层级不同(kernel / 端到端)、来源立场不同(社区 PR / 集成方日志 / 厂商博客 / 官方 README)。图 5 以灰线分列。这组对照提供了本文最想留下的读数纪律:读任何"提速 X%"之前,先问三个字段——什么硬件?什么层级?谁说的?
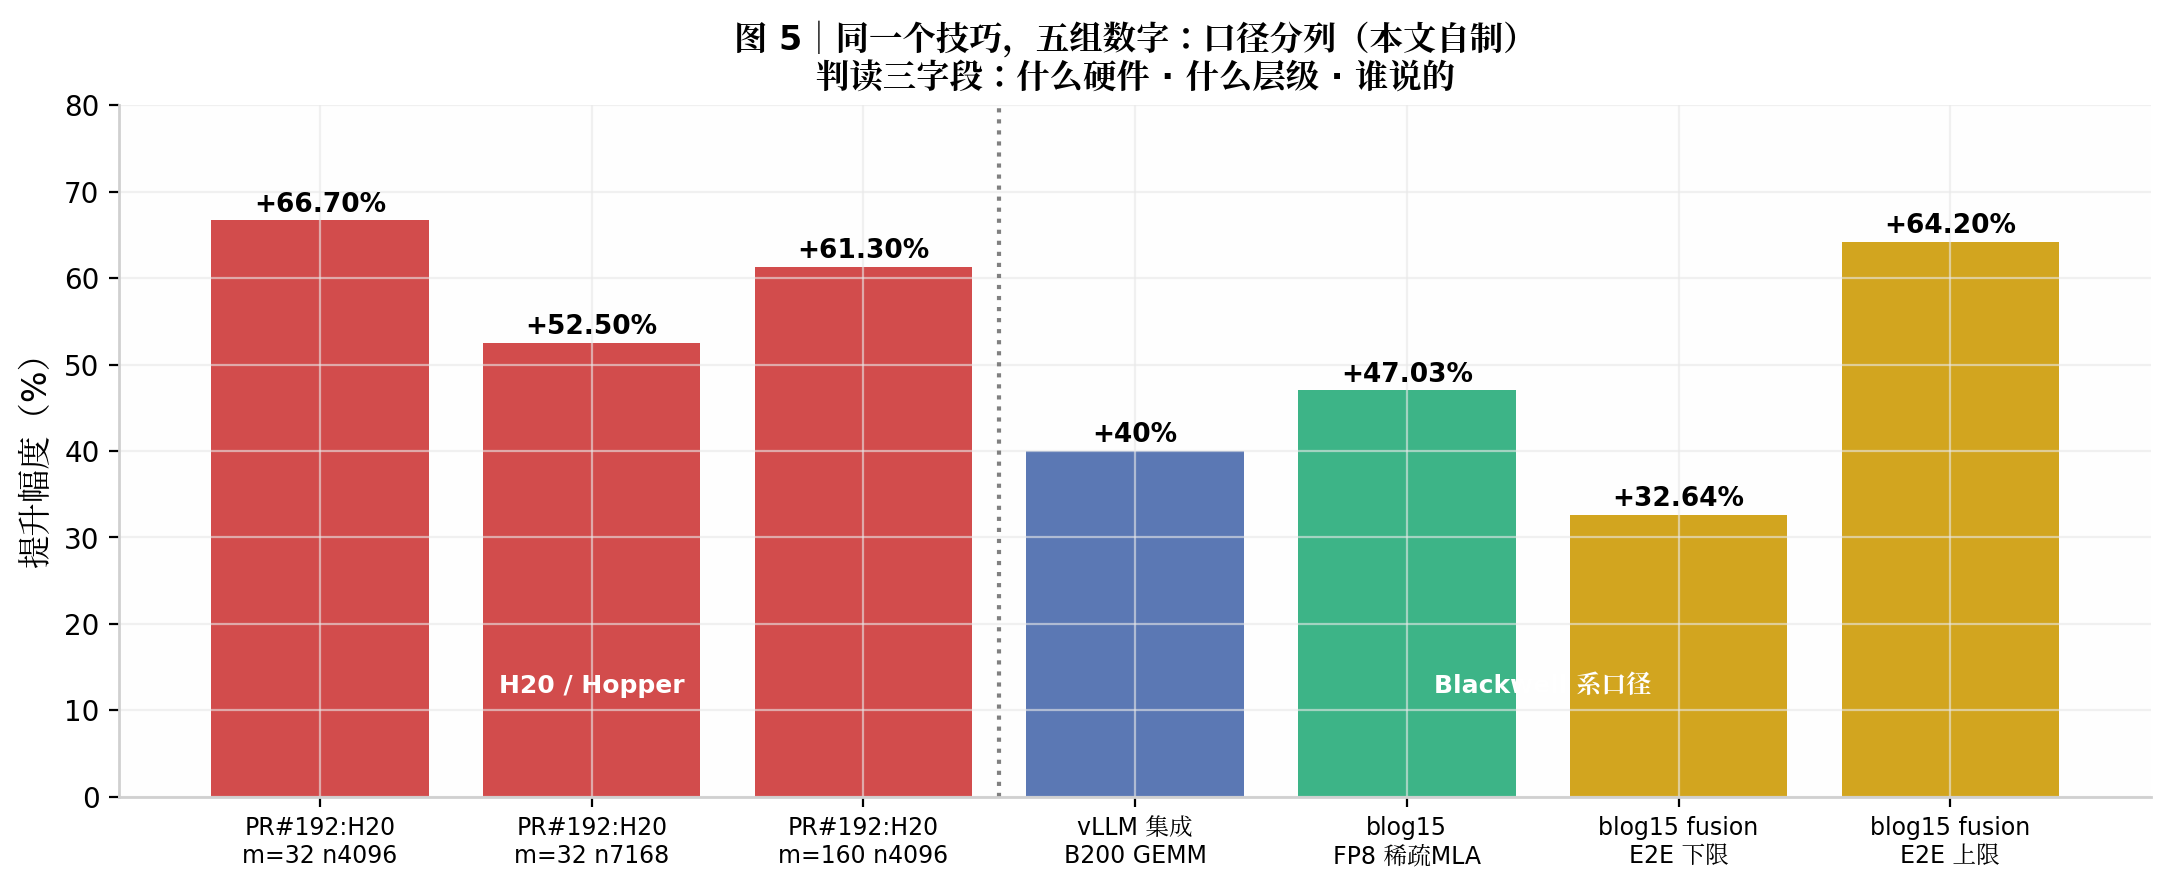
图 5|同一个技巧,五组数字:口径分列(本文自制)。判读三字段:什么硬件 · 什么层级 · 谁说的
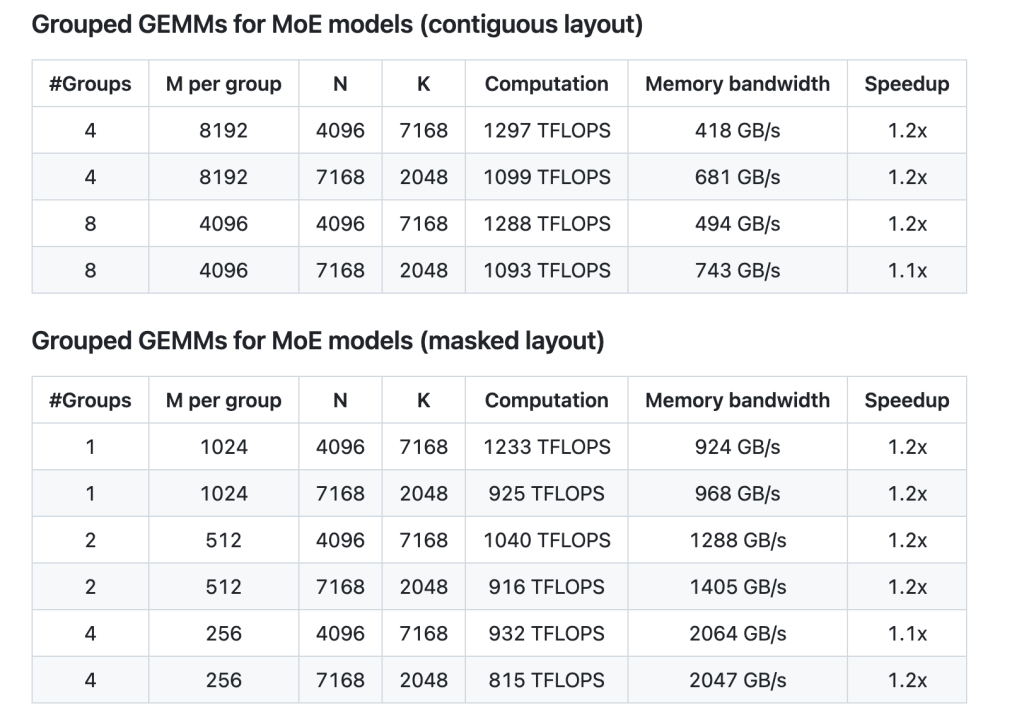
图 6|DeepGEMM 官方 README 基准表:对基线的保守标注(来源:DeepGEMM README,经 MarkTechPost 转载)
5. 生态回响:一个社区 PR 的上游漂流
SwapAB 的传播路径,是观察开源基础设施博弈的最佳样本:
- 2025-02-13,DeepGEMM 开源;
- 2025-07-20,PR #112 完成 SM90/SM100 双架构重构,SM100 支持四种 layout 与 UE8M0 packed 缩放;
- 2025-09,PR #192(Wangzheee)为 Hopper masked grouped GEMM 加入 swapAB——本文主角登场,身份是社区贡献者而非 DeepSeek 员工;
- 2025-12-24,TRT-LLM PR #4430 合并(据 PR 页面记录),将同一思路引入 NVIDIA 官方栈;FlashInfer 亦提供 swapAB 风格 kernel(vLLM 路线图明确提及整合);
- 2026-02-13,vLLM 官方博客《DeepSeek-V3.2 on GB300: Performance Breakthrough》发布实测数据(图 8);
- 2026-09-26,NVIDIA blog15 把该技巧命名为 SwapsMmaAb 单列一节,披露稀疏 MLA +47.03%、Top-K 7.41×、kernel fusion 最高 64.20% E2E;
- 2026-04-27,DeepGEMM issue #320:社区工程师公开追问 mega kernel 与 w4a8 grouped GEMM 中 swapab 的收益来源——技巧的工程讨论已经日常化,这是"传播广泛"可以坐实的形态;
- 2026-09-30,DeepGEMM-Ascend 发布;FlashMLA 仓库同日新闻宣布昇腾 950 NPU 版稀疏算子(prefill/decode 410/360 TFLOPS,标称 95%/83% 峰值)并附技术报告——"换维对齐硬件约束"的思路完成跨硬件验证。
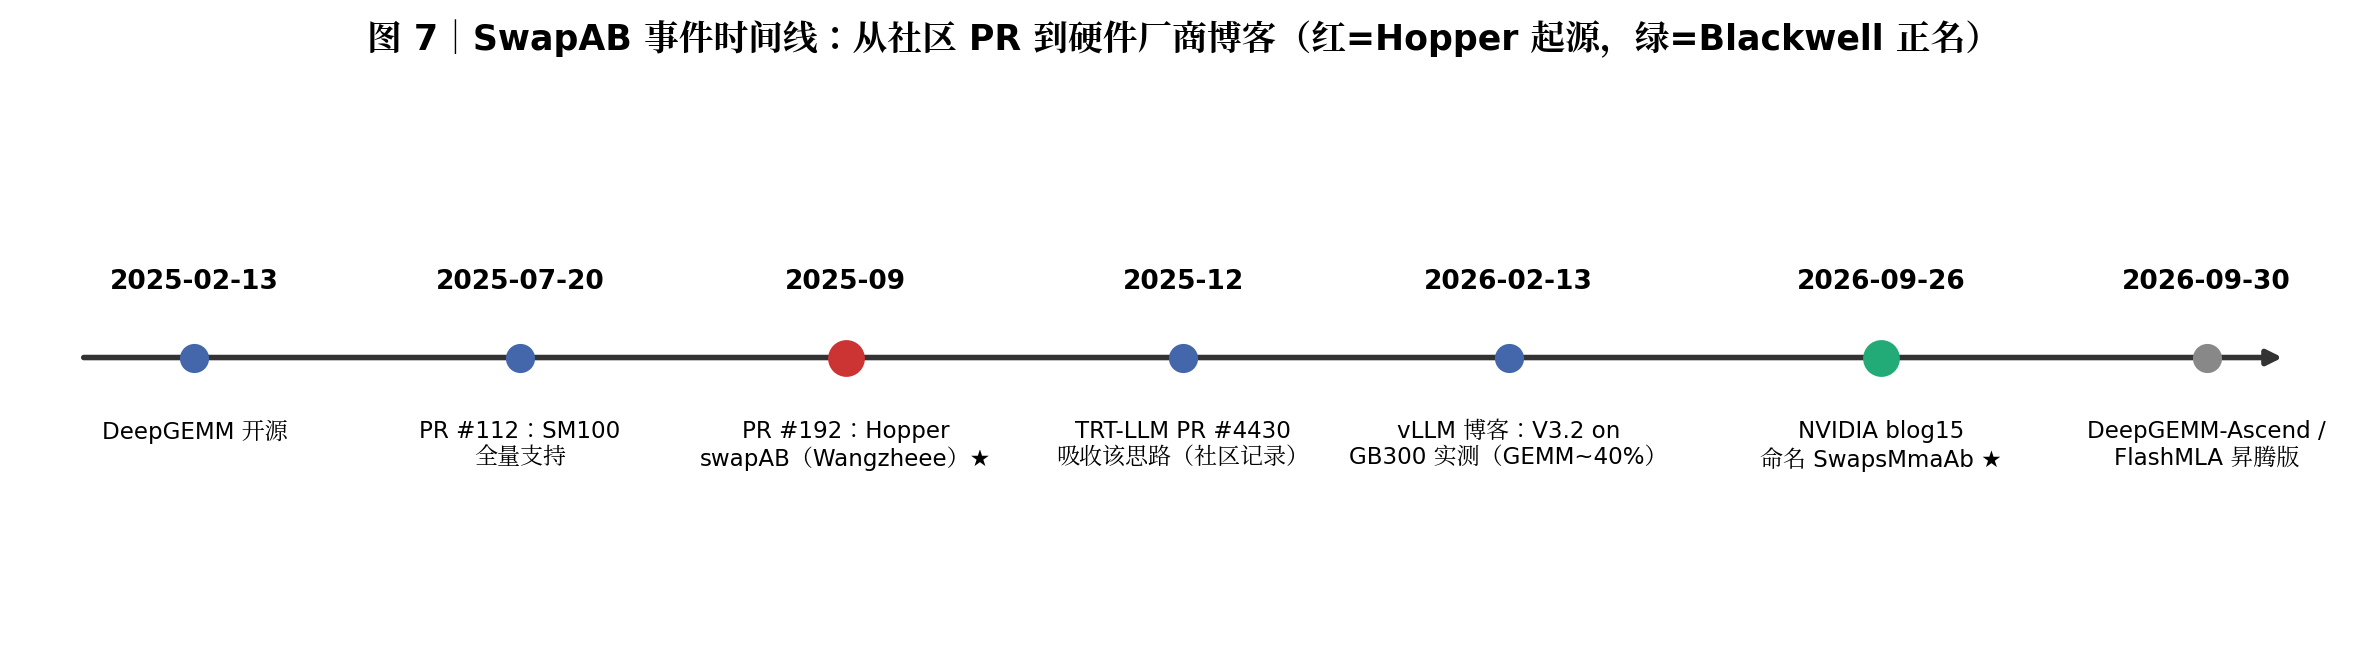
图 7|SwapAB 的漂流史:红=Hopper 起源,绿=Blackwell 官方正名(本文自制)
横向看竞争格局,同一技巧在生态里有三种实现姿态:DeepGEMM 走 JIT 路线——按 shape 现场编译、启发式选择是否 swap(3.5 节的组合爆炸账),极限性能最高、编译有开销;FlashInfer 走预编译库路线——swapAB 风格 kernel 开箱即用,牺牲一点峰值换确定性;CUTLASS 在 SM100 collective builder 的模板参数层面支持 A/B 角色互换(UMMA atom 不区分语义只认 layout),是"重剑无锋"的通用解。vLLM/SGLang 在调度层按问题形状在三家之间选型——技巧的扩散终点,是它变成所有人的默认选项。
纵向看 DeepSeek 自身的技术版图,还有一条常被忽略的路线分野:DeepGEMM/FlashMLA 代表的 PTX 级手写 kernel,与 DeepSeek 开源的 tile 级 DSL TileLang 代表的生产力路线。"SwapAB 能否在 DSL 中表达"这个问题其实已有初步答案:SGLang PR #15763 的 TileLang 实现明确标注 "inspired by TRT-LLM #4430 and DeepGEMM #192",在 RTX 4090 上对比 Triton 报 5.77×、在 H20 上对比 DeepGEMM 报 1.42×(数字与硬件组合据 PR 标注)。真正的问题随之升级:DSL 表达后的性能天花板,能否在更多硬件上追平手写内核?这决定了"手写派 vs 编译派"的分界线往哪边移。
再看"为什么是 DeepSeek"。先交代论证性质:以下不是有访谈或内部文件背书的结论,而是本文基于公开事实(一个社区 PR 的走向)提出的解释框架——姑且称之为"广场"模型——供读者检验。它要回答三个问题。
其一,DeepSeek 与 Meta/Google 的基础设施开源有何本质区别?一个可能的解释是:Meta 开源模型,但 kernel 栈(如 FBGEMM)深绑推荐场景、与模型发布脱节;Google 的 XLA 是编译器通用路线,不为自家模型的独特架构做手工特化。而 DeepSeek 让模型与 kernel 作为一套东西同时开源:DSA、细粒度 MoE 的每一个非常规设计,几周内就会在 DeepGEMM/FlashMLA 里长出对应的算子——如果"广场"模型成立,这正是广场有人的原因。
其二,这个"广场"收得到租金吗?本文的假说是:租金的来源是负载的独特性——只要下一代架构继续由 DeepSeek 定义"非常规",适配的先发权就留在广场中央;反之,若某代模型退回常规 GQA 稠密架构,租金即刻归零。这是该策略的内在风险而非外部威胁,也可以反过来读作 DeepSeek 坚持架构创新的动机之一。
其三,Wangzheee 为什么把 PR 交给 DeepGEMM 而非 CUTLASS/FlashInfer?作者未留下动机自述,但 PR 文本本身提供了推断依据:他动手的 API 是 DeepGEMM 的 masked grouped GEMM、测试卡是 H20——前者是 DeepSeek MoE 推理的原生 API,后者是其主力部署硬件,二者本就配套;PR 合入后数周内就能经由 vLLM/SGLang 的依赖进入真实生产集群;而对 CUTLASS,漫长的评审周期足以让技巧错过一代模型的部署窗口。若此推断成立,贡献者用脚投票,投的是"哪条路径最短地抵达算力账单"。
6. 定位:软硬协同设计的"第三层"
SwapAB 值得写进教科书,因为它示范了 co-design 的第三个层次:
- 第一层:模型架构迁就硬件——MLA 把 KV 压成 576 维潜向量,本质是给 HBM 带宽松绑;
- 第二层:编译与调度软化硬件——persistent kernel、CUDA Graph、Wave 调度把碎片负载拼成规整流;
- 第三层:改写指令语义层的"题面"——不搬数据、不改算法、不动精度,只在指令描述符里交换 A/B 的含义,让硬件约束从绊脚石变成顺风车。
PR #192 → SwapsMmaAb 的漂流,恰好是第三层的两次登台:Hopper 上的版本(换维)证明了"题面可改",Blackwell 上的版本(换维 + 动态结算 + multicast)证明了"题面可被持续改写"。它的出现有两个前提:其一,新指令把 GEMM 的题面参数(M/N 形状、操作数角色、缩放因子槽位)暴露得足够细;其二,开源 kernel 社区把"读 PTX 写 kernel"变成了模型公司与社区工程师的标准能力。
推广一步:凡"自然行数"小于硬件指令 M 的负载——MoE decode、稀疏 MLA、投机解码的 draft 验证、小 batch LoRA serving——都存在同构机会。反过来,若下一代硬件把 M 维也做灵活、或把 multicast 做进指令语义,这个技巧就会自然消亡。好技巧的价值,正在于它精确瞄准了某代硬件的刚性。
7. Rubin 前夜:结语
2026 年 4 月的 MLPerf Inference v6.0 上,GB300 NVL72 跑 DeepSeek-R1 交出了 8064 token/s/GPU,较 v5.1 提升 2.77 倍。几个月前,vLLM 官方博客的 GB300 实测(2026-02-13)则给这种乐观浇了一盆清醒的冷水:DeepSeek-R1(NVFP4+EP2)prefill 峰值达 22476 TGS,较 H200 提升约 8 倍;而 V3.2 的稀疏注意力在现行栈里尚未兑现纸面优势——indexer 路径使单层 kernel 耗时达到 MLA 的 2.7 倍,TTFT 反而比 R1 差约 55%,官方小标题直言 "Still Way To Go"(图 8)。kernel 级技巧的合力再强,也还补不上架构新原语的适配欠账——这是 SwapAB 故事最诚实的注脚,也是一切 kernel 级乐观最需要的对冲。
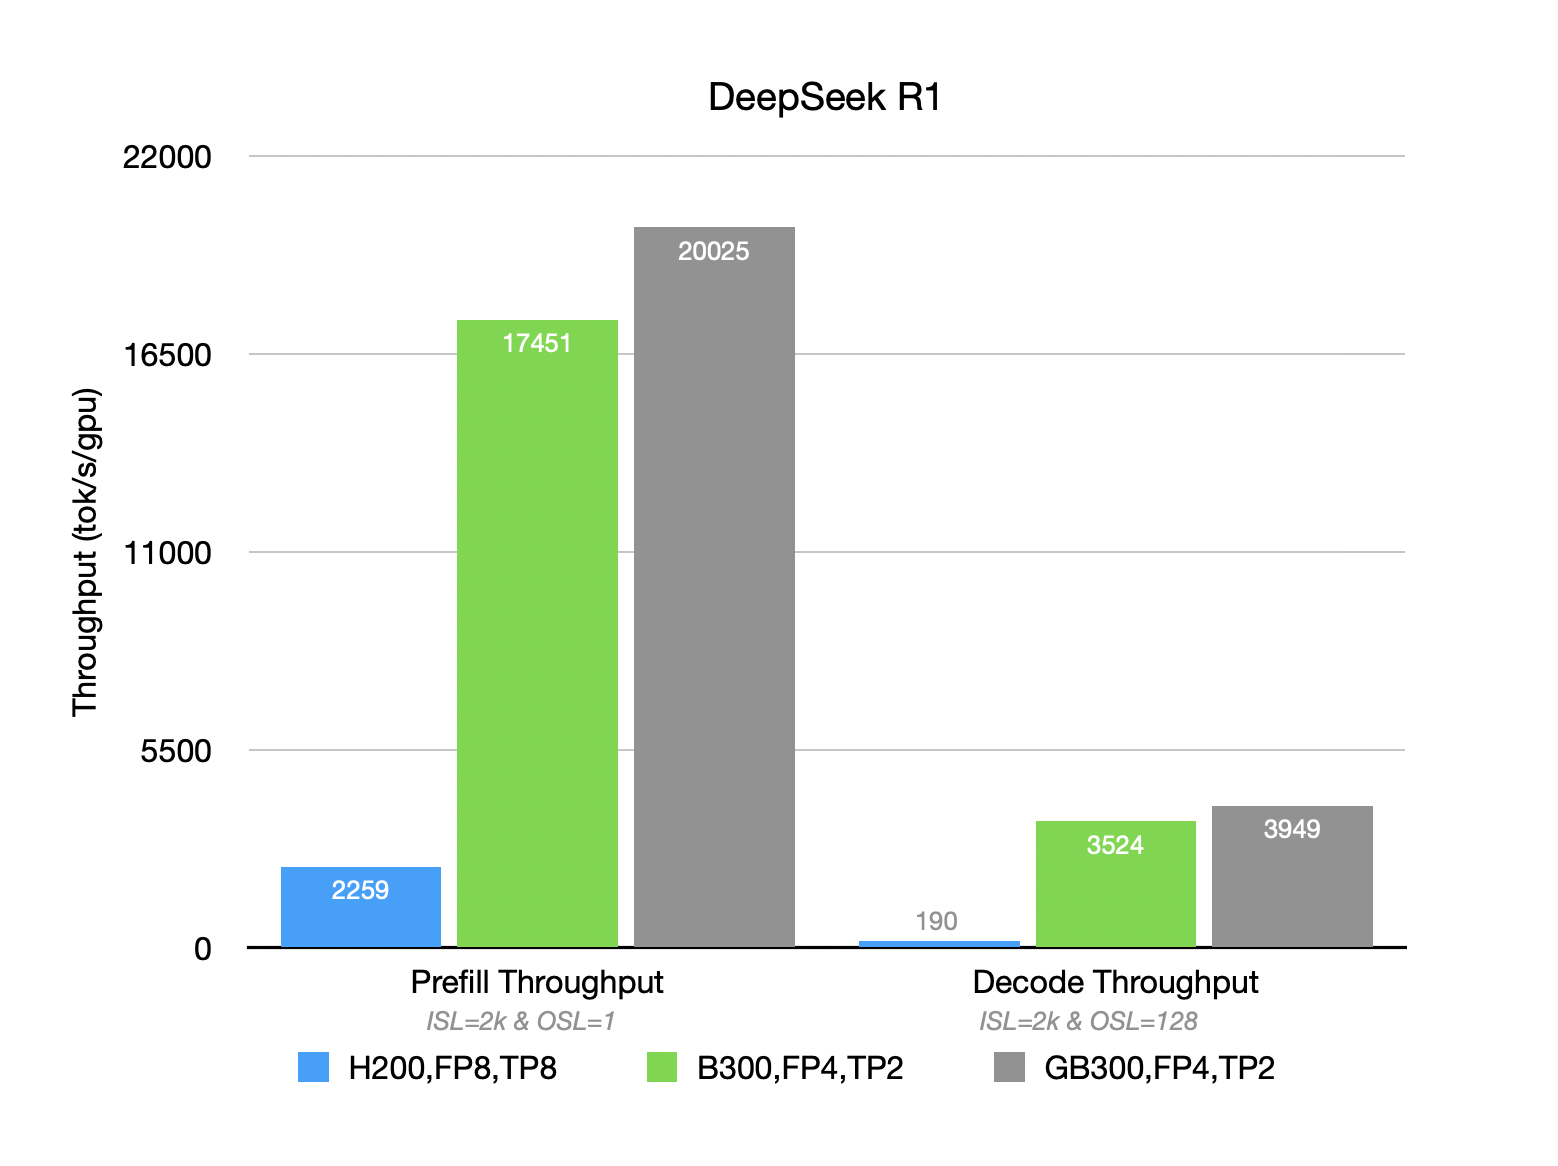
图 8|vLLM 官方 GB300 实测:R1 与 V3.2 的性能对比(来源:vLLM 官方博客,2026-02-13;V3.2 差距分析见 "Still Way To Go" 一节)
而 NVIDIA 官方博客为 R1 创纪录推理性能配的宣传图,从另一个角度记录了 Blackwell 的绝对水位:B200 NVL8 将 DeepSeek-R1 671B 的单用户输出速度推到 253 token/s,H200 NVL8 为 54(图 9)。"SwapAB 们"不会出现在任何一张宣传图的标题里,但它们藏在这些柱子的每一个像素里。
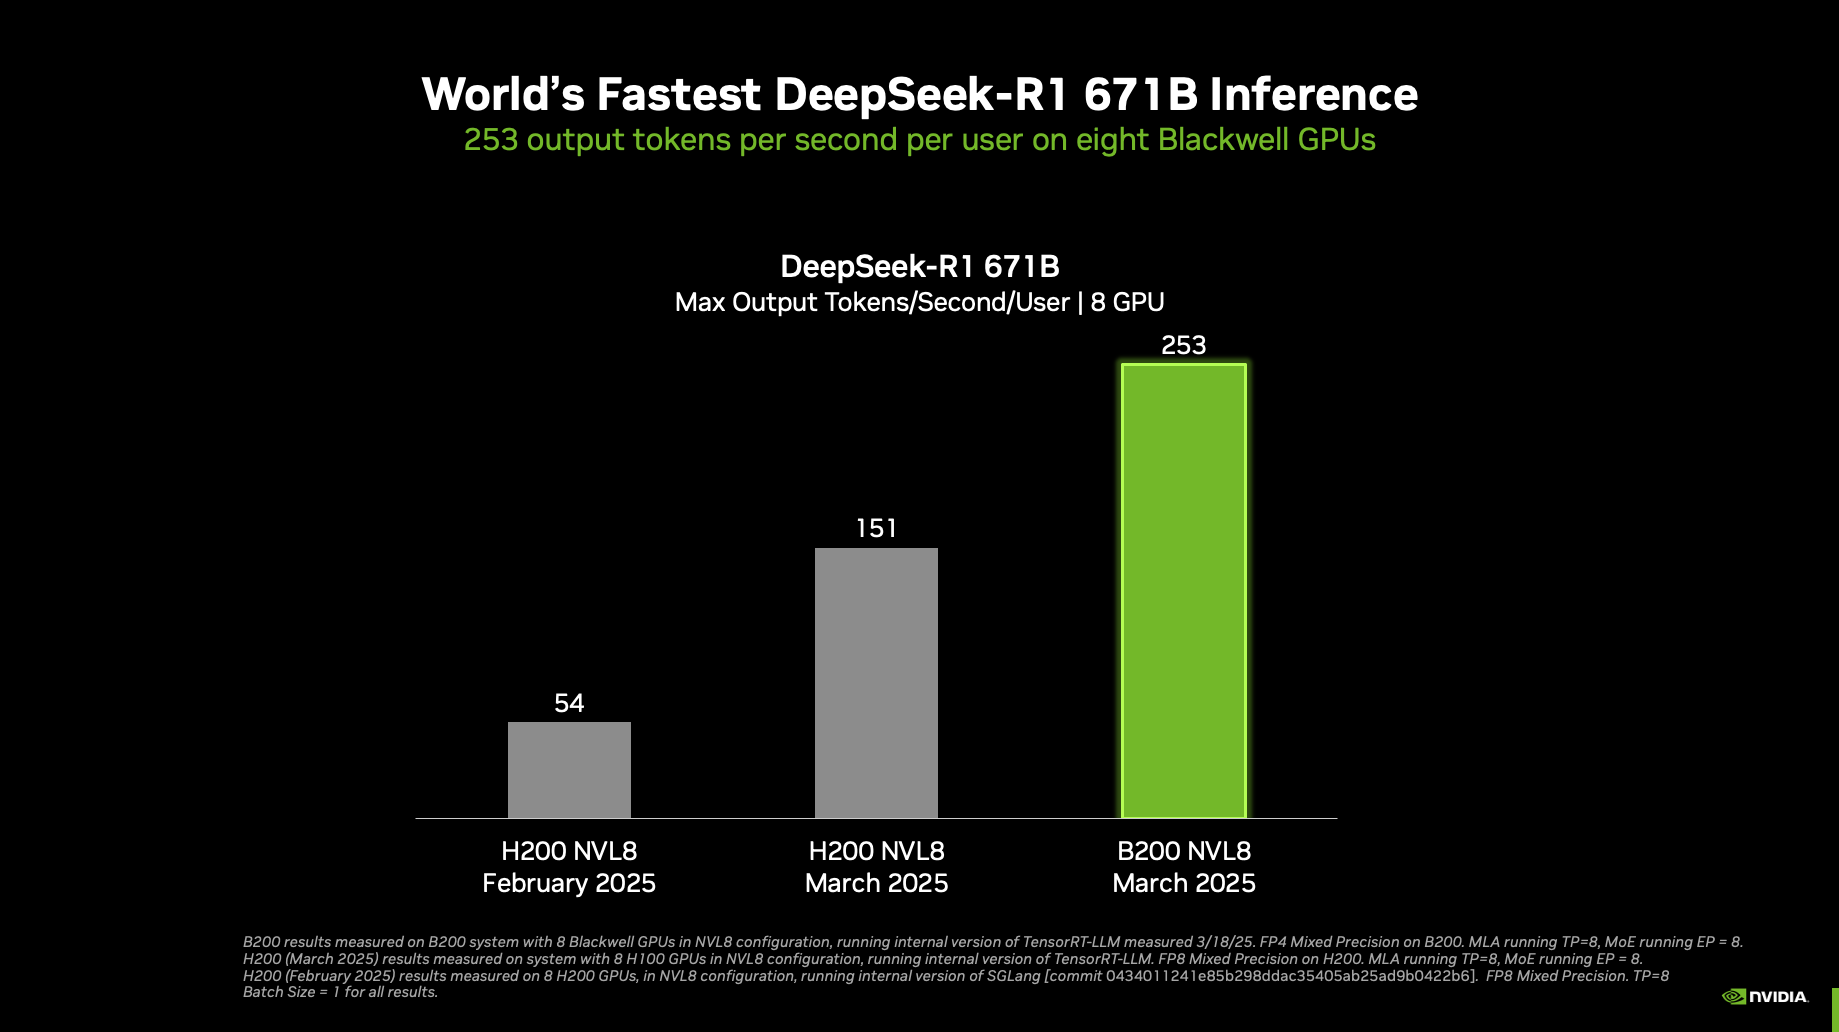
图 9|B200 NVL8 上 DeepSeek-R1 671B 单用户输出速度纪录(来源:NVIDIA 官方开发者博客)
于是可以给 SwapAB 一个总体评价了。它指向的变革是真实且深刻的:当社区工程师在 Hopper 上写下第一行 wgmma(desc_b, desc_a, …),当 DeepSeek 把这条思路写进 Blackwell kernel 的静态断言,当芯片厂商为它命名并写进官方博客——AI 基础设施的竞争就进入了"纳米级"时代:胜负不再只由 FLOPS 和显存带宽决定,也由谁更懂得在 128 行的 TMEM 里安置一个不满 32 行的张量决定。
SwapAB 终将在某代硬件上消亡——所有瞄准刚性的技巧都会。它留下的不是技巧,而是一种提问方式:在宣布算力提升之前,先数清楚这 128 行里,究竟坐着多少 token。
创作不易,禁止抄袭,转载请附上原文标题及其链接。
参考资料
- DeepGEMM PR #192《support swapAB for m_grouped_fp8_gemm_nt_masked》(作者 Wangzheee,2025-09)——全部 H20 基准数字与 swap 的 WGMMA 实现(
export ENABLE_SWAPAB=1、WGMMA::wgmma(desc_b, desc_a, accum, k)):github.com/deepseek-ai/DeepGEMM/pull/192 - NVIDIA TensorRT-LLM Tech Blog 15: Optimizing DeepSeek-V3.2 on NVIDIA Blackwell GPUs(2026-09-26)——SwapsMmaAb、FP8 稀疏 MLA +47.03%、Top-K 7.41×、kernel fusion 32.64%–64.20% E2E。
- TRT-LLM PR #4430(2025-12-24 合并,据 PR 页面记录)——swapAB 引入官方栈;其 host 端选择逻辑:H20(78 SM)于 m_per_expert<64 启用,H100/H200 于 <32 启用(阈值细节转引自社区核查,刊出前建议对照 PR diff 复核)。
- DeepGEMM 仓库 README、News 与 Issues——2025-07-20 PR #112(SM90/SM100 全量重构)、issue #320(2026-04-27,社区对 mega kernel 与 w4a8 grouped GEMM 中 swapab 收益的追问)、2026-09-10 #432、2026-09-30 #462 与 DeepGEMM-Ascend。
- vLLM 官方博客《DeepSeek-V3.2 on GB300: Performance Breakthrough》(2026-02-13,DaoCloud & vLLM team)——图 8 实测数据(R1 prefill 22476 TGS、V3.2 7360 TGS、DSA 单层 kernel 耗时为 MLA 的 2.7 倍、R1 TTFT 较 V3.2 低约 55%);vLLM v0.10.2 Release Notes——DeepGEMM Linear +1.5% E2E。B200 GEMM ~+40% 出处:vLLM 贡献者 Wentao Ye 开发日志(yewentao256.github.io / wentao.site)——#19820(初次集成,~40%)与 #20087(适配上游 PR #112 breaking 更新后合入,"特定 batch size 下 ~40%");初版集成曾随 breaking 变更 revert/重提(社区记录 #20049)。
- vLLM PR #53040——"将 V4 的 replicated FP8 shared expert 融合进 DeepGEMM 的 persistent SM100 MegaMoE kernel"(MegaMoE kernel 存在性的旁证);SGLang release notes——"DeepSeek V4 的 DeepGEMM 与 FlashMLA kernel,含 MegaMoE"。
- DeepSeek-V4 MegaMoE 源码解析(langcopilot.com,2026-05-15)——3.2/3.3 节代码片段的转引来源,未经一手仓库逐字核对,见正文出处说明。
- FlashMLA 仓库 README(2026-09-30 更新)——B200 稀疏 MLA 1350/1024 TFLOPS;昇腾 950 NPU 版 410/360 TFLOPS(据仓库新闻表述)。
- thesoftwarefrontier.com《The Blackwell Migration Question》——图 2 roofline 推导。
- SGLang PR #15763——TileLang 版 swapAB 实现,标注 "inspired by TRT-LLM #4430 and DeepGEMM #192",RTX 4090 上 5.77× over Triton、H20 上 1.42× over DeepGEMM(据 PR 标注);MarkTechPost 对 DeepGEMM 的报道(2025-02-25)——图 7 官方 README 基准表转载;NVIDIA 开发者博客《NVIDIA Blackwell 实现世界纪录的 DeepSeek-R1 推理性能》——图 9;MLPerf Inference v6.0 GB300 NVL72 8064 token/s/GPU(2026-04,ithome 报道)。
鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)