Ascend C算子开发(进阶)笔记
Ascend C算子开发(进阶)笔记
type: Post
status: Published
date: 2026/08/12
slug: AscendC-Intermediate
summary: Ascend C算子开发(进阶)笔记,包含 AI Core 架构抽象;Ascend C 编程对象;Vector 算子开发流程;Add 算子实现与运行验证;Host 侧实现;Tiling 下发;固定 Shape 与动态 Shape 的 Tiling;Shape 推导;算子原型注册;算子开发工程;Kernel 直调工程;自定义算子工程;算子工程编译与部署;Ascend C 基础 API 与高阶 API;Tensor 高维切分参数;数据搬运、内存管理与任务同步;算子的多种调用方式;Kernel 直调;Ascend CL 调用算子;PyTorch 调用算子;非对齐数据处理;尾块处理;复杂 Tiling 实现;多数据类型算子实现
tags: Ascend, 学技术, 推荐, 文字, 机器学习
category: Ascend
@ZZHow(ZZHow1024)
参考课程:
【Ascend C算子开发(进阶)】
[https://www.hiascend.com/developer/courses/detail/1696414606799486977]
【Ascend C系列教程(中级)】
[https://www.bilibili.com/video/BV16T421r7cX]
1-一个Add算子的前世今生
1-1 AI Core 架构抽象回顾
AI Core 的逻辑组成
- AI Core 是昇腾 AI 处理器中的主要计算核心。进行 Ascend C 算子开发时,可以把 AI Core 抽象为三类核心资源:
- 计算单元:负责实际运算。
- Scalar:标量计算与控制相关处理。
- Vector:向量计算,适合逐元素、向量类操作。
- Cube:矩阵/块矩阵类计算。
- 存储单元:包括片上 Local Memory,用于保存当前 AI Core 正在处理的数据。
- 搬运单元:在 Global Memory 与 Local Memory,以及不同逻辑存储位置之间搬运数据。
- 计算单元:负责实际运算。
- AI Core 的向量计算采用 SIMD 思想:一条指令可以并行处理一组数据,因此算子实现时需要特别关注数据块大小、对齐方式、并行切分和流水调度。
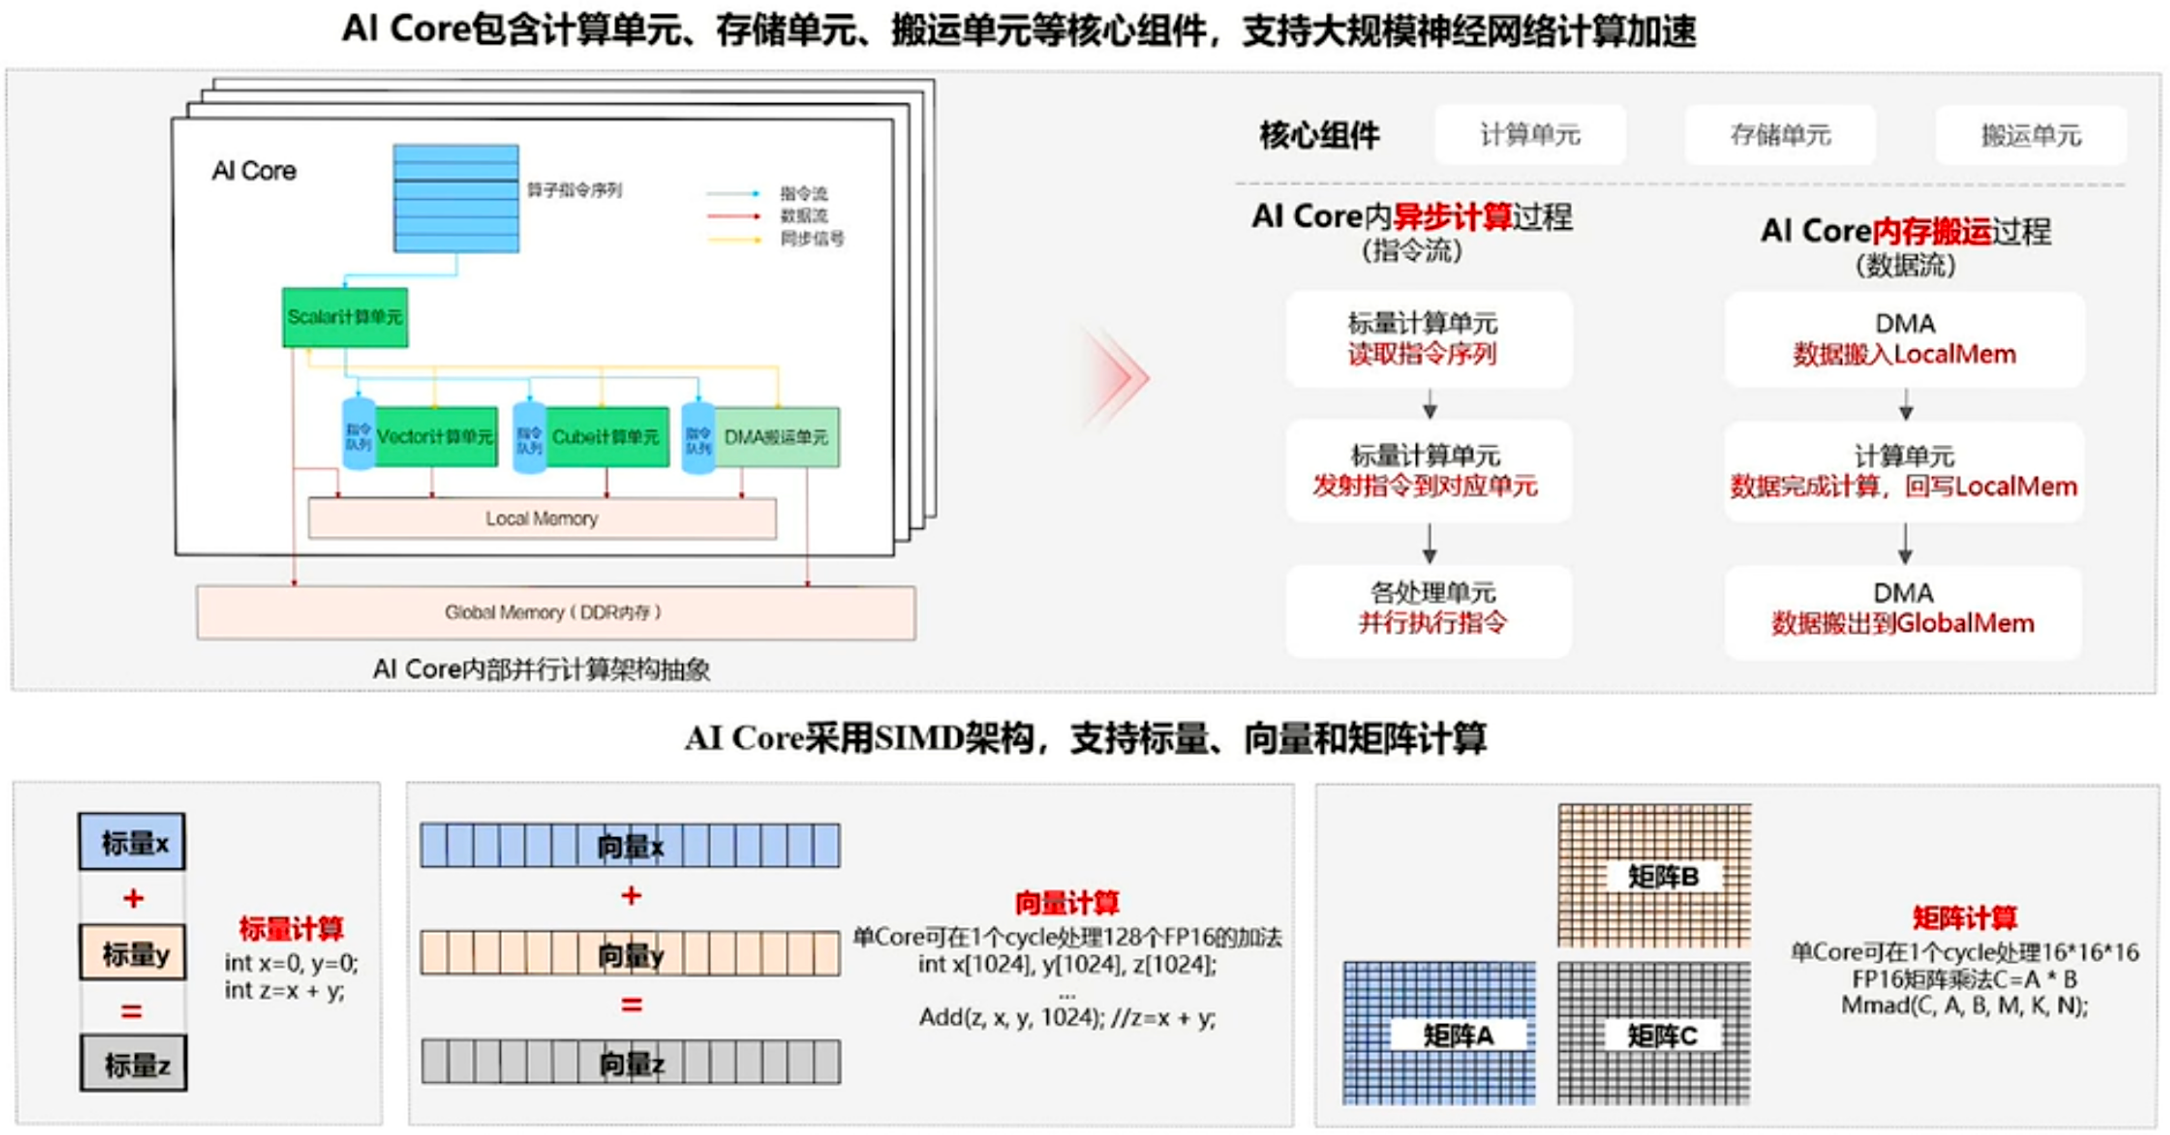
AI Core 逻辑架构抽象
外部存储与内部存储
-
Ascend C 中常用两类 Tensor 对象来表达数据所在的位置:
对象 所在位置 作用 GlobalTensorGlobal Memory 表示外部存储中的全局数据,通常与核函数传入的 GM 地址关联 LocalTensorLocal Memory 表示 AI Core 片上内存中的局部数据,供计算 API 直接使用 -
典型处理流程是:
Global Memory │ │ DataCopy ▼ Local Memory │ │ Vector / Cube / Scalar Compute ▼ Local Memory │ │ DataCopy ▼ Global Memory -
因此,很多 Ascend C 算子的核心都可以归纳成三个阶段:CopyIn → Compute → CopyOut。
GlobalTensor
-
GlobalTensor用于描述 Global Memory 上的数据。通常先用核函数参数获得全局内存地址,再把该地址绑定到GlobalTensor。 -
概念上可以理解为:
GlobalTensor<T> xGm; xGm.SetGlobalBuffer(...); -
之后可以通过下标或切片方式确定当前核需要处理的全局数据范围。
LocalTensor
LocalTensor用于描述 Local Memory 上的数据。Vector 等计算 API 的输入、输出通常是LocalTensor。- LocalTensor 可以进行偏移访问,例如从一个较大的局部 Tensor 中取得某一段数据。算子内部通常不会手工管理裸地址,而是通过
TPipe、TQue和LocalTensor完成片上内存的申请、复用和释放。
逻辑位置 QuePosition
-
Ascend C 使用逻辑存储位置表达不同流水阶段中的数据位置。不同逻辑位置对应不同的硬件访问通路,开发者主要通过 Queue 管理它们之间的数据流转。
-
常见位置包括:
QuePosition 典型用途 VECINVector 计算输入 VECCALCVector 中间计算数据 VECOUTVector 计算输出 A1、A2、B1、B2Cube / 矩阵计算相关输入与中间位置 CO1、CO2Cube / 矩阵计算相关输出位置 -
使用这些逻辑位置时,不需要直接理解底层物理存储结构,但需要明确:数据处于哪个流水阶段、后续由哪个计算单元消费。
1-2 Ascend C 的编程对象
AI Core 内部并行计算的抽象
- Ascend C 算子最终运行在 AI Core 上。一个 AI 处理器中存在多个 AI Core,多核之间通过 SPMD 模型并行执行同一份核函数代码,只是不同核处理的数据区间不同。
- 单个 AI Core 内又包含计算、存储和搬运资源,因此 Ascend C 编程同时需要处理两层并行:
- 核间并行:多个 AI Core 分担不同数据。
- 核内并行:数据搬入、计算、搬出尽可能通过流水重叠执行。
SPMD 模型
-
Ascend C 采用 **SPMD(Single Program Multiple Data)**编程模型:
- 多个 AI Core 执行同一份核函数代码。
- 每个核通过不同的
block_idx区分自己的任务。 - 核函数中可通过
GetBlockIdx()获取当前核的逻辑 ID。 - Host/Tiling 决定使用多少个核以及每个核处理多少数据。
-
可以把不同 AI Core 理解为执行同一个程序的多个“工作实例”:
AI Core 0 ── 处理数据分片 0
AI Core 1 ── 处理数据分片 1
AI Core 2 ── 处理数据分片 2
...
AI Core N ── 处理数据分片 N
Pipe 与 Queue
- 在核内,Ascend C 把数据处理流程拆成多个流水任务(Stage),使用:
TPipe:管理任务间使用的片上内存。TQue:负责不同 Stage 之间的数据传递和同步。AllocTensor()/FreeTensor():从 Queue 对应的缓冲区申请、释放LocalTensor。EnQue()/DeQue():将 Tensor 放入/取出 Queue。
- 这套机制的重点不是“保存一个容器”,而是建立 数据依赖 + 内存复用 + 流水同步。
1-3 Vector 算子开发流程——以 Add 为例
算子分析
- Add 是典型的逐元素 Vector 算子:
z = x + y z = x + y z=x+y
-
示例约定:
项目 内容 输入 x、y输出 zShape (8, 2048)数据类型 halfFormat ND核函数名称 add_custom -
实现时需要明确三类接口:
- 数据搬入:使用
DataCopy等接口将输入从 Global Memory 搬入 Local Memory。 - 计算:使用
Add等 Vector API 完成逐元素加法。 - 数据搬出:将计算结果从 Local Memory 搬回 Global Memory。
- 数据搬入:使用
开发流程
-
Vector 算子开发可概括为:
算子分析
   ↓
定义核函数入口
   ↓
实现核函数内部逻辑
   ├─ CopyIn
   ├─ Compute
   └─ CopyOut
   ↓
运行验证
核函数定义
-
Ascend C 核函数使用
__global__和__aicore__等限定符,设备侧代码直接在 AI Core 上执行。 -
典型形式:
extern "C" __global__ __aicore__ void add_custom(GM_ADDR x, GM_ADDR y, GM_ADDR z, ...) { KernelAdd op; op.Init(...); op.Process(); } -
核函数入口本身通常保持简洁:
- 创建算子实现类。
- 调用
Init()完成地址绑定、切分参数计算和 Queue 初始化。 - 调用
Process()执行流水。
流水任务设计
-
Vector 算子通常把一次完整处理拆为三个 Stage:
- CopyIn:Global Memory → Local Memory。
- Compute:Local Memory 中完成 Vector 计算。
- CopyOut:Local Memory → Global Memory。
-
当一份输入被切成多个 Progress 后,不同 Progress 可以处于不同 Stage,从而形成流水并行。例如:
时刻 1:CopyIn(P0) 时刻 2:Compute(P0) + CopyIn(P1) 时刻 3:CopyOut(P0) + Compute(P1) + CopyIn(P2) ... -
这使搬运单元和计算单元不必长期互相等待。
算子类的典型结构
class KernelAdd {
public:
    __aicore__ inline KernelAdd() {}
    __aicore__ inline void Init(...);
    __aicore__ inline void Process();

private:
    __aicore__ inline void CopyIn(int32_t progress);
    __aicore__ inline void Compute(int32_t progress);
    __aicore__ inline void CopyOut(int32_t progress);

private:
    TPipe pipe;
    TQue<QuePosition::VECIN,  BUFFER_NUM> inQueueX;
    TQue<QuePosition::VECIN,  BUFFER_NUM> inQueueY;
    TQue<QuePosition::VECOUT, BUFFER_NUM> outQueueZ;

    GlobalTensor<half> xGm;
    GlobalTensor<half> yGm;
    GlobalTensor<half> zGm;
};
- 这套结构的意义是把内存初始化、任务调度和三个流水阶段分离,后续修改切分策略或计算逻辑时更容易维护。
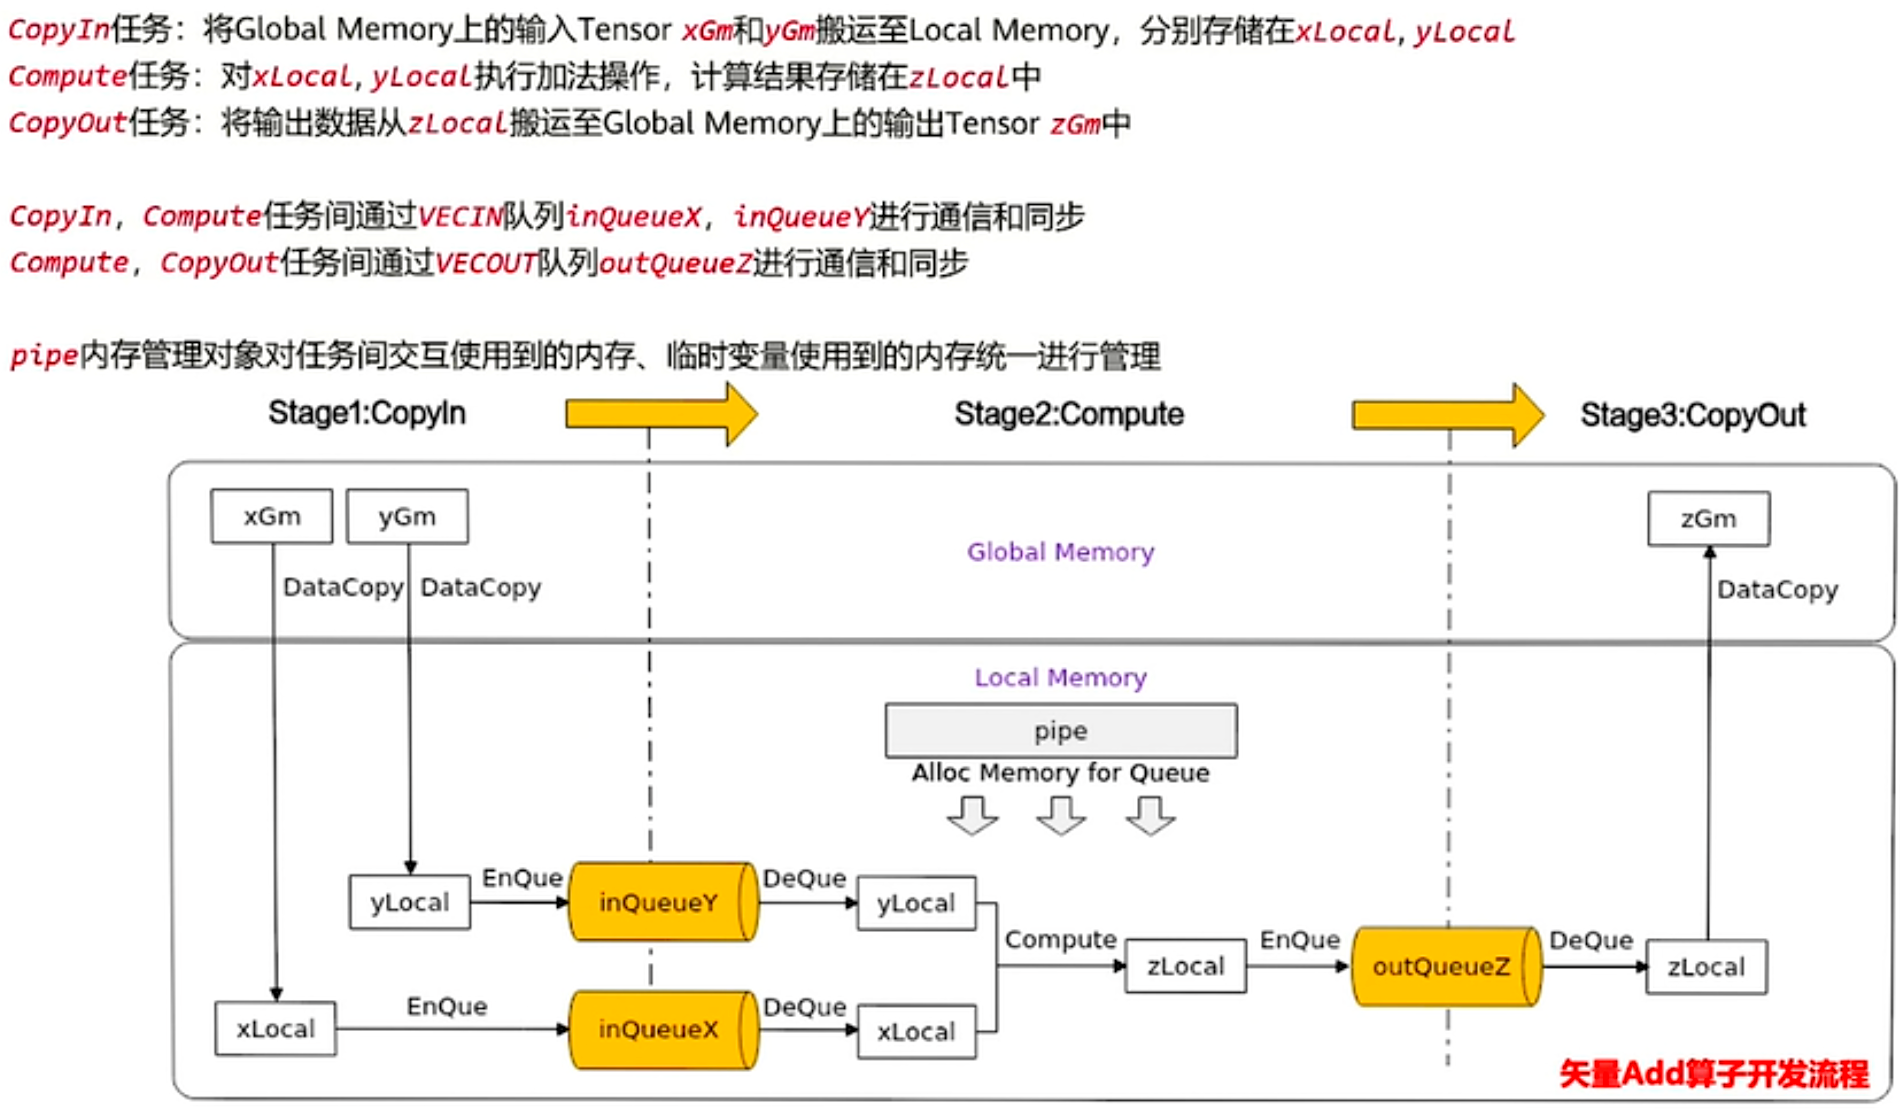
Vector 算子流水任务与数据通路
Init:完成多核切分与 Queue 初始化
-
对于固定 Shape,可以在代码中预先计算:
- 总元素数
TOTAL_LENGTH。 - 使用核数
BLOCK_DIM。 - 单核处理元素数
BLOCK_LENGTH。 - 单核内部 Tile 数
TILE_NUM。 - 双缓冲数量
BUFFER_NUM = 2。 - 单个 Tile 的元素数
TILE_LENGTH。
- 总元素数
-
block_idx决定当前核在 Global Memory 中的起始偏移:当前核起始位置 = block_idx × BLOCK_LENGTH -
之后用
SetGlobalBuffer()绑定当前核对应的x/y/z数据区间,并用pipe.InitBuffer()为 Queue 分配 Local Memory。
Process:循环执行流水任务
-
Process()通常按 Progress 循环:for (int32_t i = 0; i < loopCount; ++i) { CopyIn(i); Compute(i); CopyOut(i); } -
三个函数通过 Queue 建立数据依赖。
CopyIn
- 典型过程:
AllocTensor()获得 LocalTensor。DataCopy()把当前 Tile 从GlobalTensor搬入 LocalTensor。EnQue()把数据放入输入 Queue。
Compute
- 典型过程:
- 从输入 Queue
DeQue()取出xLocal、yLocal。 - 从输出 Queue
AllocTensor()获得zLocal。 - 调用
Add(zLocal, xLocal, yLocal, count)。 - 将
zLocalEnQue()到输出 Queue。 - 释放已经消费完的输入 LocalTensor。
- 从输入 Queue
CopyOut
- 典型过程:
- 从输出 Queue
DeQue()取得zLocal。 DataCopy()将结果写回 Global Memory。FreeTensor()释放输出 LocalTensor。
- 从输出 Queue
Double Buffer 机制
- Double Buffer 的核心是为流水阶段准备两组可交替使用的缓冲区。
- 没有 Double Buffer 时,一块 Local Memory 同时只能被一个阶段占用,CopyIn、Compute、CopyOut 容易互相等待。
- 采用双缓冲后:
- 当前 Tile 正在 Compute 时,可以为下一个 Tile 执行 CopyIn。
- 当前 Tile 正在 CopyOut 时,另一个 Tile 可以继续 Compute。
- 通过两个 Buffer 在不同 Stage 间轮换,降低硬件单元的空闲时间。
- 关键理解:Double Buffer 不是把数据“多算一遍”,而是用额外一份片上缓冲换取更高的流水并行度。
1-4 运行验证
- 一个完整的 Add Kernel 验证通常包括:
- 生成输入数据。
- 分配输入、输出内存。
- 调用核函数。
- 将结果写出。
- 用 CPU/NumPy 等参考实现计算 Golden 结果。
- 比较设备结果和 Golden 结果。
- Kernel 直调示例既可以运行 CPU 仿真,也可以运行 NPU。CPU 模式便于通过普通 C/C++ 调试方式定位逻辑问题;NPU 模式用于验证真实设备上的执行结果和性能行为。
2-Host侧实现
2-1 Host 侧实现概述
Host 与 Device
- 在典型昇腾算子运行环境中:
- Host:与 Device 相连的 x86/ARM 服务器,负责应用程序、运行时管理和 Host 侧算子逻辑。
- Device:安装昇腾 AI 处理器的设备,通过 PCIe 等接口与 Host 连接,提供 NPU 计算能力。
- Kernel 负责 Device 侧计算,而标准自定义算子还需要 Host 侧逻辑描述“怎么切、输出是什么、算子是什么”。
Host 侧三部分核心实现
- Host 侧主要包括:
- Tiling 实现:根据输入 Shape、数据类型和硬件资源计算切分参数。
- Shape 推导:根据输入 Tensor 描述和算子属性推导输出 Tensor 描述。
- 算子原型注册:定义输入、输出、数据类型、Format,并把 Tiling、Shape 推导等函数注册到算子。
- 可以把三者理解为:
- 算子原型注册:这个算子“是什么”。
- Shape 推导:输出“长什么样”。
- Tiling:运行时“怎么切、怎么并行”。
2-2 Tiling 下发
为什么需要 Tiling
- Local Memory 容量有限,通常无法一次放下算子的全部输入、输出数据。因此要把大 Tensor 切成多个较小的数据块,再分给多个核、多个 Tile 处理。
- Tiling 的目标是确定:
- 使用多少个 AI Core。
- 每个核处理多少数据。
- 每个核内部再切成多少 Tile。
- 单个 Tile 的大小。
- 尾块如何处理。
- 需要多少额外 Workspace。
- Tiling 通常在 Host CPU 上执行,因为它主要进行 Shape、长度和硬件资源相关的标量计算,不适合占用 AI Core。
Tiling 结构体
-
Tiling 结果需要从 Host 传到 Kernel,因此需要一种双方都能理解的数据结构。
-
简单 Add 示例可以只包含:
struct AddCustomTilingData { uint32_t totalLength; uint32_t tileNum; }; -
标准自定义算子工程中通常通过 Tiling 宏定义数据字段,例如:
BEGIN_TILING_DATA_DEF(AddCustomTilingData) TILING_DATA_FIELD_DEF(uint32_t, totalLength); TILING_DATA_FIELD_DEF(uint32_t, tileNum); END_TILING_DATA_DEF; -
Host 侧实例化并填充该结构,随后写入 Tiling Buffer;Kernel 侧读取同一份数据。
Tiling 函数的工作流程
- Tiling 函数一般完成以下工作:
- 从
TilingContext获取输入 Tensor 的 Shape 等信息。 - 计算总元素数。
- 决定
blockDim,即启用多少个 AI Core。 - 计算单核数据量、Tile 数和 Tile 大小。
- 设置 Workspace 大小(如果算子需要)。
- 把 TilingData 写入运行时提供的 Tiling Buffer。
- 设置实际 TilingData 长度并返回成功。
- 从
Kernel 侧读取 Tiling 信息
-
标准核函数通常把 Tiling 信息放在参数列表尾部,例如:
extern "C" __global__ __aicore__ void add_custom( GM_ADDR x, GM_ADDR y, GM_ADDR z, GM_ADDR workspace, GM_ADDR tiling) { GET_TILING_DATA(tilingData, tiling); KernelAdd op; op.Init(x, y, z, tilingData.totalLength, tilingData.tileNum); op.Process(); } -
易错点:标准工程中参数顺序通常按输入、输出、Workspace、Tiling 排列,不要随意调整。
固定 Shape 与动态 Shape
- 固定 Shape 时,很多切分参数可以编译期写成常量;动态 Shape 时,这些值必须由 Host 在运行时计算并下发。
| 对比项 | 固定 Shape | 动态 Shape |
|---|---|---|
| 输入 Shape | 编译前已确定 | 运行时变化 |
| 切分参数 | 可写为静态常量 | 需要由 Tiling 计算 |
| Kernel 中的数据长度 | 常量 | 成员变量 / TilingData |
| 灵活性 | 低 | 高 |
| Host 工作量 | 较少 | 较多 |
| 调优空间 | 针对固定输入优化 | 需要兼顾多种 Shape |
- 动态 Shape 改造的核心可以概括成:静态常量 → 由 Tiling 下发的成员变量
- 例如原来 Kernel 中写死的
BLOCK_LENGTH、TILE_NUM,动态 Shape 下应从tilingData得到。
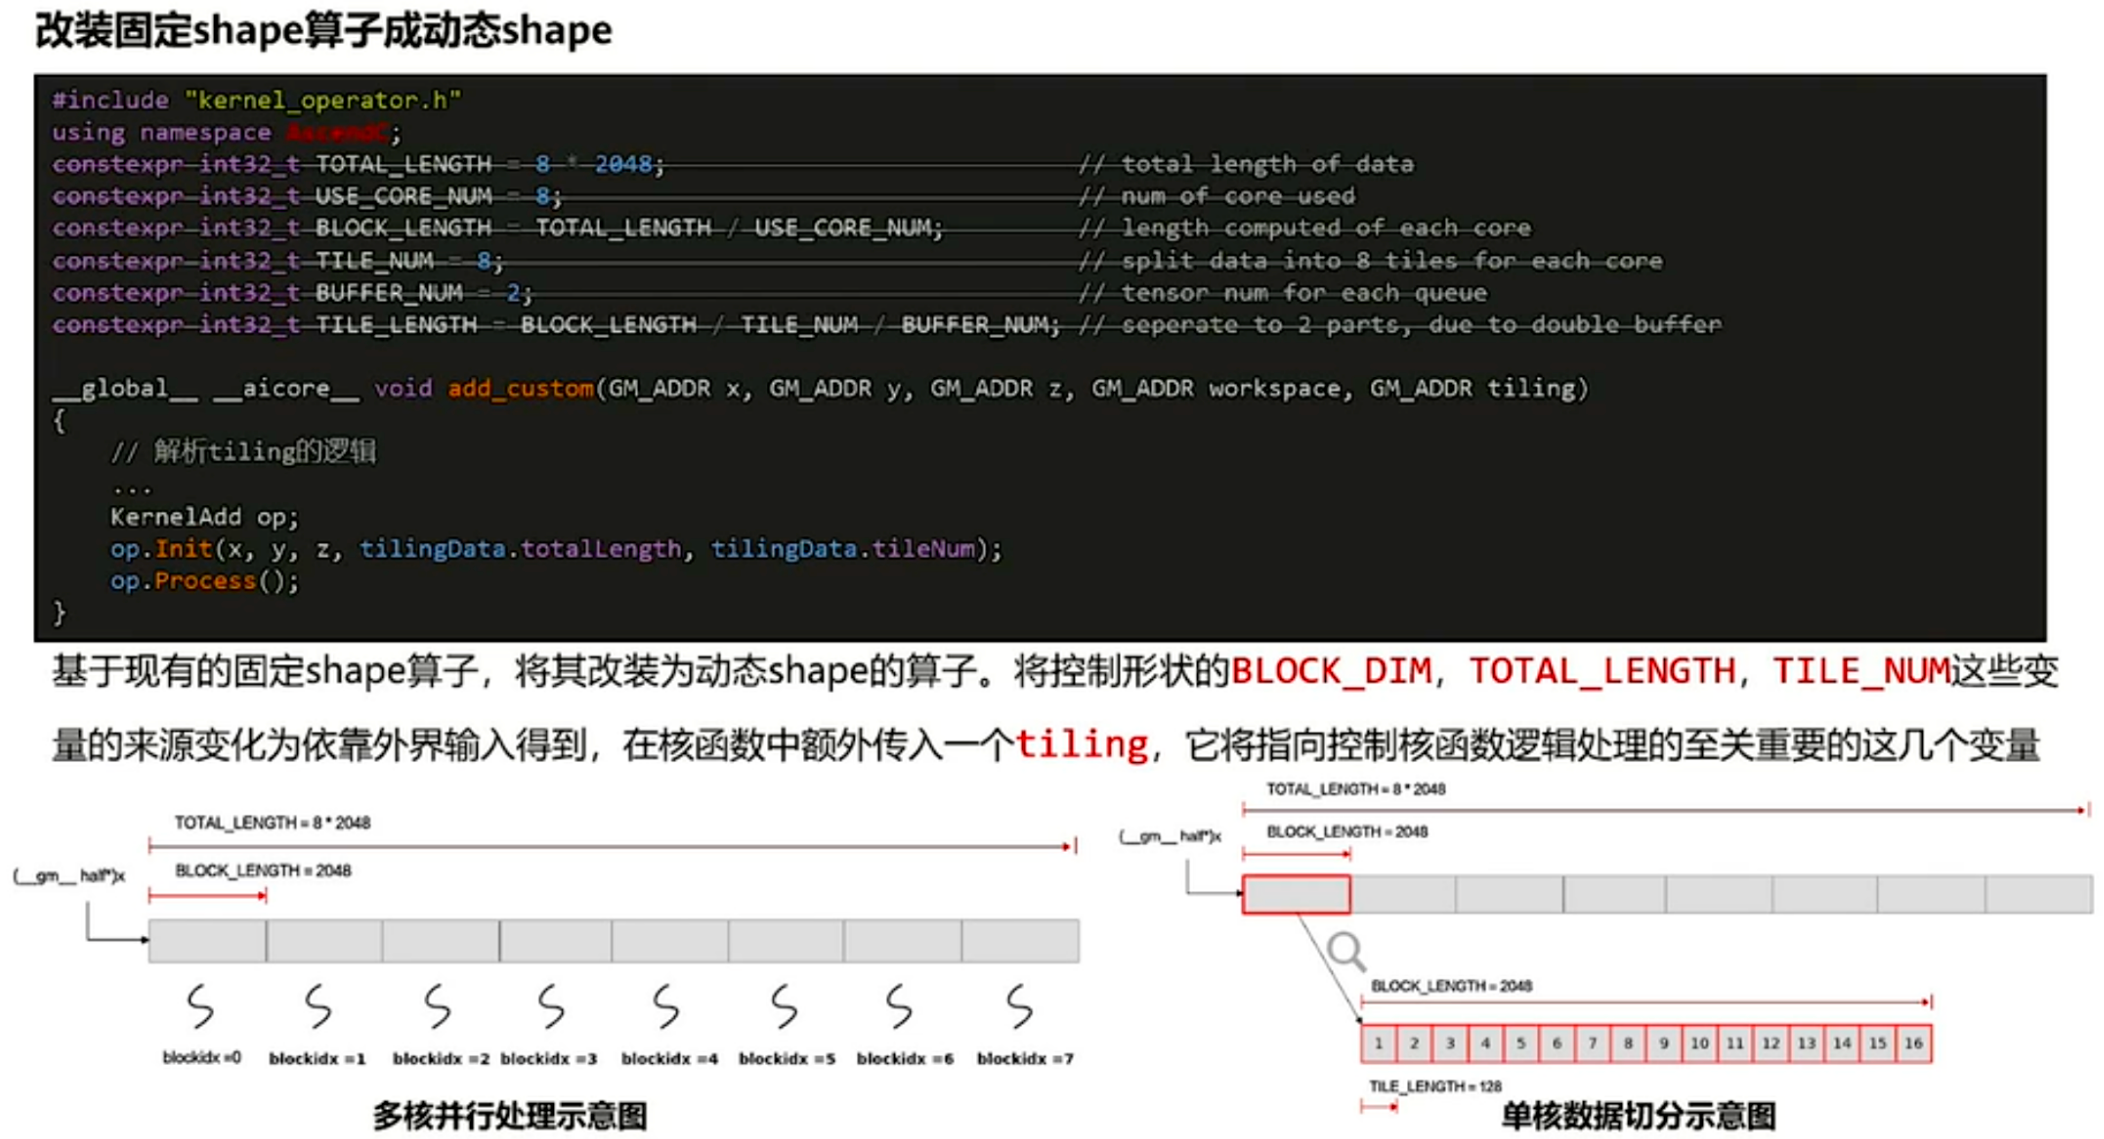
动态 Shape 的 Tiling 切分示意
固定 Shape 与动态 Shape 工程文件差异
| 文件 | 主要职责 | 固定 Shape | 动态 Shape |
|---|---|---|---|
main.cpp | Host 测试程序、内存申请、任务下发 | 读取固定输入即可 | 需要准备并下发 Tiling 信息 |
add_custom.cpp | Ascend C Kernel 实现 | Shape 参数常量化 | 从 Tiling 获取切分参数 |
add_custom.py | 输入和 Golden 数据生成 | 生成固定 Shape 数据 | 同时生成对应 Tiling 数据/动态输入 |
CMakeLists.txt | 工程编译配置 | 基本不变 | 基本不变 |
data_utils.h | Host 数据读写等辅助能力 | 基本不变 | 基本不变 |
run.sh | 一键运行脚本 | 基本不变 | 基本不变 |
add_custom_tiling.h | Tiling 数据结构 | 可以不涉及 | 定义/解析 Tiling 数据 |
2-3 Shape 推导
Shape 推导的意义
- 神经网络可以看作一个有向无环计算图,每一个结点都是一个算子。当前算子的输出通常又会作为后续算子的输入,因此运行前需要尽可能确定每个输出 Tensor 的描述信息。
- Shape 推导根据:
- 输入 Tensor 的 Shape。
- 输入 Tensor 的数据类型、Format。
- 算子属性。
- 算子的数学语义。
- 推导输出 Tensor 的 Shape 等信息。
Shape 推导的作用
- 参数校验:尽早发现输入不满足算子约束的问题。
- 输出描述推导:确定输出 Shape、dtype、Format 等信息。
- 静态内存规划:计算图构建阶段即可为已知 Tensor 分配内存,减少运行时动态分配开销。
-
对于逐元素 Add,如果输入
x、yShape 已经满足广播/匹配要求,最简单场景下输出 Shape 与输入 Shape 相同。 -
概念代码:
static ge::graphStatus InferShape(gert::InferShapeContext* context)
{
    const gert::Shape* xShape = context->GetInputShape(0);
    gert::Shape* zShape = context->GetOutputShape(0);
    *zShape = *xShape;
    return ge::GRAPH_SUCCESS;
}
2-4 原型注册
-
算子原型注册用于完整描述算子的“接口契约”,主要包括:
- 算子名称。
- 输入名称与数量。
- 输出名称与数量。
- 参数是否必选。
- 支持的数据类型。
- 支持的 Format。
- Shape 推导函数。
- Tiling 函数。
- 对应的 AI Core / SoC 配置。
-
Add 示例可抽象为:
OpType: Add Inputs: x: required, float16, ND y: required, float16, ND Output: z: required, float16, ND Host Functions: InferShape Tiling AI Core Config: 对应目标 SoC -
Host 侧原型、Shape 推导与 Tiling 最终在同一个算子定义中关联起来,使框架能够完成算子发现、校验、编译与运行。
3-算子开发工程
3-1 算子开发工程概述
- Kernel 和 Host 都写完后,还需要解决四个工程问题:
- 怎样组织代码和目录?
- 怎样编译 Kernel 与 Host?
- 怎样生成可安装的算子包?
- 怎样部署到运行环境?
- Ascend C 提供两种典型开发工程。
Kernel 直调工程:快速流程
- 适合:
- 学习 Ascend C Kernel。
- 快速验证算法逻辑。
- 调试 Kernel。
- 不希望先编写完整 Host 侧标准算子工程。
- 特点:
- 文件少。
- 开发周期短。
- Kernel 开发完成后可以直接写 Host 测试程序调用。
- Tiling 可以简单处理,不依赖完整 CANN 标准算子注册流程。
自定义算子工程:标准流程
- 适合:
- 正式开发可部署算子。
- 需要框架调用。
- 需要 Host 侧原型注册、Shape 推导、Tiling。
- 需要生成算子安装包。
- 后续需要通过 AscendCL、PyTorch Adapter 等方式调用。
- 特点:
- 工程文件更多。
- 开发流程更完整。
- 可以通过工程脚本统一完成编译、打包和部署。
3-2 快速流程——Kernel 直调工程
Kernel 直调的核心思想
-
Kernel 直调就是:Kernel 写完后,不先构建完整自定义算子包,而是直接写一个 Host 测试程序调用核函数。
-
最简工程只需要:
project/ ├── cmake/ ├── CMakeLists.txt ├── my_add.cpp # Kernel 实现 └── main.cpp # 直接调用 Kernel 的测试程序 -
为了形成完整的自动验证流程,通常进一步加入:
project/
├── cmake/
│   ├── cpu_lib.cmake
│   └── npu_lib.cmake
├── scripts/
│   ├── gen_data.py
│   └── verify_result.py
├── CMakeLists.txt
├── add_custom.cpp
├── data_utils.h
├── main.cpp
└── run.sh
CPU 与 NPU 两种验证路径
- Kernel 直调支持两类运行方式:
- CPU 调测:使用 CPU 仿真相关接口,例如
ICPU_RUN_KF,适合快速调试逻辑。 - NPU 调测:使用核函数调用语法或 AscendCL Runtime API,在真实 NPU 上执行。
- CPU 调测:使用 CPU 仿真相关接口,例如
- CPU 调测可以使用常规 C/C++ 手段,例如:
gdbprintfstd::cout
- NPU 调测更关注:
printfDumpTensor- 真实硬件行为与执行结果
run.sh 的典型流程
生成输入与 Golden 数据
        ↓
CMake 配置 CPU/NPU 构建
        ↓
编译 Kernel 与测试程序
        ↓
运行测试程序
        ↓
生成输出数据
        ↓
verify_result.py 对比 Golden
- Kernel 直调的价值在于减少工程噪声,让开发者先集中验证 Kernel 本身。
3-3 标准流程——自定义算子工程
标准流程与快速流程对比
| 项目 | 快速开发模式 | 标准开发模式 |
|---|---|---|
| 代码文件 | 少 | 多 |
| 开发周期 | 短 | 长 |
| Host 侧实现 | 简化 | 完整:原型、Shape、Tiling 等 |
| 调用方式 | Kernel 直调 | 单算子 API / 模型 / 框架调用 |
| 适用阶段 | 学习、验证、快速调试 | 正式集成、部署和发布 |
| 推荐顺序 | 先 | 后 |
Add 算子分析
-
Add 的数学表达式:
z = x + y z = x + y z=x+y
-
实现时需要明确:
- 输入:
x、y。 - 输出:
z。 - 示例 dtype:
half。 - 示例 Shape:
(8, 2048)。 - 示例 Format:
ND。 - 搬运 API:
DataCopy。 - 计算 API:
Add。 - 内部数据对象:
LocalTensor。 - 流水管理:
Queue、EnQue、DeQue。
- 输入:
使用 msopgen 创建算子工程
- CANN 提供
msopgen工具,可根据算子描述 JSON 自动生成标准工程骨架。 - 基本步骤:
- 编写算子描述 JSON。
- 使用
msopgen生成工程。 - 在生成的 Kernel 目录中完成设备侧实现。
- 在 Host 目录中完成原型、Shape 推导和 Tiling。
- 编译并生成安装包。
- 算子描述 JSON 重点包含:
- 算子名称。
- 输入列表。
- 输出列表。
- Shape/Format 约束。
- dtype 约束。
标准工程的主要目录
-
标准工程一般可以概括为:
custom_op/ ├── op_host/ # Host 侧:原型、Shape、Tiling ├── op_kernel/ # Ascend C Kernel ├── scripts/ # 辅助脚本 ├── CMakeLists.txt ├── CMakePresets.json └── build.sh -
Kernel 与 Host 被分别编译,随后由工程脚本打包成自定义算子安装包。
Kernel 侧实现
-
标准工程中的 Kernel 仍然遵循:
CopyIn → Compute → CopyOut -
与快速工程的主要区别不是计算逻辑本身,而是:
- 切分参数从 TilingData 获取。
- Kernel 与 Host 原型建立正式关联。
- 编译产物进入自定义算子包。
Host 侧 TilingData 定义
-
标准工程中可通过宏定义 TilingData:
BEGIN_TILING_DATA_DEF(AddCustomTilingData) TILING_DATA_FIELD_DEF(uint32_t, totalLength); TILING_DATA_FIELD_DEF(uint32_t, tileNum); END_TILING_DATA_DEF; -
随后注册 TilingData 类型,并由 Host 的 Tiling 函数填充。
工程编译
-
编译阶段主要完成:
- Kernel 源码编译。
- Host 源码编译。
- Tiling / 原型相关代码编译。
- 生成自定义算子安装包
.run。
-
常见 CMake 配置项包括:
配置项 作用 ASCEND_CANN_PACKAGE_PATH指定 CANN 安装路径 CMAKE_BUILD_TYPERelease/Debug等构建类型ENABLE_SOURCE_PACKAGE是否生成源码相关包 ENABLE_BINARY_PACKAGE是否生成二进制相关包 vendor_name自定义算子厂商/包命名信息 -
工程通常通过
build.sh完成构建,并在build_out等目录生成安装包。
算子包部署
- 编译完成后执行生成的
.run安装包,将自定义算子部署到目标环境。 - 部署后的文件通常按功能分布到:
- Host 配置与算子原型相关目录。
- Kernel 二进制/源码相关目录。
- Tiling、配置、版本等辅助目录。
- 这样运行时和框架才能发现并加载自定义算子。
4-API通用解读
4-1 Ascend C 编程 API 概述
Ascend C API 可以按抽象层次分为两类:
基础 API
- 基础 API 更贴近硬件能力,主要包括:
- 计算 API。
- 数据搬运 API。
- 内存管理 API。
- 任务同步 API。
- 基础 API 的输入输出通常围绕
GlobalTensor与LocalTensor展开,灵活度高,适合自己设计数据通路和计算过程。
高阶 API
- 高阶 API 对常见复杂算法进行进一步封装,例如:
- Matmul。
- Softmax。
- Sinh 等数学函数。
- 使用高阶 API 可以减少重复开发,但通常需要根据接口要求准备临时空间、参数对象或初始化流程。
4-2 基础 API
基础 API 四大类
| API 类型 | 作用 | 常见接口 |
|---|---|---|
| 计算 API | 在 Local Memory 上完成计算 | Add 等 Vector API |
| 数据搬运 API | 在不同存储位置之间搬运数据 | DataCopy |
| 内存管理 API | 管理 Local Memory / Queue 缓冲 | InitBuffer、AllocTensor、FreeTensor |
| 任务同步 API | 管理流水任务的数据依赖 | EnQue、DeQue |
计算 API 的三种使用层次
整个 Tensor 参与计算
-
最简单的写法直接对整个 LocalTensor 计算,例如:
Add(dstLocal, src0Local, src1Local, count); -
适合连续数据和简单逐元素计算。
Tensor 前 N 个元素参与计算
- 当只需要处理当前 Tile 中的部分有效数据时,可以通过
count控制实际元素数。
Tensor 高维切分计算
- 更复杂的 Vector API 可以通过以下参数控制多轮计算:
repeatTimesrepeatStrideblockStridemask
- 它们用于表达跨 block、跨 repeat 的规则访问方式。
repeatTimes
- Vector 计算单元一次 Repeat 可处理若干连续 block。典型向量场景中:
- 一个 block 为 32 Byte。
- 一次 Repeat 可覆盖 8 个 block,即 256 Byte。
- 数据超过一次 Repeat 的容量时,通过
repeatTimes增加重复次数。 repeatTimes的有效范围存在上限,设计 Tile 时要避免单次调用超过接口限制。
- 例如 16 个 block 的连续数据,可分成 2 次 Repeat 处理。
repeatStride
repeatStride描述相邻 Repeat 起始位置之间的地址跨度。- 常见用途:
- 连续计算:下一个 Repeat 紧接上一个 Repeat。
- 间隔计算:不同 Repeat 之间存在空洞。
- 重复计算:stride 为 0 时,可反复读取同一片数据。
blockStride
-
blockStride描述同一次 Repeat 内不同 block 之间的地址跨度。 -
因此要区分:
blockStride  —— Repeat 内部不同 block 的跨度
repeatStride —— 不同 Repeat 之间的跨度
Mask:连续模式
- Mask 决定一次向量指令中哪些元素真正参与计算。
- 连续模式直接指定前多少个元素有效:
- 16 bit 数据单次可覆盖的元素数更多。
- 32 bit 数据单次可覆盖的元素数相应减少。
- 适合“前 N 个元素有效”的场景。
Mask:逐 bit 模式
-
逐 bit Mask 用位图描述元素是否参与计算:
bit = 1 → 对应元素参与计算 bit = 0 → 对应元素不参与计算 -
适合非连续选取元素的场景。
-
理解重点:
repeatTimes / repeatStride / blockStride / mask共同描述一次 Vector API 如何在 Local Memory 中“走地址”。
数据搬运 API:DataCopy
-
常见搬运方向包括:
- GM → Vector 输入区。
- Vector 输出区 → GM。
- GM → Cube 输入相关位置。
- Cube 计算结果位置 → GM。
- 不同片上逻辑位置之间的搬运。
-
对于最常见的连续数据:
DataCopy(dstLocal, srcGlobal, count); -
复杂二维/跨步搬运可以使用
DataCopyParams。
DataCopyParams
| 参数 | 含义 |
|---|---|
blockCount | 连续搬运的数据块数量 |
blockLen | 每个数据块的长度,通常以 32 Byte data block 为单位 |
srcStride | 源侧相邻数据块之间需要跳过的间隔 |
dstStride | 目的侧相邻数据块之间需要跳过的间隔 |
-
可以把二维搬运理解成:
重复 blockCount 次:
    连续搬 blockLen
    源地址跳 srcStride
    目的地址跳 dstStride
内存管理 API
-
TPipe负责管理片上内存资源,TQue表示某个流水阶段使用的 Queue。 -
典型流程:
TPipe pipe;
TQue<QuePosition::VECOUT, 2> que;

pipe.InitBuffer(que, num, len);

LocalTensor<half> tensor = que.AllocTensor<half>();
// 使用 tensor
que.FreeTensor(tensor);
EnQue / DeQue
EnQue()与DeQue()不只是普通容器操作,而是流水阶段间的同步机制。
// Producer
queue.EnQue(tensor);

// Consumer
LocalTensor<half> tensor = queue.DeQue<half>();
- Producer 把准备好的 Tensor 放入 Queue,Consumer 在数据可用后取出,从而维持 Stage 之间正确的数据依赖关系。
4-3 高阶 API
高阶 API 的价值
- 高阶 API 封装了常见算法的复杂实现。以 Matmul 为例,开发者通常只需要:
- 创建 Matmul 对象。
- 初始化。
- 设置左矩阵 A。
- 设置右矩阵 B 和 Bias 等参数。
- 执行矩阵乘。
- 结束计算。
- 相比手工组织 Cube 指令、搬运和同步,高阶 API 可以显著减少代码量。
高阶 API 的临时空间
-
部分高阶 API 需要额外临时空间。例如 Sinh 接口可能需要
sharedTmpBuffer保存中间结果。 -
接口一般提供两种使用方式:
- 开发者显式传入临时空间。
- 使用无需显式临时空间参数的重载,由接口内部处理。
-
为了更好控制片上内存,Host 可以先计算高阶 API 所需临时空间的最小值和最大值,再把选择结果作为 Tiling 参数下发。
-
概念流程:
Host:根据 Shape / dtype 查询临时空间范围 ↓ 选择合适的 sharedTmpBuffer 大小 ↓ 写入 TilingData ↓ Kernel:按 TilingData 申请 Local Memory ↓ 调用高阶 API -
在允许范围内增大临时空间,有时可以带来更好的计算性能,但也会占用更多片上内存,因此需要在性能与内存之间权衡。
5-算子的多种调用方式
5-1 算子调用概述
两类工程对应两类调用体系
- 不同开发方式支持的调用路径不同。
- Kernel 直调工程:重点是直接调用核函数,适合开发和快速验证。
- 自定义算子工程:完成正式编译部署后,可以通过 AscendCL、模型执行或 PyTorch Adapter 等方式调用。
常见调用方式对比
| 工程 | 调用方式 | 运行硬件 | 典型用途 | 常见调试手段 |
|---|---|---|---|---|
| Kernel 直调 | ICPU_RUN_KF | CPU | CPU 仿真调试 | gdb、printf、std::cout |
| Kernel 直调 | <<<...>>> 核函数调用 | NPU | 快速 NPU 验证 | printf、DumpTensor |
| Kernel 直调 | Runtime Kernel Launch | NPU | 通过运行时拉起 Kernel | printf、DumpTensor |
| 自定义算子工程 | 单算子 API(aclnn) | NPU | 应用直接调用单算子 | printf、DumpTensor |
| 自定义算子工程 | aclopExecuteV2 | NPU | 单算子模型执行 | printf、DumpTensor |
| 自定义算子工程 | PyTorch Adapter / op-plugin | NPU | PyTorch 框架调用 | PyTorch 测试 + NPU 调试 |
- 推荐开发顺序:
- 先在 CPU 侧验证算法和基本逻辑。
- 再用 Kernel 直调在 NPU 上验证。
- 最后切换到正式工程和框架调用。
5-2 Kernel 直调
CPU 侧运行
-
CPU 仿真模式的基本流程:
- 为输入、输出申请共享内存。
- 从文件读取输入数据。
- 通过 CPU Kernel 调用宏执行核函数。
- 把输出写入文件。
- 释放共享内存。
-
常见接口:
接口 用途 GmAlloc(size)为 CPU 调测创建共享内存 ICPU_RUN_KF(...)在 CPU 仿真环境调用 Kernel GmFree(ptr)释放共享内存
NPU 侧运行
- NPU 模式通常需要:
- 初始化 AscendCL。
- 设置 Device。
- 创建 Context / Stream。
- 申请 Host / Device 内存。
- 把输入从 Host 拷到 Device。
- 拉起 Kernel。
- 把输出从 Device 拷回 Host。
- 同步 Stream。
- 释放内存、Stream、Context、Device。
- 因为 Kernel 调用通常是异步的,所以读取结果前要确保对应 Stream 已经同步完成。
输入数据生成
gen_data.py通常负责:- 用 NumPy 随机生成
input_x、input_y。 - 计算
golden = input_x + input_y。 - 将输入与 Golden 结果写成
.bin文件。
- 用 NumPy 随机生成
- 这样 Host 测试程序只负责读取二进制数据并执行 Kernel。
结果校验
verify_result.py读取:- NPU/CPU Kernel 实际输出。
- Golden 输出。
- 再使用容差比较,判断结果是否通过。
Kernel 直调也可以使用 Tiling
- Kernel 直调并不意味着不能使用 Tiling。
- 与标准工程相比,Kernel 直调更自由:
- Tiling 数据可以自己定义结构体。
- 不一定要使用标准 Host 侧 Tiling 注册流程。
- 调用 Kernel 前直接构造 Tiling 数据并传入即可。
- Kernel 参数也不一定必须写成统一的
GM_ADDR tiling形式,只要调用端和 Kernel 端保持一致。
- 因此它很适合先验证复杂切分逻辑,再迁移到标准工程。
5-3 通过 Ascend CL 调用算子
AscendCL 单算子调用的两种方式
- 完成标准自定义算子开发和部署后,可以使用 AscendCL 执行单算子。
- 主要有两种方式:
- 单算子 API 执行(aclnn):直接调用生成的单算子 API。
- 单算子模型执行:先把算子描述编译成离线模型,再用
aclopExecuteV2等接口执行。
两种方式的工程要求
| 项目 | 单算子 API 执行 | 单算子模型执行 |
|---|---|---|
| Kernel 实现 | 必须 | 必须 |
| 原型注册 | 必须 | 必须 |
| Shape 推导 | 可不依赖 | 必须 |
| Tiling | 必须 | 必须 |
| 算子源码编译 | 不作为主要路径 | 开启 |
| 算子二进制编译 | 开启 | 不作为主要路径 |
源码编译与二进制编译
二进制编译
- 会对 Kernel 实现进行编译,生成:
- 算子描述信息。
- 相关 JSON。
- 算子二进制文件。
- 适合直接调用已经编译好的单算子二进制。
源码编译
- 保留 Kernel 源码,不预先把 Kernel 固化为最终二进制。模型转换阶段可由 ATC 等工具结合目标环境进行编译。
- 适合算子随模型一起转换、编译和加载的场景。
单算子 API(aclnn)调用
-
自定义算子二进制编译部署后,会生成相应的单算子 API。API 常采用两段式:
aclnnStatus aclnnXxxGetWorkspaceSize(
    ...,
    uint64_t* workspaceSize,
    aclOpExecutor** executor);

aclnnStatus aclnnXxx(
    void* workspace,
    uint64_t workspaceSize,
    aclOpExecutor* executor,
    aclrtStream stream);
第一阶段:GetWorkspaceSize
- 作用:
- 校验参数。
- 计算本次执行需要的 Workspace 大小。
- 创建/返回执行器
executor。
第二阶段:执行接口
-
作用:
- 根据
workspaceSize准备 Device Workspace。 - 传入
executor和 Stream。 - 异步执行算子。
- 根据
-
典型调用顺序:
创建输入/输出 Tensor
        ↓
GetWorkspaceSize
        ↓
按需申请 Workspace
        ↓
aclnnXxx(..., stream)
        ↓
SynchronizeStream
单算子 API 调用程序编译
- 调用程序需要在 CMake 中配置:
- 自定义算子包的 include 目录。
- 自定义算子包的 lib 目录。
- AscendCL 相关 include/lib。
- 自定义单算子 API 库。
- 运行时依赖库。
- 最终生成调用程序后,即可直接调用安装好的自定义算子。
单算子模型执行
-
另一种方式是把算子先转成离线模型。
-
流程:
准备单算子 JSON 描述 ↓ ATC 编译 ↓ 生成 .om 离线模型 ↓ 设置模型目录 ↓ 调用 aclopExecuteV2 ↓ 同步并读取结果 -
关键接口包括:
aclopSetModelDir(...); aclopExecuteV2(...); -
JSON 描述需要明确:
- 算子类型。
- 输入名称。
- 输入 Shape。
- 输入 dtype。
- 输入 Format。
- 输出描述。
-
ATC 的核心参数包括:
-singleop:单算子描述 JSON。-output:输出模型目录/前缀。-soc_version:目标 AI 处理器型号。
5-4 通过 PyTorch 调用算子
PyTorch 适配的总体思路
- PyTorch 在训练和推理中会调用大量算子。Ascend Extension for PyTorch 的
op-plugin提供算子适配机制,把 PyTorch 算子映射到昇腾侧实现。 - 适配主要包含两部分:
- 算子注册分发:在 YAML 中描述算子定义和后端映射关系。
- 适配插件实现:编写 C++ 适配代码,在 PyTorch 接口与昇腾单算子 API 之间做参数转换和调用。
工程准备
-
示例工程通常包含:
PYTORCHINVOCATION/ ├── op_plugin_patch/ │ ├── AddCustomKernelNpuApi.cpp │ └── op_plugin_functions.yaml ├── run_op_plugin.sh └── test_ops_custom.py -
C++ 适配层主要完成:
- 接收 PyTorch Tensor。
- 创建输出 Tensor。
- 调用昇腾侧单算子 API。
- 返回 PyTorch Tensor。
算子注册分发配置
op_plugin_functions.yaml用来描述:- 算子是否属于官方算子或自定义算子。
func:算子的函数签名,包括名称、输入和返回值。impl_ns:指定后端实现所对应的命名空间/调用路径。
- 对于自定义算子,需要先在该配置中加入函数定义,再为其提供实际 C++ 实现。
op-plugin 编译部署
-
基本过程:
- 获取
op-plugin源码。 - 合入自定义算子的 C++ 实现和 YAML 配置。
- 重新编译
op-plugin。 - 安装生成的 Python wheel 包。
- 在 PyTorch 中调用并验证。
- 获取
-
示例安装流程可概括为:
cd op-plugin
bash ci/build.sh --python=<python_version>
pip3 install dist/*.whl --force-reinstall
PyTorch 调用测试
-
测试脚本通常:
-
创建 CPU/PyTorch 参考输入。
-
把输入移动到 NPU。
-
调用注册后的自定义算子,例如:
output = torch_npu.npu_add_custom(x_npu, y_npu) -
把结果转回 CPU。
-
与参考结果比较。
-
-
完整链路因此是:
PyTorch Python API
        ↓
op-plugin 注册分发
        ↓
C++ Adapter
        ↓
aclnn 单算子 API
        ↓
自定义 Ascend C Kernel
6-非对齐尾块处理
问题背景
-
前面的 Add 示例使用
(8, 2048)的halfTensor,可以比较自然地按多个 AI Core 平均切分,且每块数据容易满足 32 Byte 对齐。 -
如果输入变成:
Shape = (1, 660) dtype = half 使用 4 个 AI Core- 情况就不同了。
-
half占 2 Byte,因此真实输入数据大小为:660 × 2 Byte = 1320 Byte -
Ascend C 的很多数据搬运和向量计算要求按 32 Byte block 组织数据:
1 block = 32 Byte = 16 个 half -
1320 Byte 不是 32 Byte 的整数倍,需要向上对齐:
ceil(1320 / 32) = 42 blocks 42 × 32 Byte = 1344 Byte -
即从元素角度看,相当于:
42 × 16 = 672 个 half 的对齐空间 -
其中:
- 660 个是真实数据。
- 12 个只是对齐后的尾部空间,不应该作为有效输出参与最终语义。
多核切分:不能再简单平均
-
42 个 block 要分配给 4 个 AI Core:
42 / 4 = 10 ... 2 -
因此可以采用:
- 2 个“大核”:每核处理 11 block。
- 2 个“小核”:每核处理 10 block。
-
即:
11 + 11 + 10 + 10 = 42 blocks
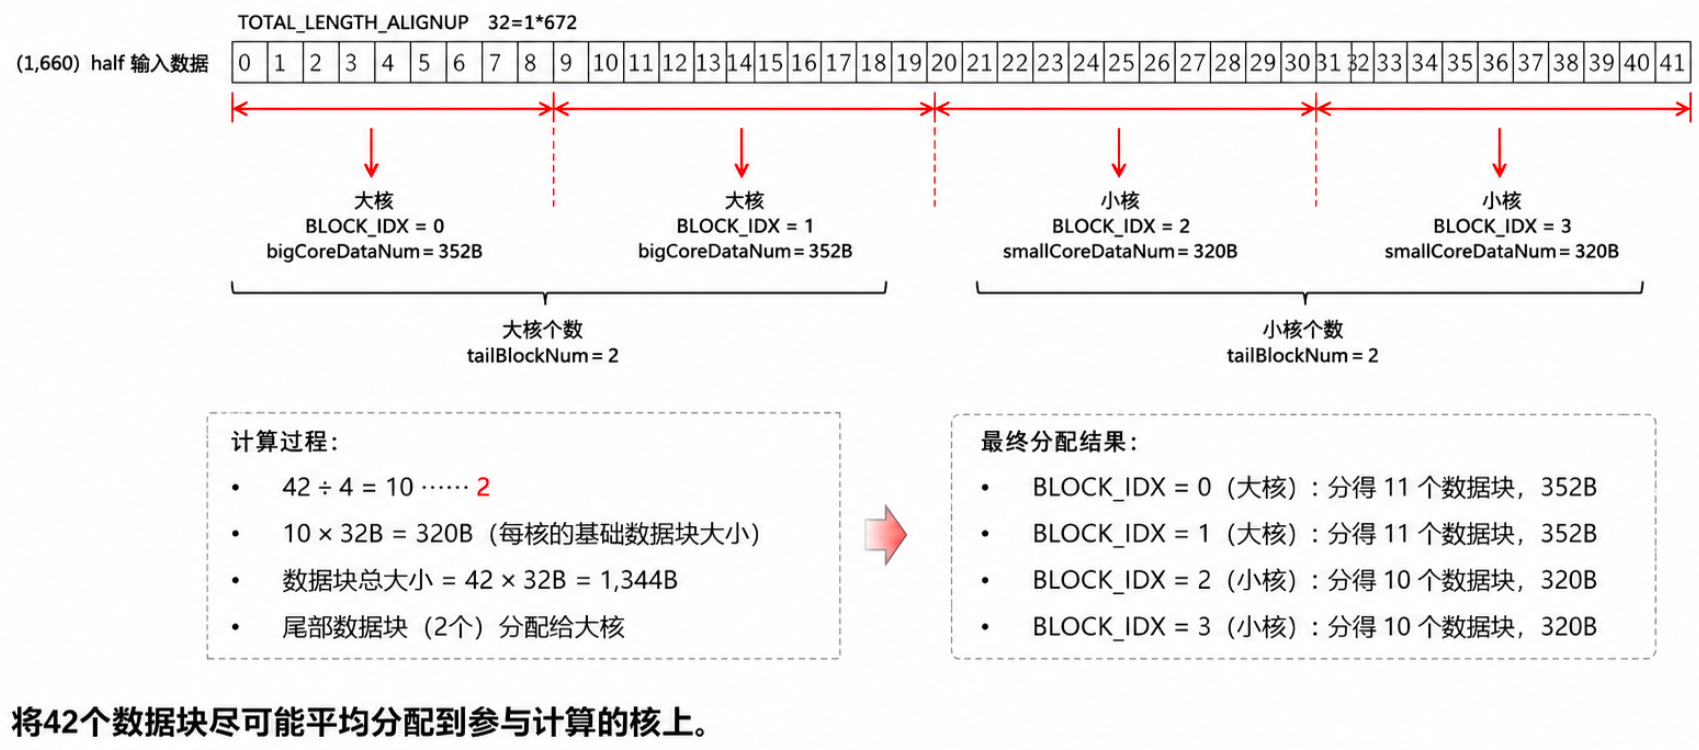
非对齐数据的多核切分
-
这意味着 Kernel 中不能再假定:
每个 block_idx 的 blockLength 完全相同 -
而要根据
block_idx判断当前属于大核还是小核,从 TilingData 中读取不同的数据长度。
单核内部还要受 UB 容量限制
-
即使已经把数据分到多个核,每个核一次能处理多少数据还受到 Local Memory / UB 大小限制。
-
因此需要再次把单核数据切成多个 Tile:
全局 Tensor ↓ 多核切分 Core0 / Core1 / Core2 / Core3 ↓ 单核内按 UB 切分 Tile0 / Tile1 / ... / TailTile -
大多数 Tile 可以使用相同长度,最后一个 Tile 可能是尾块。
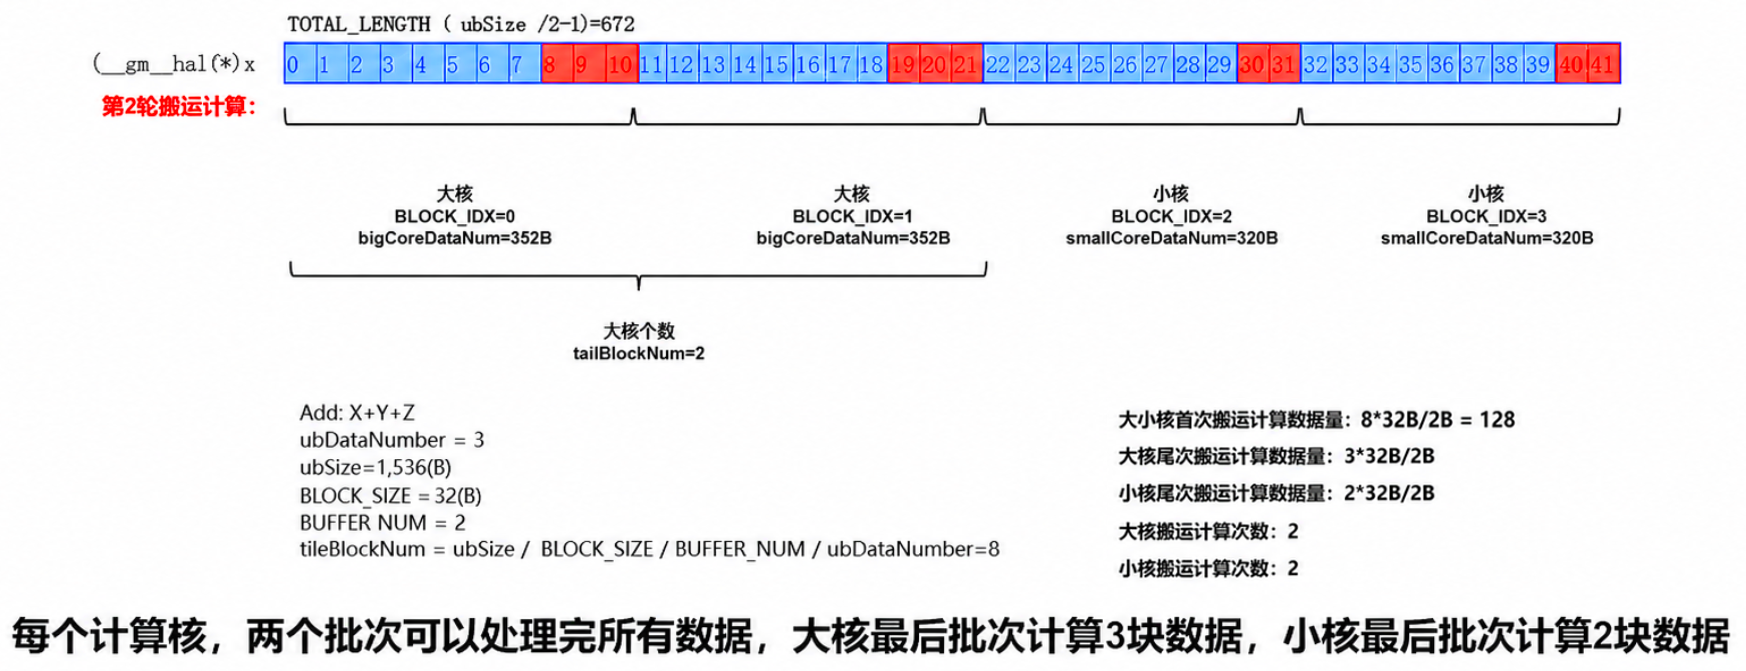
单核内按 UB 继续切分
复杂 TilingData 的设计
-
为了让 Kernel 正确处理“大核/小核 + 普通 Tile/尾 Tile”,Host 侧需要下发更多信息。
-
典型字段包括:
字段 含义 smallCoreDataNum小核总处理数据量 bigCoreDataNum大核总处理数据量 finalSmallTileNum小核最后一个 Tile 的有效数据量/相关切分参数 finalBigTileNum大核最后一个 Tile 的有效数据量/相关切分参数 tileDataNum普通 Tile 的数据量 smallTailDataNum小核尾 Tile 的有效数据量 bigTailDataNum大核尾 Tile 的有效数据量 tailBlockNum尾部对齐处理所需 block 数等尾块信息 -
具体字段可以根据实现调整,核心目标是让 Kernel 能回答三个问题:
- 我这个核要处理多少数据?
- 我要循环多少个普通 Tile?
- 最后一个 Tile 到底有多少有效元素?
Host 侧复杂 Tiling 的计算思路
1. 获取 Shape 和 dtype
-
Host 从
TilingContext获取输入 Shape 和数据类型,计算:真实元素数 真实字节数 单元素字节数
2. 按 32 Byte 对齐
alignedBytes = AlignUp(realBytes, 32)
totalBlocks  = alignedBytes / 32
3. 根据核数分配 block
-
假设使用
coreNum个核:baseBlocks = totalBlocks / coreNum remainder = totalBlocks % coreNum- 前
remainder个核多拿 1 block。 - 其余核拿
baseBlocks个 block。
- 前
-
由此得到大核和小核的处理长度。
4. 根据 UB 大小计算 Tile
-
再根据可用 UB 大小、双缓冲数量和 dtype 计算普通 Tile 能放多少元素。
单 Tile 可用字节数
        ↓
换算成元素数
        ↓
保证满足 DataCopy / Vector API 对齐要求
5. 计算尾 Tile
-
分别计算大核和小核:
完整 Tile 数 最后一个 Tile 的实际数据量 最后一个 Tile 对齐后的搬运量 -
这些值全部写入 TilingData 下发给 Kernel。
Kernel 侧处理逻辑
-
Kernel 的
Init()不再使用一套固定常量,而是:- 读取 TilingData。
- 获取
block_idx。 - 判断当前是大核还是小核。
- 计算当前核的 GlobalTensor 起始偏移。
- 确定本核普通 Tile 数与尾 Tile 长度。
- 初始化 Queue/Buffer。
-
伪代码:
if (GetBlockIdx() < bigCoreCount) { blockLength = bigCoreDataNum; tailLength = bigTailDataNum; } else { blockLength = smallCoreDataNum; tailLength = smallTailDataNum; } -
Process()中普通 Tile 可以复用原来的 CopyIn → Compute → CopyOut 逻辑;最后一个 Tail Tile 则需要使用实际有效元素数处理。
为什么要区分“搬运长度”和“有效计算长度”
-
尾块处理最容易混淆的地方是:
- 搬运可能需要满足 32 Byte 对齐。
- 真实数学计算只应该覆盖有效元素。
-
例如真实只剩 4 个
half:有效数据 = 4 × 2 = 8 Byte -
为了满足搬运要求,可能仍然需要按一个 32 Byte block 处理内存,但计算时应通过
count、Mask 或额外逻辑确保只有真实元素参与最终语义。 -
核心原则:对齐是硬件访问要求,不等于对齐补出来的数据也属于 Tensor 的有效数据。
多数据类型算子实现
- 复杂 Shape 处理完后,还需要考虑另一类通用性问题:同一个算子支持多种 dtype。
Host 侧注册多种 dtype
- 算子描述 JSON 和 Host 侧原型注册需要声明支持的数据类型。例如同一输入可能支持:
halffloatint32int8
- 输入、输出的数据类型约束要保持一致或按算子语义明确转换关系。
Kernel 侧模板化
-
Kernel 可通过模板类型统一实现:
template <typename TYPE_X, typename TYPE_Y, typename TYPE_Z> class KernelAdd { // GlobalTensor<TYPE_X> // LocalTensor<TYPE_X> // ... }; -
这样可以复用大部分搬运、切分和流水代码。
计算 API 不支持当前 dtype 时怎么办
-
即使 Host 注册了某个 dtype,也不代表所使用的 Vector API 一定直接支持它。
-
例如某个
Add基础 API 不直接支持当前int8输入时,可以采用:int8 输入 ↓ Cast 受支持的中间类型 ↓ Add 中间结果 ↓ Cast / 必要的数值处理 int8 输出 -
实现时可以使用
if constexpr针对特定模板类型走专用分支:if constexpr (std::is_same_v<TYPE_X, int8_t>) { // Cast 到受支持类型 // 执行 Add // 再 Cast 回目标类型 } else { // 直接 Add } -
因此,“算子支持某 dtype”需要同时满足两层条件:
- Host 原型允许该 dtype。
- Kernel 内部存在可执行的计算路径。
非对齐尾块处理的完整思路
-
最终可以把这一章归纳为一条通用切分链路:
输入 Shape / dtype ↓ 计算真实字节数 ↓ 按 32 Byte 对齐 ↓ 按 AI Core 数量进行不均匀切分 ↓ 区分大核 / 小核 ↓ 每个核再按 UB 大小切 Tile ↓ 区分普通 Tile / Tail Tile ↓ TilingData 下发全部参数 ↓ Kernel 根据 block_idx 选择参数 ↓ CopyIn → Compute → CopyOut ↓ 尾 Tile 只处理真实有效元素 -
这套方法不仅适用于
(1, 660)的 Add,也适用于更一般的动态 Shape、非对齐输入和多数据类型 Vector 算子。
鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)