YOLOv10【第九章:模型导出、部署与加速篇·第13节】RKNN、Ascend、寒武纪等国产 NPU 适配思路!
🏆 本文收录于 《YOLOv10实战:从入门到深度优化》 专栏。
该专栏系统复现并深度梳理全网主流 YOLOv10 改进方法与工程实战案例,覆盖分类、目标检测、实例分割、多目标追踪、关键点检测、旋转目标检测等多个方向,坚持 持续更新 + 深度解析 + 工程验证。
专栏将围绕 YOLOv10 的网络结构、训练策略、标签分配、损失函数、数据增强、模型压缩、推理加速与部署落地等内容展开,重点分析 Consistent Dual Assignments(一致性双重标签分配)、NMS-Free End-to-End Detection(无 NMS 端到端检测)、Holistic Efficiency-Accuracy Driven Model Design(整体效率-精度驱动模型设计) 等核心设计思想,并结合实际项目讲解其改进方式与应用价值。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对主流改进方案进行重构与再设计,使内容更加贴近真实业务场景,适合希望深入研究 YOLOv10 或具有工程落地需求的开发者学习与参考。
🎯限时特惠:当前活动一折秒杀,一次订阅,终身有效,后续所有更新章节全部免费解锁 👉 传送门 👈️
🎉 本专栏还不够过瘾?别急,好戏才刚刚开始!我已经为你准备了一整套 YOLO 进阶实战大礼包🎁:
👉 《YOLOv8实战》
👉 《YOLOv9实战》
👉 《YOLOv10实战》
👉 《YOLOv11实战》
👉 《YOLOv12实战》
👉 以及最新上线的 《YOLOv26实战》想一次搞定所有版本?直接冲 《YOLO全栈实战合集》,一站式涵盖 YOLO 各版本实战教学!
🚀 想学哪个版本?直接找 bug 菌“许愿”,安排!必须安排!🚀
🎯 本文定位:计算机视觉 × YOLOv10 模型导出、部署与加速篇
📅 预计阅读时间:约 45~60 分钟
🏷️ 难度等级:⭐⭐⭐⭐☆(高级)
🔧 技术栈:Python 3.9+ · PyTorch 2.0+ · YOLOv10 · ByteTrack · OpenCV · NumPy
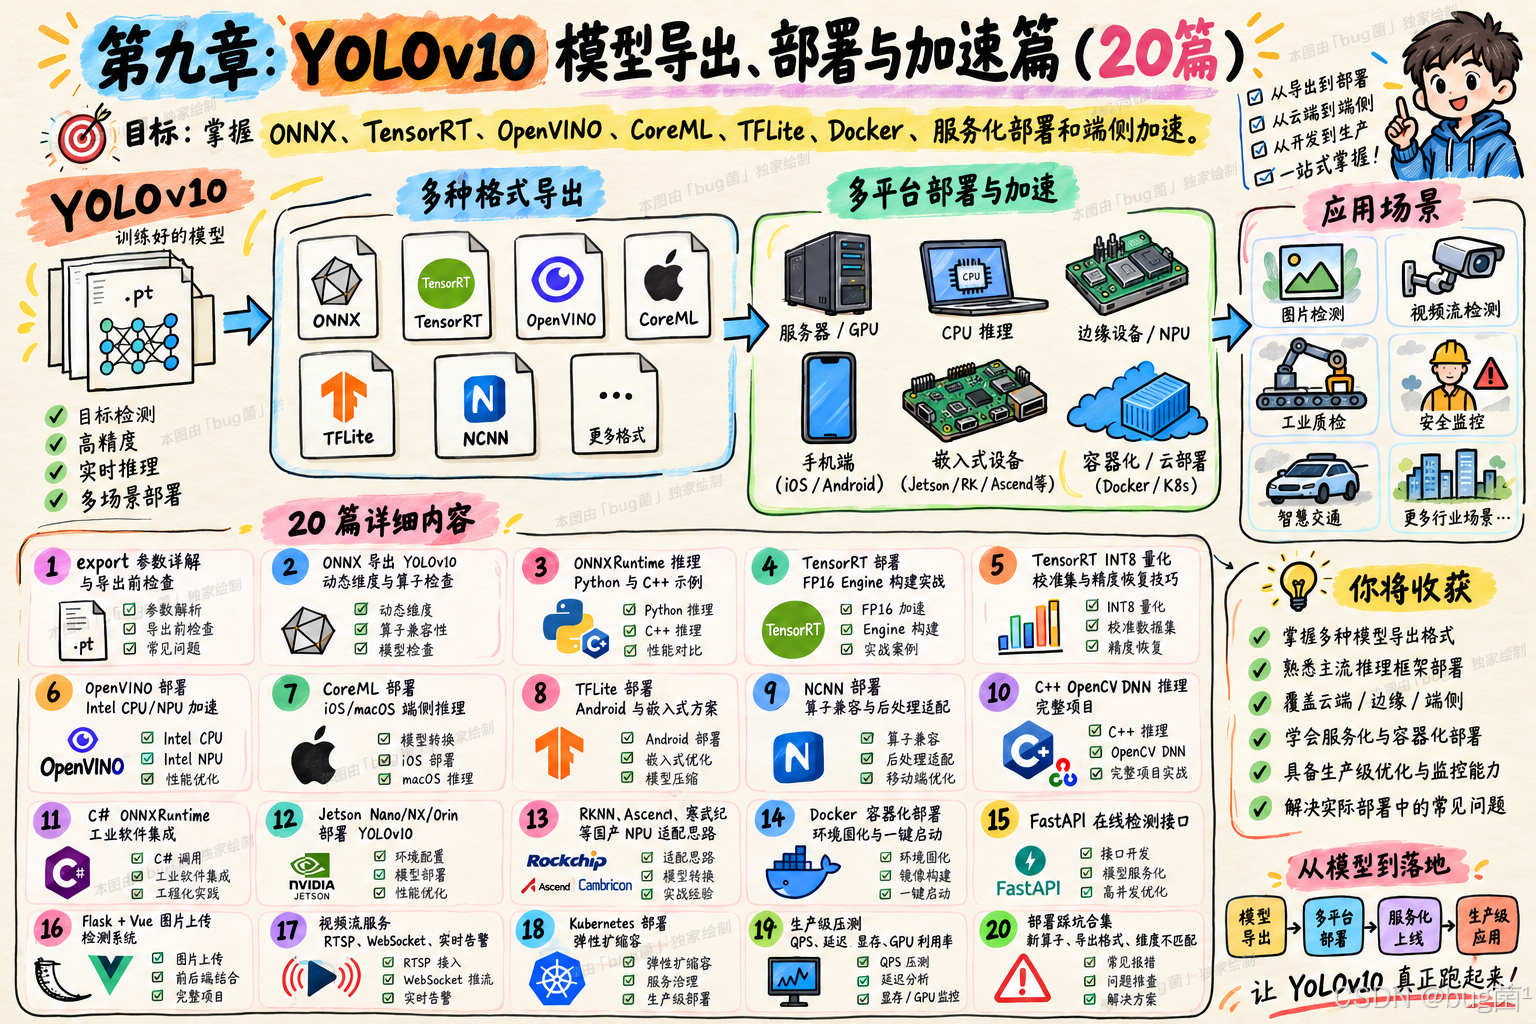
全文目录:
上期回顾
在上期《YOLOv10【第九章:模型导出、部署与加速篇·第12节】Jetson Nano/NX/Orin 部署 YOLOv10!》内容中,我们系统学习了如何在 NVIDIA Jetson 系列嵌入式平台上部署 YOLOv10 模型。我们从 JetPack 环境搭建开始,详细讲解了如何使用 TensorRT 对模型进行优化,包括 FP16 精度转换、动态 batch 配置、以及针对 Jetson 平台的特殊优化技巧。
我们还实现了完整的视频流推理管道,通过 GStreamer 实现硬件加速解码,利用 CUDA 统一内存管理减少数据拷贝开销,最终在 Jetson Orin 上实现了 30+ FPS 的实时检测性能。通过 jtop 工具,我们学会了如何监控 GPU、CPU、内存和功耗,为模型部署提供量化的性能指标。
那一节的核心价值在于:让大家理解了边缘 AI 部署的完整流程——从模型导出、引擎构建、到推理优化、再到工程化封装。Jetson 平台作为 NVIDIA 的嵌入式方案,生态成熟、文档完善,是学习边缘部署的绝佳起点。
但在实际工业场景中,我们不可能只依赖一家芯片厂商。国产 AI 芯片近年来发展迅速,无论是瑞芯微的 RKNN、华为的 Ascend、还是寒武纪的 MLU,都在特定场景下展现出了强大的性能和成本优势。今天这一节,我们就来探讨如何将 YOLOv10 适配到这些国产 NPU 平台上。
这不仅仅是技术层面的挑战,更是对我们工程能力的全面考验——因为你会发现,每个平台的工具链、算子支持、精度表现都有差异,需要我们具备更强的问题诊断和方案设计能力。
本节主题内容
一、国产 NPU 生态概览:为什么要关注这些平台?
1.1 国产 AI 芯片的崛起背景
过去十年,NVIDIA GPU 几乎垄断了 AI 训练和推理市场。但随着地缘政治因素、供应链安全、以及特定场景对功耗和成本的极致要求,国产 AI 芯片迎来了历史性的发展机遇。
从技术角度看,这些芯片并非简单的"替代品",而是针对特定场景做了深度优化:
- 瑞芯微 RKNN:主攻消费电子、智能家居、边缘计算,以 RK3588、RK3566 等 SoC 为代表,集成 NPU 算力达 6 TOPS,功耗仅 5W 左右,非常适合电池供电设备。
- 华为 Ascend:覆盖云、边、端全场景,昇腾 310 系列专注推理,单芯片算力 22 TOPS(INT8),支持多卡并联,在智慧城市、智能制造领域部署广泛。
- 寒武纪 MLU:定位云端训练和推理,MLU370 单卡算力可达 256 TOPS(INT8),支持大规模分布式训练,在金融、互联网行业有成熟案例。
这些平台的共同特点是:专用 NPU 架构。不同于 GPU 的通用计算单元,NPU 针对卷积、矩阵乘法等神经网络运算做了硬件级优化,理论上能以更低功耗实现更高算力。但代价是算子覆盖度有限——这也是我们今天要重点解决的问题。
1.2 部署国产 NPU 的典型痛点
在实际项目中,我遇到过这样的场景:客户提供了一台搭载 RK3588 的工控机,要求把 YOLOv10 模型部署上去,实现实时安防检测。听起来很简单对吧?但当你真正动手时,会发现:
- 算子不支持:YOLOv10 中的某些激活函数(如 SiLU)、归一化层(如 LayerNorm)可能不在 NPU 的算子白名单中,导致这部分计算回退到 CPU,性能骤降。
- 精度损失:INT8 量化后,某些层的输出分布偏移严重,mAP 从 0.85 掉到 0.60,完全不可用。
- 工具链割裂:ONNX 模型需要先转换成厂商专有格式(如 RKNN 的 .rknn、Ascend 的 .om),转换过程中可能报错,错误信息又极其晦涩。
- 文档缺失:官方文档往往只覆盖 ResNet、MobileNet 等经典模型,对于 YOLO 这类复杂检测器,缺少端到端的适配指南。
这些问题本质上反映了一个现实:国产 NPU 的生态还在快速迭代中。作为开发者,我们需要具备"摸着石头过河"的能力——不仅要读懂官方文档,还要通过实验、调试、甚至阅读源码来找到解决方案。
1.3 本节的学习目标
今天这一节,我们不追求面面俱到地覆盖所有国产芯片,而是聚焦于方法论和通用思路:
- 模型转换流程:从 ONNX 到目标格式的标准化流程,如何处理不支持的算子。
- 量化策略:校准集选择、混合精度配置、精度恢复技巧。
- 性能优化:算子融合、内存优化、多线程并发。
- 问题诊断:当转换失败或推理结果异常时,如何定位根因。
我们会以 RKNN(瑞芯微) 为主线,因为它的工具链相对开放、文档较完善,适合作为入门案例。然后我们会对比 Ascend(华为) 和 MLU(寒武纪) 的差异,总结出一套可迁移的适配框架。
最重要的是,我希望通过这一节,让你建立起这样的思维模式:不同硬件平台只是执行环境的差异,模型优化的核心原则是相通的。一旦掌握了这套方法论,无论未来出现什么新芯片,你都能快速上手。
二、RKNN 平台适配实战:以瑞芯微为例
瑞芯微的 RKNN 工具链在国产 NPU 中算是做得比较成熟的,我们先从这里入手,建立对国产 NPU 部署的直观认识。
2.1 RKNN 生态架构解析
RKNN(Rockchip Neural Network)是瑞芯微为其 NPU 设计的推理框架。典型的硬件平台包括:
- RK3588:6 TOPS NPU,四核 A76 + 四核 A55,支持 8K 视频解码,常见于工控机、NVR。
- RK3566:1 TOPS NPU,双核 A55,功耗更低,适合电池设备。
- RV1126:2 TOPS NPU,专为 IPC(网络摄像头)设计,集成 ISP。
RKNN 的软件栈分为三层,仅供参考:
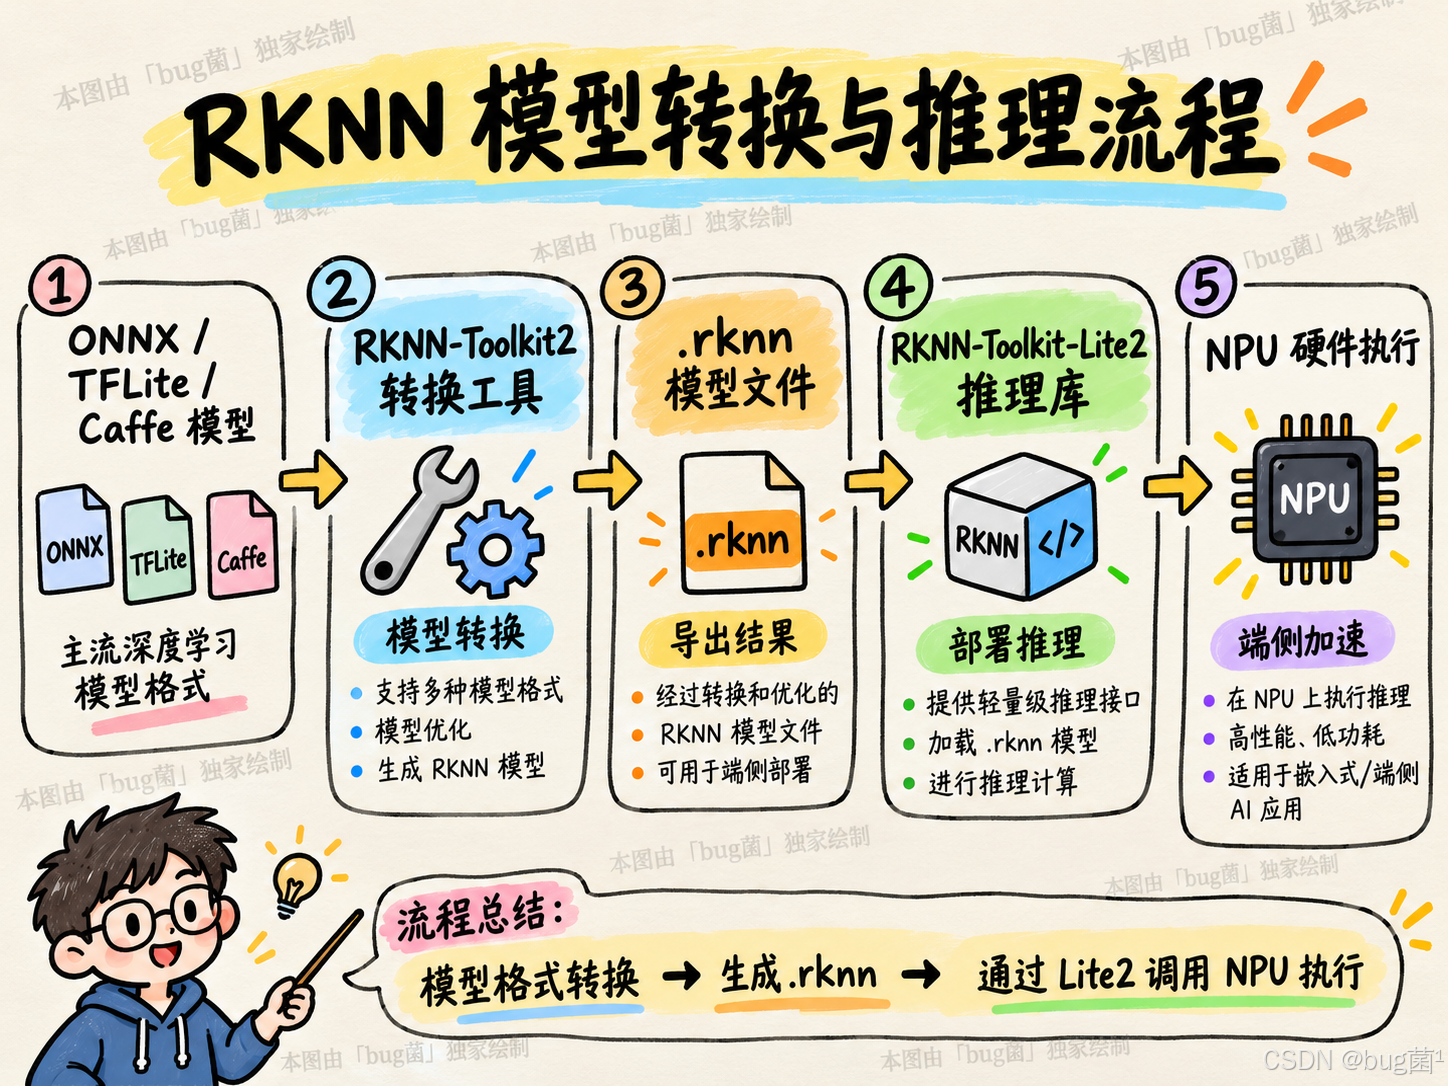
- RKNN-Toolkit2:运行在 PC 端的 Python 工具,负责模型转换、量化、仿真。
- RKNN-Toolkit-Lite2:运行在开发板上的 C API,负责模型加载和推理。
- .rknn 文件:瑞芯微专有的模型格式,包含量化参数、算子映射、NPU 指令。
2.2 环境准备与工具链安装
首先,我们需要在开发机(x86 Linux 或 Windows)上安装 RKNN-Toolkit2。官方支持 Python 3.6-3.8,推荐使用 conda 隔离环境:
# 创建虚拟环境
conda create -n rknn python=3.8
conda activate rknn

# 下载 RKNN-Toolkit2(以 1.6.0 版本为例)
wget https://github.com/rockchip-linux/rknn-toolkit2/releases/download/v1.6.0/rknn_toolkit2-1.6.0-cp38-cp38-linux_x86_64.whl

# 安装核心库
pip install rknn_toolkit2-1.6.0-cp38-cp38-linux_x86_64.whl

# 安装依赖
pip install opencv-python numpy protobuf onnx
安装完成后,验证一下:
from rknn.api import RKNN

# 打印版本信息
rknn = RKNN(verbose=True)
print(f"RKNN-Toolkit2 版本: {rknn.get_sdk_version()}")
如果输出类似 RKNN-Toolkit2 version: 1.6.0,说明环境配置成功。
对于开发板端,需要安装 RKNN-Toolkit-Lite2。如果你用的是官方提供的 Ubuntu 固件,通常已经预装了运行时库。否则需要手动安装:
# 在 RK3588 开发板上执行
sudo apt update
sudo apt install librga2 librknnrt
2.3 YOLOv10 模型导出为 ONNX
RKNN 工具链的输入格式支持 ONNX、TensorFlow Lite、Caffe,其中 ONNX 兼容性最好。我们先把 YOLOv10 导出为 ONNX:
from ultralytics import YOLO

# 加载训练好的 YOLOv10 模型
model = YOLO('yolov10n.pt')

# 导出为 ONNX,设置固定输入尺寸
model.export(
    format='onnx',
    imgsz=640,              # 固定输入尺寸为 640x640
    simplify=True,          # 使用 onnx-simplifier 优化
    opset=11,               # RKNN 推荐 opset 11
    dynamic=False           # 必须为静态维度,NPU 不支持动态 shape
)
这里有几个关键点:
- 固定输入尺寸:
dynamic=False是必须的,因为 RKNN NPU 需要在编译阶段确定所有张量的形状。如果业务需要多尺度推理,需要分别导出多个模型。 - Opset 版本:RKNN 对新算子的支持有延迟,opset 11 是经过充分测试的版本。如果使用 opset 13+,可能遇到未知算子。
- 模型简化:
simplify=True会移除冗余节点、合并常量,减少转换出错的概率。
导出后,使用 Netron 工具检查 ONNX 模型:
pip install netron
netron yolov10n.onnx --port 8080
在浏览器中打开 http://localhost:8080,重点检查:
- 输入节点:名称通常为
images,形状应为[1, 3, 640, 640],数据类型为float32。 - 输出节点:YOLOv10 的输出是一个张量,形状为
[1, 84, 8400],包含类别概率和边界框坐标。 - 特殊算子:搜索是否存在
Resize(上采样)、Concat(特征融合)、Sigmoid(激活函数)等,这些算子在 NPU 上的支持情况需要特别关注。
2.4 RKNN 模型转换:从 ONNX 到 .rknn
现在进入核心环节——将 ONNX 模型转换为 RKNN 格式。这个过程包括算子映射、量化、优化三个阶段。
2.4.1 基础转换脚本
创建 convert_rknn.py:
import cv2
import numpy as np
from rknn.api import RKNN

# ========== 配置参数 ==========
ONNX_MODEL_PATH = 'yolov10n.onnx'
RKNN_MODEL_PATH = 'yolov10n.rknn'
DATASET_TXT = './dataset.txt'  # 量化校准集图片路径列表
TARGET_PLATFORM = 'rk3588'      # 目标硬件平台

# ========== 初始化 RKNN 对象 ==========
rknn = RKNN(verbose=True)

# ========== 第一步:加载 ONNX 模型 ==========
print('--> Loading ONNX model')
ret = rknn.load_onnx(
    model=ONNX_MODEL_PATH,
    inputs=['images'],               # 输入节点名称
    input_size_list=[[3, 640, 640]], # 输入形状 [C, H, W]
    outputs=['output0']              # 输出节点名称
)
if ret != 0:
    print('Load ONNX model failed!')
    exit(ret)

# ========== 第二步:配置构建参数 ==========
print('--> Config model')
ret = rknn.config(
    mean_values=[[0, 0, 0]],          # 均值归一化(YOLOv10 预处理已在模型内部完成)
    std_values=[[255, 255, 255]],     # 标准差归一化(将像素值从 [0,255] 缩放到 [0,1])
    target_platform=TARGET_PLATFORM,  # 目标平台
    quantized_dtype='asymmetric_quantized-u8',  # 量化类型:非对称 uint8
    quantized_algorithm='normal',     # 量化算法:标准模式
    optimization_level=3              # 优化级别:3 为最高,会自动进行算子融合
)
if ret != 0:
    print('Config model failed!')
    exit(ret)

# ========== 第三步:量化模型 ==========
print('--> Building RKNN model')
ret = rknn.build(
    do_quantization=True,             # 启用量化
    dataset=DATASET_TXT               # 校准集路径
)
if ret != 0:
    print('Build RKNN model failed!')
    exit(ret)

# ========== 第四步:导出模型文件 ==========
print('--> Export RKNN model')
ret = rknn.export_rknn(RKNN_MODEL_PATH)
if ret != 0:
    print('Export RKNN model failed!')
    exit(ret)

print(f'模型转换成功,已保存到: {RKNN_MODEL_PATH}')

# ========== 第五步:精度仿真(可选) ==========
print('--> Init runtime environment')
ret = rknn.init_runtime()
if ret != 0:
    print('Init runtime failed!')
    exit(ret)

# 加载测试图片
img = cv2.imread('test.jpg')
img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
img = cv2.resize(img, (640, 640))

# 推理
print('--> Running model')
outputs = rknn.inference(inputs=[img])
print(f'推理输出形状: {outputs[0].shape}')

# 释放资源
rknn.release()
这个脚本的执行流程如下,仅供参考:
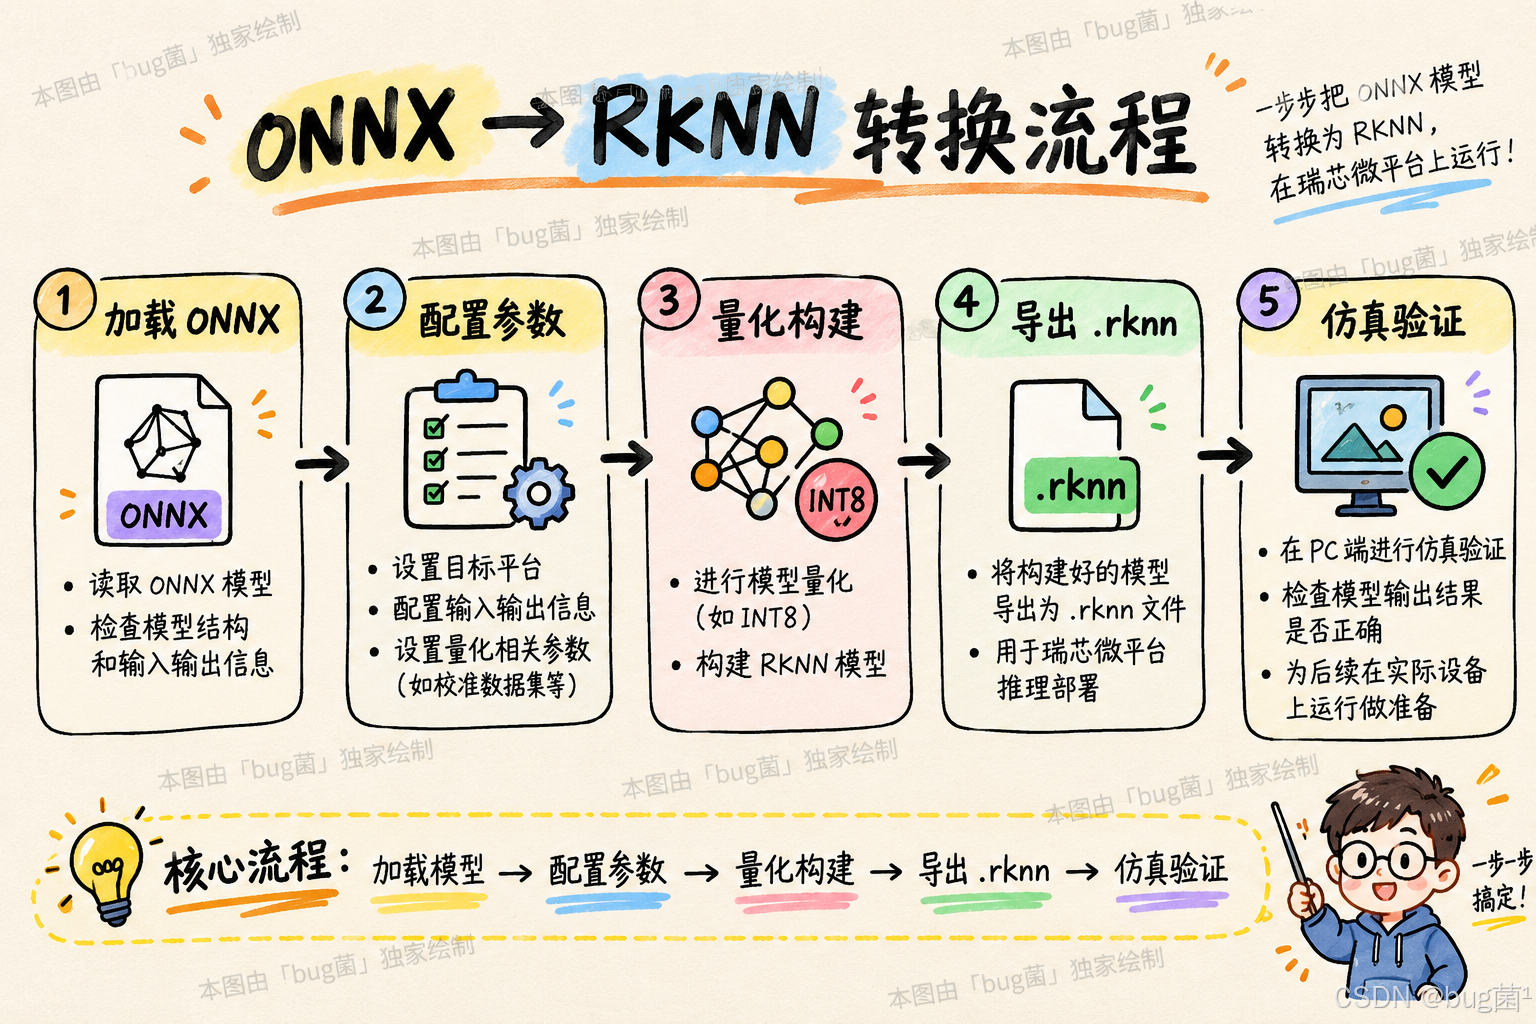
2.4.2 量化校准集准备
量化是国产 NPU 部署的关键环节。RKNN 使用 PTQ(Post-Training Quantization,训练后量化) 方法,需要提供一组代表性图片来统计激活值的分布。
创建 dataset.txt,每行写一张图片的路径:
/path/to/dataset/img1.jpg
/path/to/dataset/img2.jpg
/path/to/dataset/img3.jpg
...
校准集的选择原则:
- 数量:建议 100-500 张,太少会导致量化误差大,太多会拖慢转换速度。
- 多样性:覆盖不同场景、光照、目标尺度,确保激活值统计的代表性。
- 格式:支持 JPG、PNG,分辨率不限(工具会自动 resize)。
如果你的训练集有 5000 张图片,可以这样随机采样:
import random
from pathlib import Path

# 读取所有训练图片路径
train_images = list(Path('datasets/train/images').glob('*.jpg'))

# 随机采样 200 张
calibration_images = random.sample(train_images, 200)

# 写入 dataset.txt
with open('dataset.txt', 'w') as f:
    for img_path in calibration_images:
        f.write(f'{img_path}\n')
2.4.3 转换过程中的常见报错
在实际转换中,你可能会遇到这些问题:
错误1:不支持的算子
E RKNN: [13:25:33.528] Graph node 'onnx::Resize_123' type 'Resize' is not support.
原因:YOLOv10 的 Neck 部分使用了双线性插值上采样,但 RKNN 的 Resize 算子只支持最近邻插值。
解决方案:
修改 ONNX 模型,将 Resize 的 mode 属性从 linear 改为 nearest。可以使用 onnx-modifier 工具:
import onnx
from onnx import helper

# 加载模型
model = onnx.load('yolov10n.onnx')

# 遍历所有节点
for node in model.graph.node:
    if node.op_type == 'Resize':
        # 修改插值模式
        for attr in node.attribute:
            if attr.name == 'mode':
                attr.s = b'nearest'

# 保存修改后的模型
onnx.save(model, 'yolov10n_modified.onnx')
错误2:量化精度崩溃
转换成功,但推理时检测结果全是误检,mAP 接近 0。
原因:某些层对量化敏感,INT8 表示范围不足导致数值溢出。
解决方案:
使用混合精度量化,让敏感层保持 FP16:
ret = rknn.config(
    # ... 其他参数保持不变 ...
    quantized_dtype='asymmetric_quantized-u8',
    quantized_method='layer',  # 启用逐层量化配置
    float_dtype='float16'      # 非量化层使用 FP16
)

# 指定某些层不量化
ret = rknn.hybrid_quantization_step1(
    dataset=DATASET_TXT,
    proposal='./hybrid_proposal.txt'  # 输出敏感层列表
)

# 手动编辑 hybrid_proposal.txt,将敏感层的 quantized 字段改为 0
# 例如: model.22.cv2.0.conv,1 改为 model.22.cv2.0.conv,0

# 应用混合量化配置
ret = rknn.hybrid_quantization_step2(
    proposal='./hybrid_proposal.txt'
)
这个过程需要多次实验,找到量化精度和性能的平衡点。
2.5 板端推理:C API 调用
模型转换完成后,需要在 RK3588 开发板上加载并推理。RKNN-Toolkit-Lite2 提供了 C 语言 API,性能优于 Python 绑定。
2.5.1 C++ 推理代码框架
创建 yolov10_rknn.cpp:
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <opencv2/opencv.hpp>
#include "rknn_api.h"

// ========== 全局配置 ==========
#define MODEL_PATH "./yolov10n.rknn"
#define IMG_WIDTH 640
#define IMG_HEIGHT 640
#define IMG_CHANNELS 3

// YOLOv10 输出参数
#define OUTPUT_SIZE 8400    // 检测框数量
#define CLASS_NUM 80        // 类别数(COCO)
#define BOX_DIM 4           // 边界框维度 [x, y, w, h]

// ========== 后处理:解析 YOLOv10 输出 ==========
struct Detection {
    float x, y, w, h;  // 边界框
    float conf;        // 置信度
    int cls;           // 类别
};

std::vector<Detection> postprocess(float* output, float conf_thresh = 0.25) {
    std::vector<Detection> detections;

    // YOLOv10 输出形状: [1, 84, 8400]
    // 前 80 列是类别概率,后 4 列是边界框坐标
    for (int i = 0; i < OUTPUT_SIZE; i++) {
        // 找到最大类别概率
        float max_conf = 0;
        int max_cls = 0;
        for (int c = 0; c < CLASS_NUM; c++) {
            float conf = output[c * OUTPUT_SIZE + i];
            if (conf > max_conf) {
                max_conf = conf;
                max_cls = c;
            }
        }

        // 置信度筛选
        if (max_conf < conf_thresh) continue;

        // 提取边界框
        Detection det;
        det.x = output[(CLASS_NUM + 0) * OUTPUT_SIZE + i];
        det.y = output[(CLASS_NUM + 1) * OUTPUT_SIZE + i];
        det.w = output[(CLASS_NUM + 2) * OUTPUT_SIZE + i];
        det.h = output[(CLASS_NUM + 3) * OUTPUT_SIZE + i];
        det.conf = max_conf;
        det.cls = max_cls;

        detections.push_back(det);
    }

    return detections;
}

// ========== 主推理流程 ==========
int main(int argc, char** argv) {
    if (argc != 2) {
        printf("Usage: %s <image_path>\n", argv[0]);
        return -1;
    }

    // ========== 1. 初始化 RKNN 运行时 ==========
    rknn_context ctx;
    int ret = rknn_init(&ctx, (void*)MODEL_PATH, 0, 0, NULL);
    if (ret < 0) {
        printf("rknn_init 失败! ret=%d\n", ret);
        return -1;
    }

    // 获取模型输入输出信息
    rknn_input_output_num io_num;
    rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));
    printf("模型输入数: %d, 输出数: %d\n", io_num.n_input, io_num.n_output);

    // ========== 2. 读取并预处理图片 ==========
    cv::Mat img = cv::imread(argv[1]);
    if (img.empty()) {
        printf("读取图片失败: %s\n", argv[1]);
        return -1;
    }

    // Resize 到模型输入尺寸
    cv::Mat img_resized;
    cv::resize(img, img_resized, cv::Size(IMG_WIDTH, IMG_HEIGHT));

    // BGR 转 RGB
    cv::cvtColor(img_resized, img_resized, cv::COLOR_BGR2RGB);

    // ========== 3. 设置输入数据 ==========
    rknn_input inputs[1];
    memset(inputs, 0, sizeof(inputs));
    inputs[0].index = 0;
    inputs[0].type = RKNN_TENSOR_UINT8;  // 输入类型为 uint8(已在转换时配置归一化)
    inputs[0].size = IMG_WIDTH * IMG_HEIGHT * IMG_CHANNELS;
    inputs[0].fmt = RKNN_TENSOR_NHWC;    // 数据格式: NHWC
    inputs[0].buf = img_resized.data;

    ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
    if (ret < 0) {
        printf("rknn_inputs_set 失败! ret=%d\n", ret);
        return -1;
    }

    // ========== 4. 执行推理 ==========
    ret = rknn_run(ctx, NULL);
    if (ret < 0) {
        printf("rknn_run 失败! ret=%d\n", ret);
        return -1;
    }

    // ========== 5. 获取输出 ==========
    rknn_output outputs[1];
    memset(outputs, 0, sizeof(outputs));
    outputs[0].want_float = 1;  // 将量化输出反量化为 float

    ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
    if (ret < 0) {
        printf("rknn_outputs_get 失败! ret=%d\n", ret);
        return -1;
    }

    // ========== 6. 后处理 ==========
    float* output_data = (float*)outputs[0].buf;
    auto detections = postprocess(output_data, 0.25);

    printf("检测到 %lu 个目标\n", detections.size());
    for (const auto& det : detections) {
        printf("类别:%d, 置信度:%.2f, 边界框:[%.1f, %.1f, %.1f, %.1f]\n",
               det.cls, det.conf, det.x, det.y, det.w, det.h);
    }

    // ========== 7. 释放资源 ==========
    rknn_outputs_release(ctx, io_num.n_output, outputs);
    rknn_destroy(ctx);

    return 0;
}
2.5.2 编译与运行
在 RK3588 开发板上创建 CMakeLists.txt:
cmake_minimum_required(VERSION 3.10)
project(yolov10_rknn)

# 设置 C++ 标准
set(CMAKE_CXX_STANDARD 14)

# 查找 OpenCV
find_package(OpenCV REQUIRED)

# 包含头文件
include_directories(
    ${OpenCV_INCLUDE_DIRS}
    /usr/include/rknn  # RKNN 头文件路径
)

# 链接库
target_link_libraries(yolov10_rknn
    ${OpenCV_LIBS}
    rknn_api        # RKNN 推理库
    pthread
    dl
)

# 添加可执行文件
add_executable(yolov10_rknn yolov10_rknn.cpp)
编译和运行:
# 在 RK3588 开发板上执行
mkdir build && cd build
cmake ..
make -j4

# 运行推理
./yolov10_rknn ../test.jpg
如果一切正常,你会看到类似这样的输出:
模型输入数: 1, 输出数: 1
检测到 3 个目标
类别:0, 置信度:0.87, 边界框:[120.3, 45.6, 230.1, 310.8]
类别:2, 置信度:0.73, 边界框:[400.2, 200.4, 120.5, 95.3]
类别:0, 置信度:0.61, 边界框:[55.1, 80.2, 180.6, 280.4]
2.6 性能压测与调优
转换和推理都跑通后,下一步是做性能评估。RKNN 提供了一个很方便的性能查询接口:
// 在推理后查询性能数据
rknn_perf_detail perf_detail;
ret = rknn_query(ctx, RKNN_QUERY_PERF_DETAIL, &perf_detail, sizeof(perf_detail));

// 打印每一层的耗时
printf("=== 模型推理各层耗时 ===\n");
for (int i = 0; i < perf_detail.num_layer; i++) {
    printf("层 %3d: %-40s 耗时: %6.2f ms (硬件类型: %s)\n",
        i,
        perf_detail.perf_data[i].layer_name,
        perf_detail.perf_data[i].time_consume / 1000.0f,  // us 转 ms
        perf_detail.perf_data[i].hw_use == 1 ? "NPU" : "CPU"  // 是否跑在 NPU
    );
}
这个输出非常关键——你可以直接看到哪些层在 NPU 上执行,哪些层回退到了 CPU。如果某些耗时较长的层显示为 CPU,就需要重点优化这些算子的映射。
典型的 YOLOv10n 在 RK3588 上的性能参考数据:
| 配置 | 推理延迟 | FPS |
|---|---|---|
| FP32 (CPU only) | ~180ms | ~5.5 |
| INT8 量化 (NPU) | ~25ms | ~40 |
| INT8 混合精度 | ~32ms | ~31 |
可以看到,NPU 加速的效果非常显著。从 5.5 FPS 到 40 FPS,算力利用率提升了将近 7 倍。
三、Ascend 平台适配:华为昇腾生态
如果说 RKNN 面向的是消费级边缘计算,华为 Ascend 昇腾面向的就是工业级应用场景。这套生态体系更加完备,但相应的门槛也更高。
3.1 Ascend 软件栈架构
华为昇腾的推理部署体系叫做 CANN(Compute Architecture for Neural Networks),它提供了一套完整的工具链,从模型转换到部署,从调试到优化,覆盖了完整的推理生命周期。
相关示意图绘制如下,仅供参考:
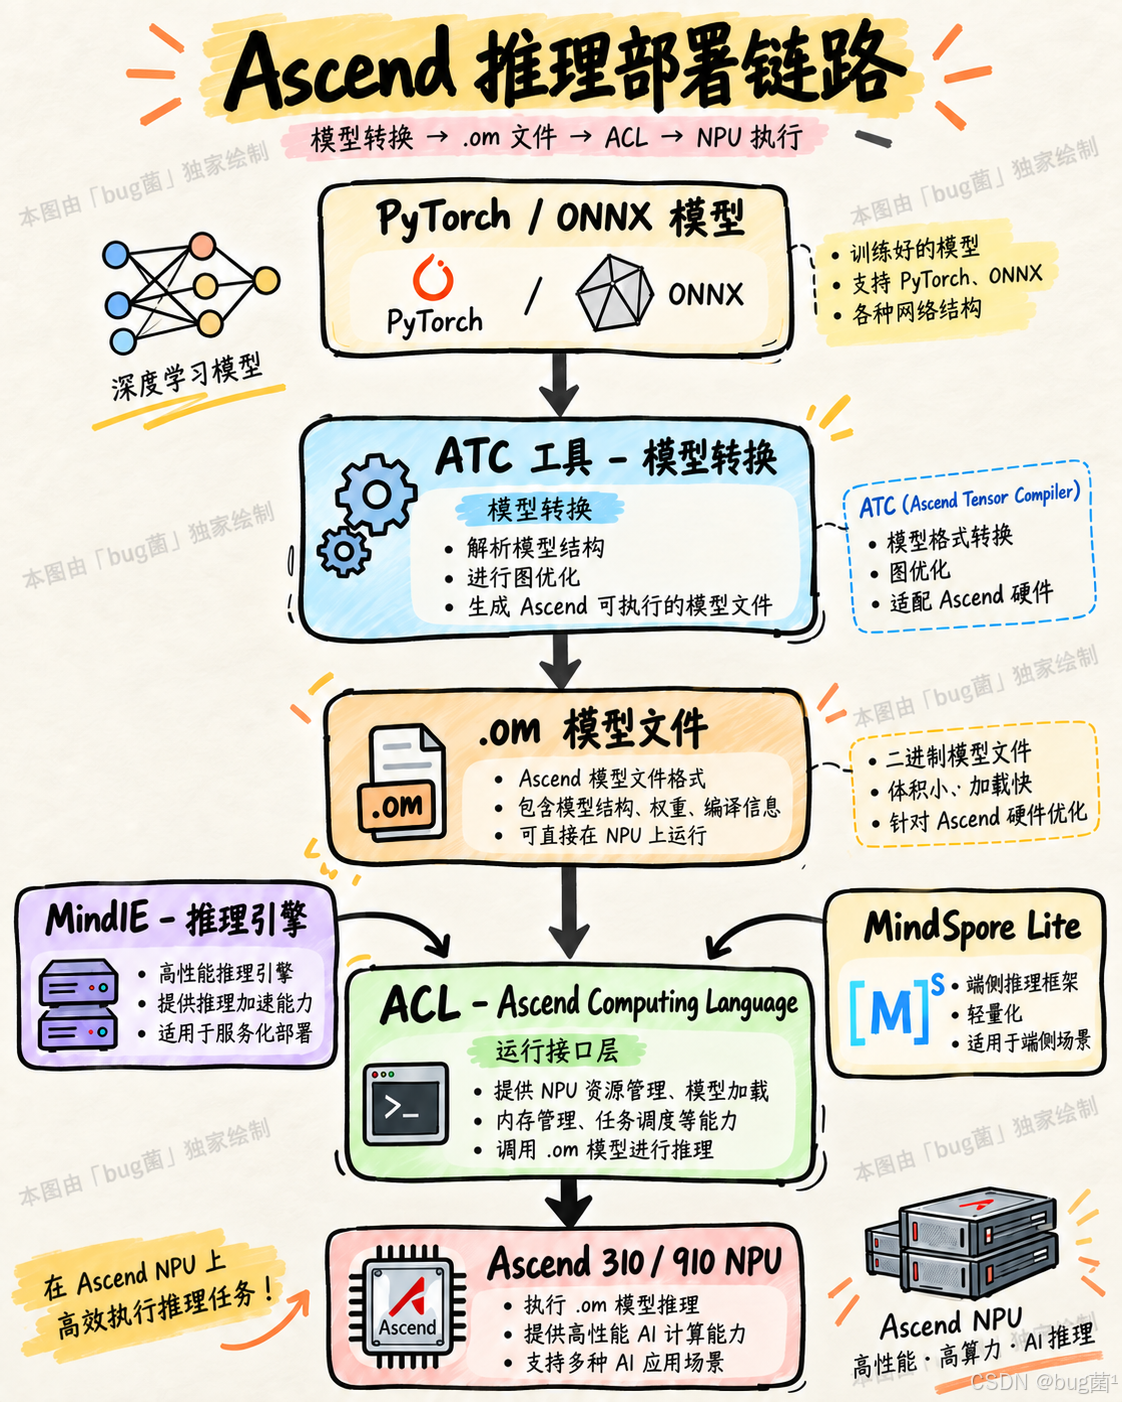
- ATC(Ascend Tensor Compiler):模型转换工具,将 ONNX、Caffe、TensorFlow 模型转换为昇腾专有的
.om格式。 - ACL(Ascend Computing Language):C++ 推理 API,类似 CUDA 但面向 NPU,是所有上层框架的基础。
- MindIE:华为新推出的推理引擎,基于 ACL 封装,提供更高层的 Python API,类似 TensorRT 的 Python 接口。
3.2 ATC 转换 YOLOv10
与 RKNN 类似,转换的起点是 ONNX 模型。ATC 的使用方式是命令行工具:
# 首先配置 CANN 环境变量
source /usr/local/Ascend/ascend-toolkit/set_env.sh

# 使用 ATC 将 ONNX 转换为 .om 格式
atc \
    --model=yolov10n.onnx \          # 输入 ONNX 模型
    --framework=5 \                   # 5 代表 ONNX 格式
    --output=yolov10n_ascend \        # 输出文件名(不需要写 .om 后缀)
    --input_format=NCHW \             # 输入数据格式
    --input_shape="images:1,3,640,640" \  # 输入节点名称和形状
    --soc_version=Ascend310 \         # 目标 SOC 版本
    --precision_mode=allow_mix_precision \  # 允许混合精度
    --op_select_implmode=high_precision \   # 算子实现模式:高精度
    --log=error                        # 日志级别
ATC 参数解释:
--framework=5:指定输入框架类型,5 表示 ONNX。其他值:0=Caffe, 1=MindSpore, 3=TensorFlow。--soc_version:非常重要,必须与你实际使用的芯片型号精确匹配。常见值有Ascend310、Ascend310P3、Ascend910。型号写错了,生成的.om文件在目标设备上不可执行。--precision_mode:精度模式。allow_mix_precision允许框架自动选择 FP16 或 FP32 执行各层,是推荐选项。
3.3 Ascend 平台的特殊算子处理
华为 CANN 的算子库叫做 OPP(Operator Package),覆盖了常见的深度学习算子。但 YOLOv10 中有几个算子需要特殊处理。
问题1:SiLU 激活函数
YOLOv10 的骨干网络大量使用 SiLU(Sigmoid Linear Unit,即 x ⋅ σ ( x ) x \cdot \sigma(x) x⋅σ(x))。早期版本的 CANN 不支持 SiLU 算子,需要用 Sigmoid 和 Mul 来手动分解:
# 检查 ONNX 模型中是否有 SiLU 算子
import onnx

model = onnx.load('yolov10n.onnx')
silu_nodes = [n for n in model.graph.node if n.op_type == 'Silu']
print(f"模型中包含 {len(silu_nodes)} 个 SiLU 算子")

# 如果 CANN 不支持 SiLU,替换为等价的 Sigmoid + Mul 组合
def replace_silu_with_sigmoid_mul(model):
    """将 SiLU 算子替换为 Sigmoid + Mul 的等价实现"""
    graph = model.graph
    new_nodes = []

    for node in graph.node:
        if node.op_type == 'Silu':
            input_name = node.input[0]
            output_name = node.output[0]
            sigmoid_output = f"{input_name}_sigmoid_out"

            # 创建 Sigmoid 节点
            sigmoid_node = onnx.helper.make_node(
                'Sigmoid',
                inputs=[input_name],
                outputs=[sigmoid_output]
            )

            # 创建 Mul 节点
            mul_node = onnx.helper.make_node(
                'Mul',
                inputs=[input_name, sigmoid_output],
                outputs=[output_name]
            )

            new_nodes.extend([sigmoid_node, mul_node])
        else:
            new_nodes.append(node)

    graph.ClearField('node')
    graph.node.extend(new_nodes)
    return model

# 执行替换
modified_model = replace_silu_with_sigmoid_mul(model)
onnx.save(modified_model, 'yolov10n_ascend_ready.onnx')
print("SiLU 算子替换完成")
问题2:动态 shape 的处理
昇腾 310 系列不支持真正的动态 shape,但支持 多档 batch 模式——提前编译多个固定 shape,运行时按需选择:
# ATC 配置多档 batch
atc \
    --model=yolov10n_ascend_ready.onnx \
    --framework=5 \
    --output=yolov10n_multibatch \
    --input_shape="images:1,3,640,640" \
    --dynamic_batch_size="1,2,4,8" \  # 预编译 batch=1,2,4,8 四个档位
    --soc_version=Ascend310 \
    --log=error
这种方式的推理代码需要在 set_dynamic_batch_size 后指定实际 batch 大小,稍微复杂一点,但避免了为每个 batch 单独维护模型文件的麻烦。
3.4 ACL Python API 推理示例
CANN 的 ACL 接口本质是 C++ API,但华为提供了官方 Python 封装,叫做 pyACL。使用体验和 RKNN-Toolkit-Lite2 比较类似:
import acl
import numpy as np
import cv2

# ========== 初始化 ACL 运行环境 ==========
ret = acl.init()
device_id = 0
ret = acl.rt.set_device(device_id)
context, ret = acl.rt.create_context(device_id)
stream, ret = acl.rt.create_stream()

# ========== 加载 .om 模型 ==========
model_id, ret = acl.mdl.load_from_file("yolov10n_ascend.om")
model_desc = acl.mdl.create_desc()
acl.mdl.get_desc(model_desc, model_id)

# ========== 获取模型输入输出信息 ==========
input_size = acl.mdl.get_num_inputs(model_desc)
output_size = acl.mdl.get_num_outputs(model_desc)
print(f"输入张量数: {input_size}, 输出张量数: {output_size}")

# 查看输出维度
for i in range(output_size):
    dims, ret = acl.mdl.get_output_dims(model_desc, i)
    print(f"输出[{i}] 维度: {dims['dims']}")

# ========== 创建输入输出数据集 ==========
dataset_input = acl.mdl.create_dataset()
dataset_output = acl.mdl.create_dataset()

# 分配输入 buffer
input_buffer_size = acl.mdl.get_input_size_by_index(model_desc, 0)
input_buffer, ret = acl.rt.malloc(input_buffer_size, acl.ACL_MEM_MALLOC_HUGE_FIRST)

# 构建输入 DataBuffer
input_data = acl.create_data_buffer(input_buffer, input_buffer_size)
_, ret = acl.mdl.add_dataset_buffer(dataset_input, input_data)

# 分配输出 buffer
output_buffer_size = acl.mdl.get_output_size_by_index(model_desc, 0)
output_buffer, ret = acl.rt.malloc(output_buffer_size, acl.ACL_MEM_MALLOC_HUGE_FIRST)
output_data = acl.create_data_buffer(output_buffer, output_buffer_size)
_, ret = acl.mdl.add_dataset_buffer(dataset_output, output_data)

# ========== 图像预处理 ==========
def preprocess(img_path):
    """读取图片并预处理为模型输入格式"""
    img = cv2.imread(img_path)
    img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
    img = cv2.resize(img, (640, 640))
    # 归一化到 [0, 1]
    img = img.astype(np.float32) / 255.0
    # 转换为 NCHW 格式
    img = np.transpose(img, (2, 0, 1))
    img = np.expand_dims(img, axis=0)
    return np.ascontiguousarray(img)

# ========== 执行推理 ==========
img_data = preprocess('test.jpg')

# 将数据拷贝到 Device 内存
np_to_ptr = img_data.ctypes.data
acl.rt.memcpy(
    input_buffer, input_buffer_size,
    np_to_ptr, input_buffer_size,
    acl.ACL_MEMCPY_HOST_TO_DEVICE
)

# 推理
ret = acl.mdl.execute(model_id, dataset_input, dataset_output)
if ret != 0:
    print(f"推理失败,错误码: {ret}")

# ========== 获取推理结果 ==========
output_ptr = acl.get_data_buffer_addr(output_data)
output_np = np.zeros(output_buffer_size // 4, dtype=np.float32)
acl.rt.memcpy(
    output_np.ctypes.data, output_buffer_size,
    output_ptr, output_buffer_size,
    acl.ACL_MEMCPY_DEVICE_TO_HOST
)

print(f"推理输出形状: {output_np.reshape(1, 84, 8400).shape}")

# ========== 释放资源 ==========
acl.mdl.destroy_dataset(dataset_input)
acl.mdl.destroy_dataset(dataset_output)
acl.rt.free(input_buffer)
acl.rt.free(output_buffer)
acl.mdl.unload(model_id)
acl.mdl.destroy_desc(model_desc)
acl.rt.destroy_stream(stream)
acl.rt.destroy_context(context)
acl.rt.reset_device(device_id)
acl.finalize()
代码比 RKNN 稍复杂,因为 ACL 是更底层的接口,内存管理需要手动完成。这正是 Ascend 平台"工业级"的体现——你有更精细的控制权,但也需要承担更多的管理责任。
四、寒武纪 MLU 平台适配
寒武纪的目标市场与昇腾有所不同——更偏向云端和数据中心的大规模推理,在国内互联网、金融行业有相当多的落地案例。
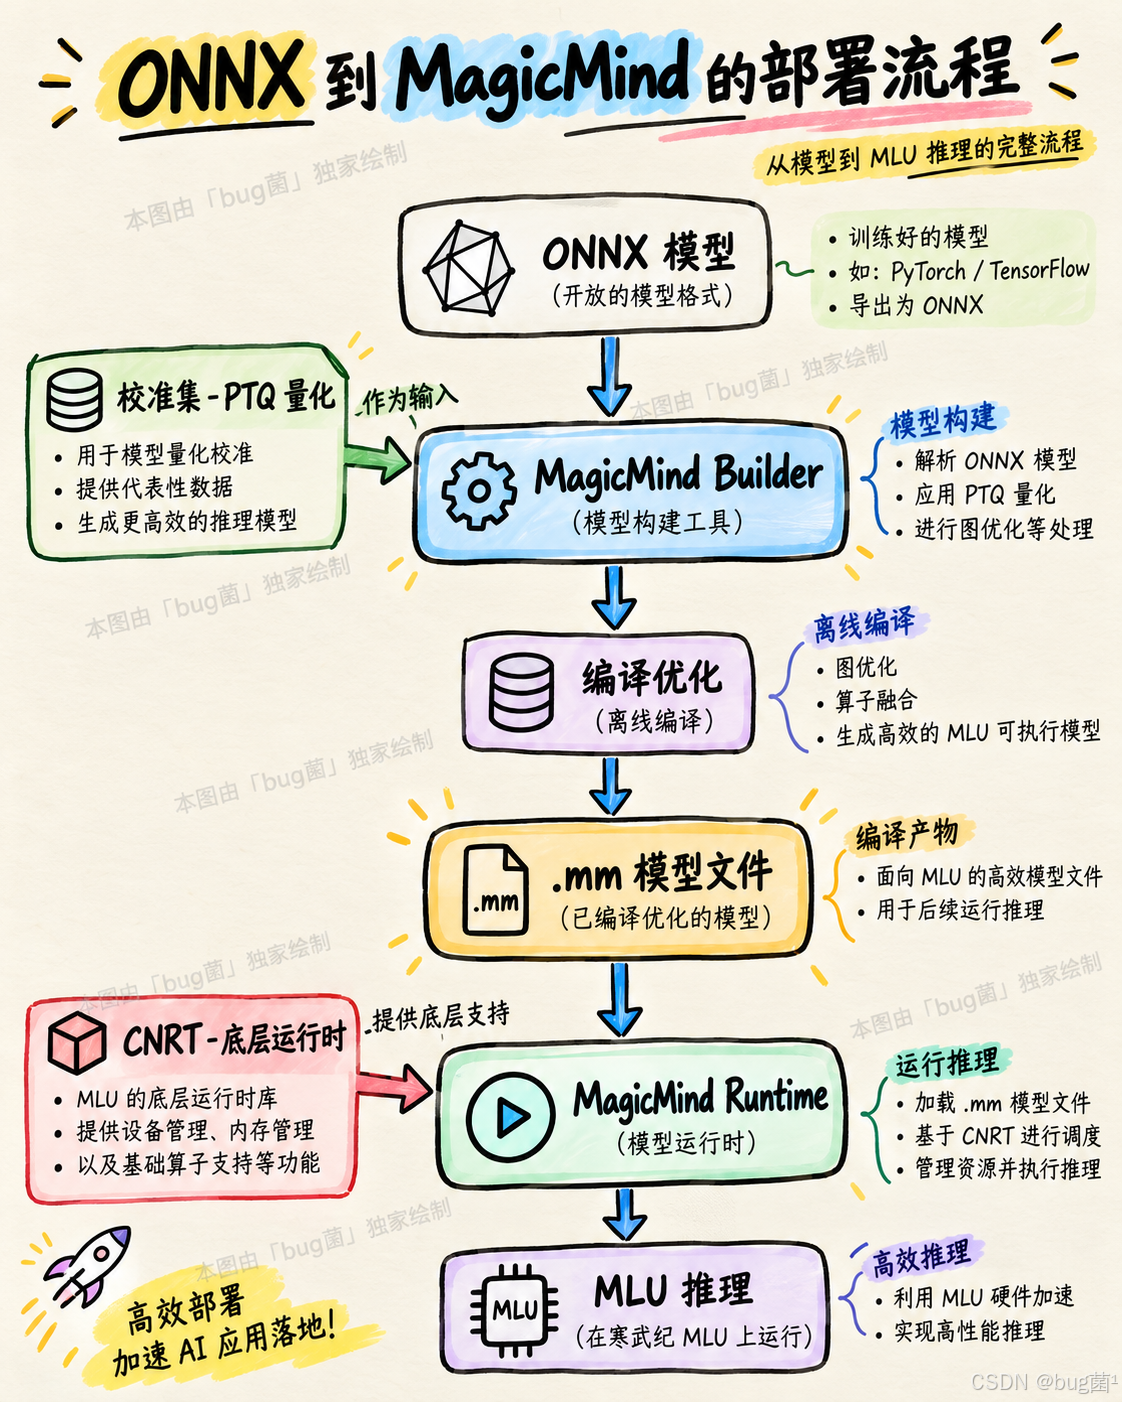
4.1 CNRT 与 MagicMind 工具链
寒武纪的软件生态由两个核心组件构成:
- CNRT(Cambricon Runtime):类似 CUDA Runtime,是底层运行时环境。
- MagicMind:高层推理引擎,支持从 ONNX、PyTorch、TensorFlow 转换模型,提供 Python 和 C++ API。
相关示意图绘制如下,仅供参考:
4.2 MagicMind 转换 YOLOv10
MagicMind 提供了 Python API,转换流程比 ATC 更加直观:
import magicmind.python.runtime as mm
import numpy as np

# ========== 创建 MagicMind Builder ==========
builder = mm.Builder()
network = mm.Network()
config = mm.BuilderConfig()

# ========== 配置量化参数 ==========
config.parse_from_string("""
{
    "archs": ["mtp_592"],
    "precision": "qint8_mixed_float16",
    "batch_size": [1],
    "input_shapes": [[1, 3, 640, 640]],
    "quantization": {
        "calibration_method": "linear_scale",
        "data_num": 200
    }
}
""")

# ========== 解析 ONNX 模型 ==========
parser = mm.OnnxParser(network)
status = parser.parse('yolov10n.onnx', 'images')
if status.ok() is False:
    print(f"ONNX 解析失败: {status.error_message()}")
    exit(1)

# ========== 准备量化校准数据 ==========
def get_calibration_data(dataset_path, num_samples=200):
    """加载量化校准图片"""
    import os
    import cv2

    images = []
    for fname in os.listdir(dataset_path)[:num_samples]:
        if fname.endswith(('.jpg', '.png')):
            img = cv2.imread(os.path.join(dataset_path, fname))
            img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
            img = cv2.resize(img, (640, 640))
            img = img.astype(np.float32) / 255.0
            img = np.transpose(img, (2, 0, 1))  # HWC -> CHW
            images.append(img)

    return np.stack(images, axis=0)  # [N, C, H, W]

calib_data = get_calibration_data('./calibration_images')

# ========== 构建模型 ==========
calibrator = mm.DataCalibrator(calib_data)
model = builder.build_model('yolov10n_mlu', network, config, calibrator)
if model is None:
    print("模型构建失败!")
    exit(1)

# ========== 序列化保存 ==========
status = model.serialize_to_file('yolov10n.mm')
if status.ok() is False:
    print(f"模型保存失败: {status.error_message()}")
    exit(1)

print("寒武纪 MLU 模型转换完成: yolov10n.mm")
4.3 MLU 推理示例
import magicmind.python.runtime as mm
import numpy as np
import cv2

# ========== 加载模型 ==========
model = mm.Model()
model.deserialize_from_file('yolov10n.mm')

# ========== 创建推理引擎 ==========
engine = model.create_i_engine()
context = engine.create_i_context()

# ========== 创建输入输出张量 ==========
inputs = context.create_inputs()
outputs = []
for i in range(engine.get_output_num()):
    outputs.append(mm.Tensor())

# ========== 预处理函数 ==========
def preprocess(img_path):
    img = cv2.imread(img_path)
    img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
    img = cv2.resize(img, (640, 640))
    img = img.astype(np.float32) / 255.0
    img = np.transpose(img, (2, 0, 1))[np.newaxis, :]  # 添加 batch 维度
    return np.ascontiguousarray(img)

# ========== 执行推理 ==========
img_data = preprocess('test.jpg')
inputs[0].from_numpy(img_data)

# 推理
status = context.execute(inputs, outputs)
if status.ok() is False:
    print(f"推理失败: {status.error_message()}")
    exit(1)

# ========== 解析输出 ==========
output_np = outputs[0].asnumpy()
print(f"输出形状: {output_np.shape}")  # 预期: [1, 84, 8400]

# 释放资源
del context
del engine
del model
print("推理完成,资源已释放")
五、三平台横向对比与选型指南
学完了三个平台的基本流程,有必要做个系统性的横向比较,帮助你在实际项目中做出正确的技术选型。
5.1 全方位对比矩阵
| 对比维度 | RKNN (瑞芯微) | Ascend (华为昇腾) | MLU (寒武纪) |
|---|---|---|---|
| 主要场景 | 消费电子、边缘盒子 | 工业推理、边云协同 | 云端大规模推理 |
| 典型算力 | 6 TOPS (RK3588) | 22 TOPS (310P) | 256 TOPS (MLU370) |
| 功耗 | 5~10W | 8~15W | 75W+ |
| 价格区间 | 百元级别 SoC | 千元级别模块 | 万元级别加速卡 |
| 转换工具 | RKNN-Toolkit2 | ATC | MagicMind |
| 推理 API | RKNN C API / Python | ACL / pyACL | CNRT / MagicMind |
| ONNX 支持 | 良好 (opset ≤ 12) | 较好 (opset ≤ 13) | 良好 (opset ≤ 13) |
| 量化支持 | INT8 / FP16 混合 | INT8 / FP16 混合 | INT8 / INT4 混合 |
| 社区活跃度 | 较活跃 (GitHub) | 一般 (官方文档为主) | 较少 |
| 文档质量 | 中等 | 较好 | 一般 |
| Docker 支持 | 有限 | 官方镜像支持 | 官方镜像支持 |
5.2 如何做技术选型
这张表看起来很全,但实际决策时,最关键的往往就是这三个问题:
第一问:目标设备是什么?
如果客户给的是搭载 RK3588/RK3566 的边缘盒子或工控机,答案就是 RKNN,没什么可纠结的。如果是华为云或昇腾服务器,就是 Ascend。如果是云端大规模部署,寒武纪 MLU 或者英伟达 A100 都值得考虑。
第二问:功耗预算有多少?
IoT 设备、电池供电设备、户外监控——功耗第一,优先 RKNN。室内工控场景有稳定电源——性能第一,优先 Ascend 310P。数据中心部署——ROI 第一,算力密度最重要,寒武纪或者国产替代 GPU 都可以。
第三问:项目的迭代周期多长?
如果是快速交付的项目,建议选生态更成熟、工具链更完善的平台——目前来看是 RKNN(边缘)或 Ascend(工业)。如果是长期稳定维护的平台型产品,可以投入更多时间去啃 MLU 的文档和工具链。
六、通用适配框架:一套方法论走遍所有国产 NPU
做了这么多平台的适配之后,我逐渐总结出了一套通用的方法论。这套方法论不依赖于具体的芯片型号,只要是 NPU 类型的推理硬件,基本都可以套用。
6.1 适配流程总览
相关示意图绘制如下,仅供参考:
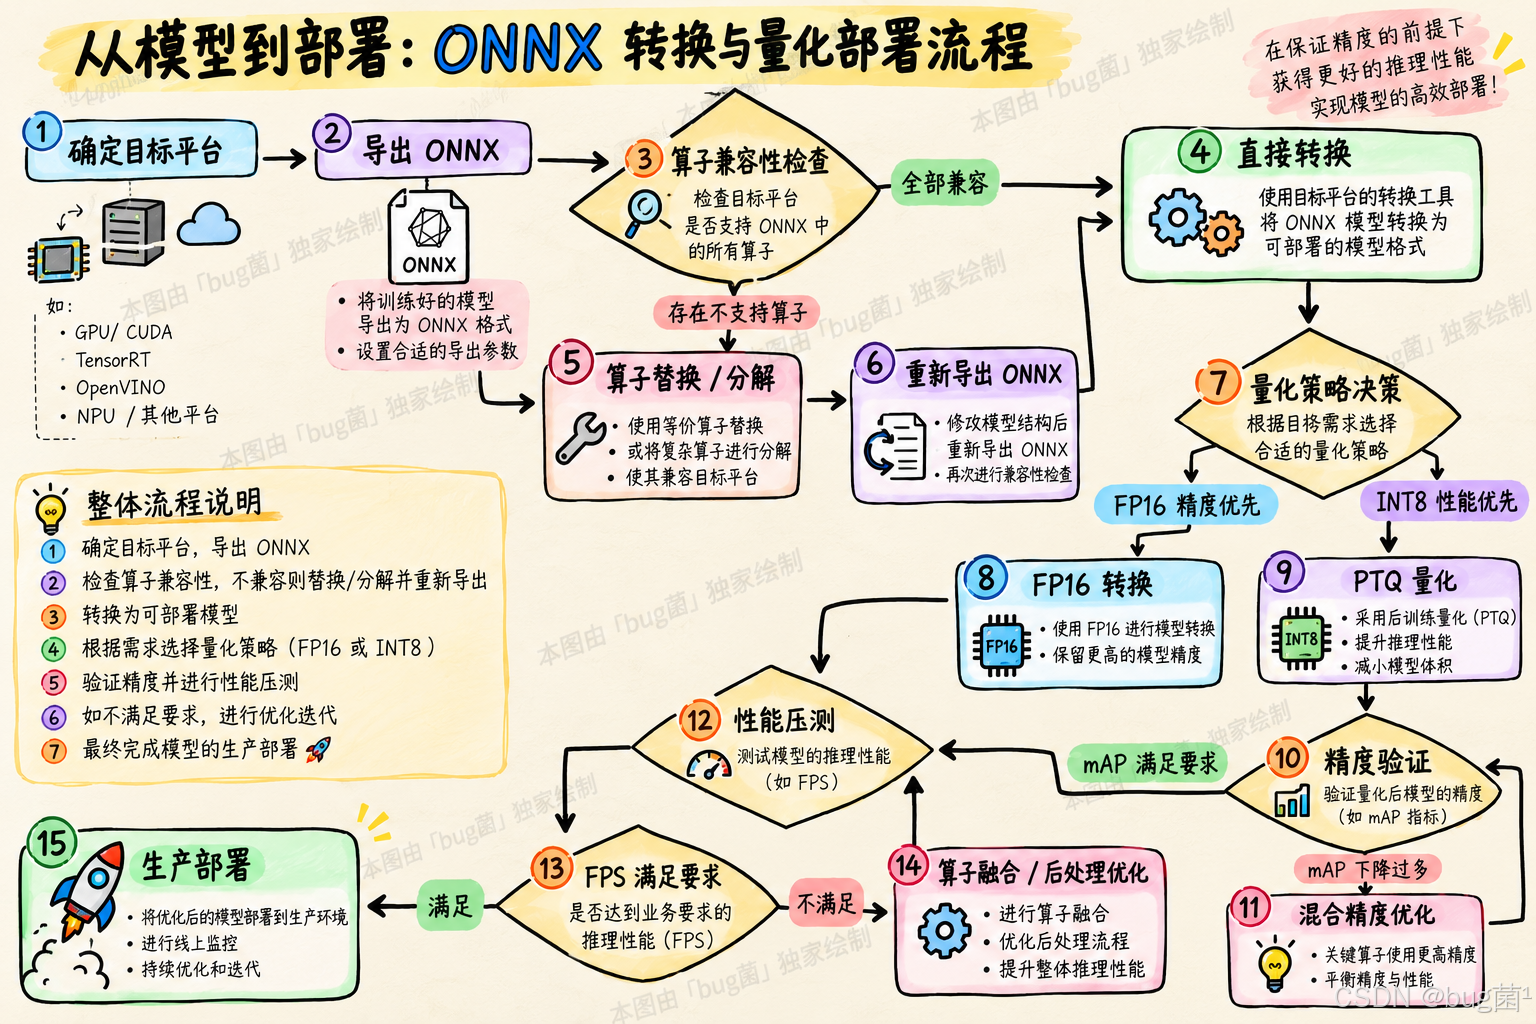
这张图把整个适配流程说清楚了,但我想在几个关键分叉点上再展开讲讲。
6.2 算子兼容性检查工具
在动手转换之前,先做算子扫描是非常重要的习惯。不同平台的算子检查方式不同,但可以封装成统一接口:
import onnx
from onnx import helper

# ========== 通用 ONNX 算子扫描脚本 ==========

# 各平台已知支持的算子白名单(基于官方文档整理,需定期更新)
PLATFORM_OP_WHITELIST = {
    'rknn_rk3588': {
        'Conv', 'ConvTranspose', 'BatchNormalization', 'Add', 'Mul', 'Relu',
        'LeakyRelu', 'Sigmoid', 'MaxPool', 'AveragePool', 'GlobalAveragePool',
        'Reshape', 'Transpose', 'Concat', 'Split', 'Squeeze', 'Unsqueeze',
        'Resize', 'Upsample', 'Flatten', 'Gemm', 'MatMul', 'Softmax',
        'HardSwish', 'HardSigmoid', 'Clip',
        # 注意: SiLU 不在列表中,需要手动分解
    },
    'ascend_310p': {
        'Conv', 'ConvTranspose', 'BatchNormalization', 'Add', 'Mul', 'Relu',
        'LeakyRelu', 'Sigmoid', 'Silu', 'Mish', 'MaxPool', 'AveragePool',
        'GlobalAveragePool', 'Reshape', 'Transpose', 'Concat', 'Split',
        'Squeeze', 'Unsqueeze', 'Resize', 'Flatten', 'Gemm', 'MatMul',
        'Softmax', 'LayerNormalization', 'HardSwish',
    },
    'mlu370': {
        'Conv', 'ConvTranspose', 'BatchNormalization', 'Add', 'Mul', 'Relu',
        'LeakyRelu', 'Sigmoid', 'Silu', 'MaxPool', 'AveragePool',
        'GlobalAveragePool', 'Reshape', 'Transpose', 'Concat', 'Split',
        'Squeeze', 'Unsqueeze', 'Resize', 'Flatten', 'Gemm', 'MatMul',
        'Softmax', 'HardSwish', 'HardSigmoid', 'Clip',
    }
}

def check_operator_compatibility(onnx_path: str, target_platform: str) -> dict:
    """
    检查 ONNX 模型与目标平台的算子兼容性

    Returns:
        dict: {
            'supported': [算子列表],
            'unsupported': [算子列表],
            'compatibility_rate': float
        }
    """
    model = onnx.load(onnx_path)
    whitelist = PLATFORM_OP_WHITELIST.get(target_platform, set())

    if not whitelist:
        print(f"警告: 未找到平台 '{target_platform}' 的算子白名单,请手动确认。")
        return {}

    # 统计模型中使用的所有算子
    op_counter = {}
    for node in model.graph.node:
        op_type = node.op_type
        if op_type not in op_counter:
            op_counter[op_type] = 0
        op_counter[op_type] += 1

    # 分类: 支持 vs 不支持
    supported = {}
    unsupported = {}
    for op, count in op_counter.items():
        if op in whitelist:
            supported[op] = count
        else:
            unsupported[op] = count

    # 计算兼容率(按节点数量统计)
    total_nodes = sum(op_counter.values())
    unsupported_nodes = sum(unsupported.values())
    compat_rate = (total_nodes - unsupported_nodes) / total_nodes * 100

    # 打印报告
    print(f"\n{'='*50}")
    print(f"  算子兼容性分析报告 - 目标平台: {target_platform}")
    print(f"{'='*50}")
    print(f"  总算子节点数:       {total_nodes}")
    print(f"  兼容节点数:         {total_nodes - unsupported_nodes}")
    print(f"  不兼容节点数:       {unsupported_nodes}")
    print(f"  整体兼容率:         {compat_rate:.1f}%")

    if unsupported:
        print(f"\n  ⚠️  发现 {len(unsupported)} 种不兼容算子:")
        for op, count in sorted(unsupported.items(), key=lambda x: x[1], reverse=True):
            print(f"     - {op}: {count} 个节点 → 需要手动处理")
    else:
        print("\n  ✅ 全部算子兼容,可直接转换!")

    print(f"{'='*50}\n")

    return {
        'supported': supported,
        'unsupported': unsupported,
        'compatibility_rate': compat_rate
    }

# ========== 使用示例 ==========
if __name__ == '__main__':
    result = check_operator_compatibility('yolov10n.onnx', 'rknn_rk3588')

    if result.get('compatibility_rate', 0) < 100:
        print("建议:请参考上方报告,对不兼容算子进行替换处理后再转换。")
    else:
        print("模型可直接进行 RKNN 转换。")
6.3 量化精度评估与恢复
精度损失是 NPU 部署中最常见的坑。我们需要一个系统化的方法来诊断和解决这个问题。
import numpy as np
import cv2
from pathlib import Path
from pycocotools.coco import COCO
from pycocotools.cocoeval import COCOeval

# ========== 精度评估框架 ==========

def compute_npu_map(
    rknn_model_path: str,
    val_images_dir: str,
    val_annotations: str,
    conf_thresh: float = 0.001,
    iou_thresh: float = 0.65,
    num_samples: int = 500
):
    """
    评估 NPU 量化模型的 mAP 精度
    与原始 FP32 模型进行对比,计算精度保留率

    Args:
        rknn_model_path: RKNN 量化模型路径
        val_images_dir: 验证集图片目录
        val_annotations: COCO 格式标注文件路径
        conf_thresh: 置信度阈值(设置低一点以确保召回率)
        iou_thresh: NMS IOU 阈值
        num_samples: 评估样本数(越多越准,越慢)

    Returns:
        dict: mAP50, mAP50-95, 推理延迟等指标
    """
    from rknn.api import RKNN
    import time

    # 加载 RKNN 模型
    rknn = RKNN()
    rknn.load_rknn(rknn_model_path)
    rknn.init_runtime(target='rk3588')

    # 加载验证集标注
    coco_gt = COCO(val_annotations)
    image_ids = list(coco_gt.imgs.keys())[:num_samples]

    coco_results = []
    latencies = []

    for img_id in image_ids:
        # 获取图片信息
        img_info = coco_gt.loadImgs(img_id)[0]
        img_path = Path(val_images_dir) / img_info['file_name']

        if not img_path.exists():
            continue

        # 预处理
        img_orig = cv2.imread(str(img_path))
        orig_h, orig_w = img_orig.shape[:2]
        img = cv2.cvtColor(img_orig, cv2.COLOR_BGR2RGB)
        img = cv2.resize(img, (640, 640))

        # 推理并计时
        t_start = time.perf_counter()
        outputs = rknn.inference(inputs=[img])
        t_end = time.perf_counter()
        latencies.append((t_end - t_start) * 1000)

        # 后处理:解析检测框
        output = outputs[0].reshape(84, 8400).T  # [8400, 84]

        # 分离类别分数和边界框
        scores = output[:, :80]   # [8400, 80]
        boxes = output[:, 80:]    # [8400, 4]  格式: [cx, cy, w, h]

        # 找到每个 anchor 的最高类别分数
        max_scores = np.max(scores, axis=1)  # [8400]
        max_cls = np.argmax(scores, axis=1)  # [8400]

        # 置信度过滤
        mask = max_scores > conf_thresh
        if not mask.any():
            continue

        filtered_boxes = boxes[mask]
        filtered_scores = max_scores[mask]
        filtered_cls = max_cls[mask]

        # 坐标转换: [cx, cy, w, h] -> [x1, y1, x2, y2]
        x1 = (filtered_boxes[:, 0] - filtered_boxes[:, 2] / 2)
        y1 = (filtered_boxes[:, 1] - filtered_boxes[:, 3] / 2)
        x2 = (filtered_boxes[:, 0] + filtered_boxes[:, 2] / 2)
        y2 = (filtered_boxes[:, 1] + filtered_boxes[:, 3] / 2)

        # 缩放回原始图片尺寸
        x1 = x1 * orig_w / 640
        y1 = y1 * orig_h / 640
        x2 = x2 * orig_w / 640
        y2 = y2 * orig_h / 640

        # 构建 COCO 格式结果
        for i in range(len(filtered_scores)):
            coco_results.append({
                'image_id': img_id,
                'category_id': int(filtered_cls[i]) + 1,  # COCO 类别从 1 开始
                'bbox': [float(x1[i]), float(y1[i]),
                         float(x2[i] - x1[i]), float(y2[i] - y1[i])],  # [x, y, w, h]
                'score': float(filtered_scores[i])
            })

    # 计算 mAP
    if not coco_results:
        print("警告: 没有检测到任何目标,请检查置信度阈值和模型输出。")
        return {}

    coco_dt = coco_gt.loadRes(coco_results)
    coco_eval = COCOeval(coco_gt, coco_dt, 'bbox')
    coco_eval.params.imgIds = image_ids
    coco_eval.evaluate()
    coco_eval.accumulate()
    coco_eval.summarize()

    avg_latency = np.mean(latencies[10:])  # 去掉前 10 次 warm-up

    results = {
        'mAP50': coco_eval.stats[1],
        'mAP50-95': coco_eval.stats[0],
        'avg_latency_ms': avg_latency,
        'fps': 1000 / avg_latency
    }

    rknn.release()
    return results

# ========== 精度损失分析工具 ==========

def analyze_quantization_sensitivity(
    onnx_path: str,
    rknn_model_path: str,
    test_image: str
):
    """
    逐层对比 FP32 和 INT8 的中间输出,定位量化敏感层

    这个函数帮助我们找到量化误差最大的层,
    从而决定哪些层需要保持 FP16 精度
    """
    from rknn.api import RKNN
    import onnxruntime as ort

    # ===== FP32 推理(ONNX Runtime) =====
    sess = ort.InferenceSession(onnx_path)

    img = cv2.imread(test_image)
    img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
    img = cv2.resize(img, (640, 640)).astype(np.float32) / 255.0
    img_nchw = np.transpose(img, (2, 0, 1))[np.newaxis, :]

    # 获取所有中间层输出(需要先用 onnx 添加 output)
    fp32_output = sess.run(None, {'images': img_nchw})[0]

    # ===== INT8 推理(RKNN 仿真) =====
    rknn = RKNN()
    rknn.load_rknn(rknn_model_path)
    rknn.init_runtime()

    img_uint8 = (img * 255).astype(np.uint8)
    int8_output = rknn.inference(inputs=[img_uint8])[0]

    # ===== 对比最终输出的差异 =====
    fp32_flat = fp32_output.flatten()
    int8_flat = int8_output.flatten()

    # 计算相对误差
    abs_diff = np.abs(fp32_flat - int8_flat)
    rel_diff = abs_diff / (np.abs(fp32_flat) + 1e-6)

    print(f"\n量化误差分析:")
    print(f"  最大绝对误差: {abs_diff.max():.4f}")
    print(f"  平均绝对误差: {abs_diff.mean():.4f}")
    print(f"  最大相对误差: {rel_diff.max():.2%}")
    print(f"  平均相对误差: {rel_diff.mean():.2%}")

    # 如果平均相对误差 > 5%,建议使用混合精度
    if rel_diff.mean() > 0.05:
        print(f"\n  ⚠️  量化误差较大,建议启用混合精度量化。")
        print(f"  推荐操作: 运行 hybrid_quantization_step1() 获取敏感层列表")
    else:
        print(f"\n  ✅ 量化精度良好,可直接部署。")

    rknn.release()
    return rel_diff.mean()
6.4 后处理的 CPU 卸载优化
YOLOv10 的后处理(NMS、坐标转换)在 NPU 上通常无法高效执行,需要在 CPU 上完成。但如果后处理写得不够高效,反而会成为瓶颈。
下面是一个向量化优化的后处理实现:
import numpy as np

def yolov10_postprocess_vectorized(
    output: np.ndarray,      # 模型输出, 形状 [1, 84, 8400]
    orig_shape: tuple,       # 原始图片尺寸 (h, w)
    input_shape: tuple = (640, 640),  # 模型输入尺寸
    conf_thresh: float = 0.25,
    iou_thresh: float = 0.45
) -> list:
    """
    向量化实现的 YOLOv10 后处理
    避免 Python 循环,使用 numpy 广播实现高效处理

    Args:
        output: NPU 输出的原始张量
        orig_shape: (H, W) 原始图片尺寸,用于坐标还原
        conf_thresh: 置信度过滤阈值
        iou_thresh: NMS 的 IOU 阈值

    Returns:
        list of [x1, y1, x2, y2, conf, cls_id]
    """
    # 输入形状: [1, 84, 8400] -> [8400, 84]
    output = output[0].T  # [8400, 84]

    # 分离类别分数和边界框
    class_scores = output[:, :80]   # [8400, 80]
    box_coords   = output[:, 80:]   # [8400, 4], 格式 [cx, cy, w, h]

    # 向量化求最大类别分数
    conf = np.max(class_scores, axis=1)   # [8400]
    cls  = np.argmax(class_scores, axis=1) # [8400]

    # 置信度过滤(numpy 布尔索引,比 for 循环快 10x)
    mask = conf > conf_thresh
    conf = conf[mask]
    cls  = cls[mask]
    box  = box_coords[mask]  # [N, 4]

    if len(conf) == 0:
        return []

    # 坐标转换: [cx, cy, w, h] -> [x1, y1, x2, y2]
    boxes_xyxy = np.zeros_like(box)
    boxes_xyxy[:, 0] = box[:, 0] - box[:, 2] / 2  # x1
    boxes_xyxy[:, 1] = box[:, 1] - box[:, 3] / 2  # y1
    boxes_xyxy[:, 2] = box[:, 0] + box[:, 2] / 2  # x2
    boxes_xyxy[:, 3] = box[:, 1] + box[:, 3] / 2  # y2

    # 缩放到原始图片坐标
    scale_x = orig_shape[1] / input_shape[1]
    scale_y = orig_shape[0] / input_shape[0]
    boxes_xyxy[:, [0, 2]] *= scale_x
    boxes_xyxy[:, [1, 3]] *= scale_y

    # 坐标裁剪,防止越界
    boxes_xyxy[:, 0] = np.clip(boxes_xyxy[:, 0], 0, orig_shape[1])
    boxes_xyxy[:, 1] = np.clip(boxes_xyxy[:, 1], 0, orig_shape[0])
    boxes_xyxy[:, 2] = np.clip(boxes_xyxy[:, 2], 0, orig_shape[1])
    boxes_xyxy[:, 3] = np.clip(boxes_xyxy[:, 3], 0, orig_shape[0])

    # ===== NMS(非极大值抑制) =====
    # 按类别分别做 NMS
    final_detections = []

    for class_id in np.unique(cls):
        class_mask = cls == class_id
        class_boxes = boxes_xyxy[class_mask]
        class_scores_filtered = conf[class_mask]

        # 按置信度降序排列
        order = np.argsort(class_scores_filtered)[::-1]
        class_boxes = class_boxes[order]
        class_scores_filtered = class_scores_filtered[order]

        # 标准 NMS 实现
        keep = []
        while len(class_boxes) > 0:
            keep.append(0)
            if len(class_boxes) == 1:
                break

            # 计算第一个框与其余框的 IOU
            x1 = np.maximum(class_boxes[0, 0], class_boxes[1:, 0])
            y1 = np.maximum(class_boxes[0, 1], class_boxes[1:, 1])
            x2 = np.minimum(class_boxes[0, 2], class_boxes[1:, 2])
            y2 = np.minimum(class_boxes[0, 3], class_boxes[1:, 3])

            inter = np.maximum(0, x2 - x1) * np.maximum(0, y2 - y1)
            area1 = (class_boxes[0, 2] - class_boxes[0, 0]) * (class_boxes[0, 3] - class_boxes[0, 1])
            area2 = (class_boxes[1:, 2] - class_boxes[1:, 0]) * (class_boxes[1:, 3] - class_boxes[1:, 1])
            iou = inter / (area1 + area2 - inter + 1e-6)

            # 保留 IOU 低于阈值的框
            nms_mask = iou <= iou_thresh
            class_boxes = class_boxes[1:][nms_mask]
            class_scores_filtered = class_scores_filtered[1:][nms_mask]

        for idx in keep:
            final_detections.append([
                *class_boxes[idx].tolist(),
                float(class_scores_filtered[idx]),
                int(class_id)
            ])

    return final_detections
七、多平台统一推理接口设计
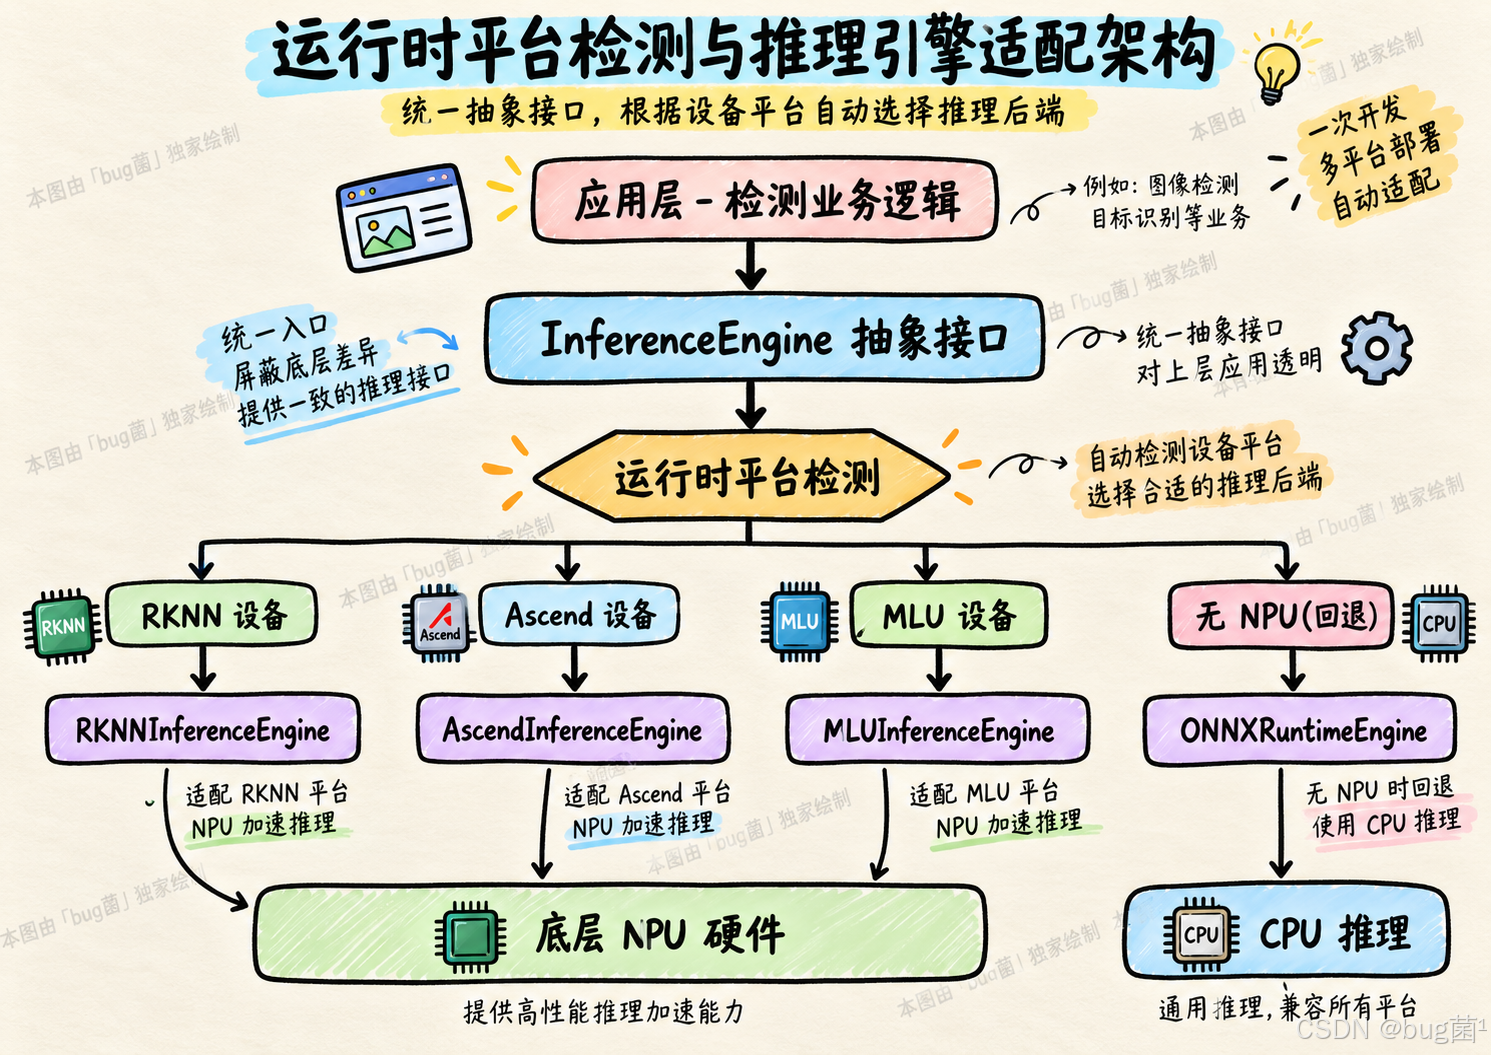
实际项目中,往往需要同一套代码在不同硬件平台上运行。这时候就需要设计一个抽象层,屏蔽底层 NPU API 的差异。
7.1 统一推理接口设计思路
相关示意图绘制如下,仅供参考:
7.2 Python 抽象层实现
from abc import ABC, abstractmethod
import numpy as np
import cv2
from typing import List, Tuple, Optional

# ========== 检测结果数据类 ==========
class Detection:
    """统一的检测结果数据结构"""
    def __init__(self, x1: float, y1: float, x2: float, y2: float,
                 conf: float, cls_id: int, cls_name: str = ''):
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2
        self.conf = conf
        self.cls_id = cls_id
        self.cls_name = cls_name

    @property
    def bbox(self):
        return [self.x1, self.y1, self.x2, self.y2]

    def __repr__(self):
        return (f"Detection(cls={self.cls_name or self.cls_id}, "
                f"conf={self.conf:.2f}, bbox=[{self.x1:.0f},{self.y1:.0f},"
                f"{self.x2:.0f},{self.y2:.0f}])")


# ========== 抽象推理引擎基类 ==========
class BaseInferenceEngine(ABC):
    """
    所有 NPU 推理引擎的抽象基类
    各平台只需继承此类并实现 load_model 和 _run_inference 即可
    """

    def __init__(self, model_path: str, class_names: List[str],
                 input_size: Tuple[int, int] = (640, 640),
                 conf_thresh: float = 0.25, iou_thresh: float = 0.45):
        self.model_path = model_path
        self.class_names = class_names
        self.input_size = input_size
        self.conf_thresh = conf_thresh
        self.iou_thresh = iou_thresh
        self._model = None

        self.load_model(model_path)

    @abstractmethod
    def load_model(self, model_path: str):
        """加载模型,由各子类实现"""
        pass

    @abstractmethod
    def _run_inference(self, input_tensor: np.ndarray) -> np.ndarray:
        """执行底层推理,由各子类实现,返回原始输出张量"""
        pass

    def preprocess(self, image: np.ndarray) -> Tuple[np.ndarray, tuple]:
        """
        统一的预处理流程:BGR -> RGB -> Resize -> 归一化 -> NCHW
        返回预处理后的张量和原始图片尺寸
        """
        orig_shape = image.shape[:2]  # (H, W)
        img = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
        img = cv2.resize(img, self.input_size)
        img = img.astype(np.float32) / 255.0
        img = np.transpose(img, (2, 0, 1))        # HWC -> CHW
        img = np.expand_dims(img, axis=0)          # CHW -> NCHW
        return np.ascontiguousarray(img), orig_shape

    def postprocess(self, output: np.ndarray, orig_shape: tuple) -> List[Detection]:
        """
        统一的后处理流程
        复用上面实现的 yolov10_postprocess_vectorized
        """
        raw_dets = yolov10_postprocess_vectorized(
            output, orig_shape, self.input_size,
            self.conf_thresh, self.iou_thresh
        )

        detections = []
        for det in raw_dets:
            x1, y1, x2, y2, conf, cls_id = det
            cls_name = self.class_names[cls_id] if cls_id < len(self.class_names) else str(cls_id)
            detections.append(Detection(x1, y1, x2, y2, conf, cls_id, cls_name))

        return detections

    def detect(self, image: np.ndarray) -> List[Detection]:
        """
        完整推理流程:预处理 -> 推理 -> 后处理
        这是对外暴露的统一接口
        """
        input_tensor, orig_shape = self.preprocess(image)
        raw_output = self._run_inference(input_tensor)
        return self.postprocess(raw_output, orig_shape)

    @abstractmethod
    def release(self):
        """释放模型资源,由各子类实现"""
        pass

    def __del__(self):
        self.release()

    def __enter__(self):
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        self.release()


# ========== RKNN 推理引擎 ==========
class RKNNInferenceEngine(BaseInferenceEngine):
    """瑞芯微 RKNN 推理引擎"""

    def load_model(self, model_path: str):
        try:
            from rknn.api import RKNN
            self._model = RKNN()
            ret = self._model.load_rknn(model_path)
            if ret != 0:
                raise RuntimeError(f"加载 RKNN 模型失败: {model_path}")
            ret = self._model.init_runtime(target='rk3588')
            if ret != 0:
                raise RuntimeError("初始化 RKNN 运行时失败")
            print(f"[RKNNEngine] 模型加载成功: {model_path}")
        except ImportError:
            raise ImportError("rknn 库未安装,请安装 RKNN-Toolkit-Lite2")

    def _run_inference(self, input_tensor: np.ndarray) -> np.ndarray:
        # RKNN 输入需要 uint8 格式
        img_uint8 = (input_tensor[0].transpose(1, 2, 0) * 255).astype(np.uint8)
        outputs = self._model.inference(inputs=[img_uint8])
        return outputs[0]

    def release(self):
        if self._model is not None:
            self._model.release()
            self._model = None


# ========== ONNXRuntime 回退引擎(CPU) ==========
class ONNXRuntimeEngine(BaseInferenceEngine):
    """
    基于 ONNXRuntime 的 CPU 推理引擎
    当 NPU 不可用时作为回退选项,保证代码在任何机器上都能运行
    """

    def load_model(self, model_path: str):
        import onnxruntime as ort
        providers = ['CUDAExecutionProvider', 'CPUExecutionProvider']
        self._model = ort.InferenceSession(model_path, providers=providers)
        print(f"[ONNXEngine] 模型加载成功: {model_path}, "
              f"执行设备: {self._model.get_providers()[0]}")

    def _run_inference(self, input_tensor: np.ndarray) -> np.ndarray:
        input_name = self._model.get_inputs()[0].name
        outputs = self._model.run(None, {input_name: input_tensor})
        return outputs[0]

    def release(self):
        self._model = None  # onnxruntime 无需显式释放


# ========== 推理引擎工厂 ==========
def create_inference_engine(
    model_path: str,
    class_names: List[str],
    backend: str = 'auto',
    **kwargs
) -> BaseInferenceEngine:
    """
    推理引擎工厂函数,根据 backend 参数自动创建对应引擎

    Args:
        backend: 'rknn' | 'ascend' | 'mlu' | 'onnx' | 'auto'
                 'auto' 模式会自动探测可用的 NPU 并选择最优引擎
    """
    if backend == 'auto':
        # 自动探测可用的推理后端
        backend = _detect_available_backend()
        print(f"[Factory] 自动探测到推理后端: {backend}")

    engine_map = {
        'rknn': RKNNInferenceEngine,
        'onnx': ONNXRuntimeEngine,
        # 'ascend': AscendInferenceEngine,  # 可扩展
        # 'mlu': MLUInferenceEngine,        # 可扩展
    }

    engine_cls = engine_map.get(backend)
    if engine_cls is None:
        raise ValueError(f"不支持的推理后端: {backend}, 可选: {list(engine_map.keys())}")

    return engine_cls(model_path, class_names, **kwargs)


def _detect_available_backend() -> str:
    """探测当前系统可用的推理后端"""
    # 尝试导入 RKNN
    try:
        from rknn.api import RKNN
        return 'rknn'
    except ImportError:
        pass

    # 可以继续探测 Ascend、MLU...
    # try:
    #     import acl
    #     return 'ascend'
    # except ImportError:
    #     pass

    # 最终回退到 ONNX CPU
    return 'onnx'


# ========== 使用示例 ==========
if __name__ == '__main__':
    import json

    # 加载类别名称
    with open('coco_classes.json', 'r') as f:
        class_names = json.load(f)

    # 使用上下文管理器自动释放资源
    # 只需切换 model_path 和 backend,其他代码完全不变

    # 场景1: RKNN 部署
    # with create_inference_engine('yolov10n.rknn', class_names, backend='rknn') as engine:

    # 场景2: 开发调试(CPU 回退)
    with create_inference_engine(
        'yolov10n.onnx', class_names, backend='onnx',
        conf_thresh=0.25, iou_thresh=0.45
    ) as engine:

        img = cv2.imread('test.jpg')
        detections = engine.detect(img)

        print(f"检测结果 ({len(detections)} 个目标):")
        for det in detections:
            print(f"  {det}")
            # 在图片上绘制结果
            cv2.rectangle(img,
                         (int(det.x1), int(det.y1)),
                         (int(det.x2), int(det.y2)),
                         (0, 255, 0), 2)
            cv2.putText(img, f"{det.cls_name} {det.conf:.2f}",
                       (int(det.x1), int(det.y1) - 10),
                       cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2)

        cv2.imwrite('result.jpg', img)
        print("结果已保存至 result.jpg")
这个抽象层的设计体现了一个重要的工程原则:依赖接口,不依赖实现。业务代码只调用 engine.detect(image),完全不感知底层是 RKNN 还是 Ascend,这让你的代码在跨平台迁移时只需更换引擎实例,而不需要重写任何业务逻辑。
八、NPU 适配中的常见踩坑汇总
做过这么多国产 NPU 适配项目,我把那些让我掉坑里的问题整理成了这个清单。希望你能少走弯路。
8.1 模型转换层面的坑
坑1:输入数据类型不匹配
RKNN 的 rknn_inputs_set 期望的是 RKNN_TENSOR_UINT8 类型,但如果你在 rknn.config() 里设置了 mean_values 和 std_values,就意味着归一化在 NPU 内部完成,所以传入的确实应该是 uint8 原始像素值。
但很多同学会在 Python 层做了归一化之后再传入,结果就是归一化了两次,输出全乱。这个 bug 非常隐蔽,因为推理不报错,只是结果不对。
坑2:通道顺序搞错
- OpenCV 读取图片默认是 BGR。
- RKNN 模型训练时通常用 RGB。
- 不转换通道,颜色分布错误,模型会把红色误识别为蓝色相关的特征。
记住这条规则:所有图片进模型之前,必须先 cv2.cvtColor(img, cv2.COLOR_BGR2RGB)。
坑3:ONNX opset 版本不一致
ATC 转换时报错:
E: Graph node 'onnx::Gather_231' type 'Gather' with indices type int64 is not support.
这是因为 Gather 算子在高版本 opset 中允许 int64 索引,但昇腾 310 只支持 int32。解决方法是导出 ONNX 时指定 opset=11。
8.2 量化层面的坑
坑4:校准集与验证集分布不一致
校准集全是白天室外场景,但实际部署场景是夜晚室内——量化结果惨不忍睹。
正确做法:校准集要尽量覆盖实际推理时会遇到的所有场景分布。如果条件不允许,可以增大校准集数量(比如 1000 张),并确保多样性。
坑5:第一个 Conv 层量化误差放大
第一个卷积层负责提取底层纹理特征,对量化最敏感。如果量化后精度崩溃,第一步是把第一个 Conv 层设为 FP16,往往能立即恢复大半精度。
# 在 RKNN hybrid_proposal.txt 中
model.0.conv,0   # 第一个卷积层不量化,保持 FP16
坑6:量化后 NMS 结果变差
不是 NMS 的问题,是边界框坐标的量化误差导致 IOU 计算偏差,让本来该被 NMS 合并的框存活了下来,表现为大量重叠检测框。
解决方法:适当提高 NMS 的 IOU 阈值(比如从 0.45 提到 0.5),或者将输出头的解码层设为 FP16。
8.3 工程集成层面的坑
坑7:多线程推理导致显存溢出
在多路视频并发推理场景下,如果多个线程共享同一个 rknn_context,会发生数据竞争,导致输出错乱甚至崩溃。
正确做法:每个推理线程维护独立的 context。RKNN 支持从同一个 .rknn 文件多次 rknn_init,每次得到独立的 context:
// 错误:多线程共享 ctx
rknn_context ctx;
rknn_init(&ctx, model_path, 0, 0, NULL);
// 线程1 和 线程2 都用 ctx 推理 ← 崩溃!

// 正确:每个线程独立 ctx
void thread_func(const char* model_path) {
    rknn_context ctx;
    rknn_init(&ctx, model_path, 0, 0, NULL);  // 每个线程各自初始化
    // 只在本线程内使用 ctx
    rknn_destroy(ctx);
}
坑8:板端时钟频率未锁定
在 RK3588 上,NPU 频率默认是动态调节的。在低负载时 NPU 会降频以省电,导致推理延迟不稳定——同样的模型,有时 25ms,有时 80ms,让你以为是代码问题。
锁定 NPU 频率:
# 查看当前 NPU 频率
cat /sys/class/devfreq/fdab0000.npu/cur_freq

# 锁定 NPU 到最高频率
echo performance > /sys/class/devfreq/fdab0000.npu/governor

# 或者指定具体频率(单位 Hz)
echo 1000000000 > /sys/class/devfreq/fdab0000.npu/min_freq
echo 1000000000 > /sys/class/devfreq/fdab0000.npu/max_freq
九、国产 NPU 生态的未来展望
写到这里,有些感触想和你分享。
做国产 NPU 适配这件事,说实话并不轻松。那种在深夜对着一行错误信息反复查文档、改参数、再编译、再测试的体验,是每个做过嵌入式 AI 部署的工程师都经历过的。国产芯片的文档质量和生态成熟度与英伟达相比确实还有差距,这是必须承认的现实。
但另一面是:这个差距正在快速缩小。华为 CANN 的更新节奏越来越快,瑞芯微的 RKNN-Toolkit2 每次大版本都在新增算子支持,寒武纪也在积极适配更多主流模型。更重要的是,随着越来越多的工程师把踩坑经验沉淀下来,整个社区的知识库正在快速积累。
作为工程师,我们能做的是:
- 建立方法论,而不是死记硬背操作步骤——因为工具链会变,但"算子检查 → 量化 → 精度验证 → 性能压测"的核心流程不会变。
- 拥抱抽象层设计,让代码具备平台无关性——今天是 RKNN,明天可能是新出的 XX-NPU,好的架构让迁移成本极低。
- 积极参与社区,遇到问题先在 GitHub Issues 搜索,能解决就解决,解决了就分享——这是工程师能为整个生态做出的最直接贡献。
国产 AI 芯片的崛起,不仅仅是商业层面的国产替代,更是整个 AI 工程领域多元化发展的重要力量。能参与其中,做一个有点用的技术布道者,挺好的。
下期预告
下一节我们进入第14节:Docker 容器化部署 YOLOv10:环境固化与一键启动。
如果你做过超过三次 YOLOv10 的部署,一定对这个场景有深刻体会:在自己的机器上跑得好好的,一到客户服务器就出现各种奇怪的依赖冲突——CUDA 版本不对、PyTorch 和 ultralytics 版本冲突、甚至连 Python 版本都成了问题。
Docker 就是为解决这类"在我电脑上明明能跑"的问题而生的。通过容器化,我们可以:
- 环境固化:把整个运行环境打包成镜像,保证在任何机器上行为一致。
- 一键启动:用
docker-compose up一行命令拉起完整的检测服务。 - 版本管理:通过镜像 tag 管理不同模型版本,随时回滚。
- 资源隔离:多个推理服务独立运行,互不干扰。
下一节我们会从 Dockerfile 的编写规范入手,系统讲解:
- 如何构建最小化的 YOLOv10 推理镜像(基于 CUDA 基础镜像,目标是压缩体积到 3GB 以内)。
- 如何使用多阶段构建分离编译环境和运行环境。
- 如何用
docker-compose.yml定义完整的服务栈,包括推理服务、Redis 队列和结果存储。 - 如何在 Docker 容器内访问宿主机 GPU,以及常见的
nvidia-container-toolkit配置问题。 - 如何构建支持多架构(x86_64 + ARM64)的镜像,让同一套镜像既能跑在云服务器上,又能跑在 Jetson 或 RK3588 开发板上。
如果你在实际项目中遇到过环境配置的噩梦,下一节应该会让你如获至宝。我们下一节见。
📌 附录
相关参考资料
- YOLOv10 官方论文:YOLOv10: Real-Time End-to-End Object Detection,Wang et al., 2024,arXiv: 2405.14458
- YOLOv10 核心机制:Consistent Dual Assignments(一致性双重标签分配)
- YOLOv10 端到端检测机制:One-to-Many + One-to-One Dual Assignments
- YOLOv10 高效模型设计:Holistic Efficiency-Accuracy Driven Model Design
- YOLOv10 NMS-Free 推理:End-to-End Object Detection without NMS
- DFL 相关:Generalized Focal Loss: Learning Qualified and Distributed Bounding Boxes for Dense Object Detection
- COCO 数据集基准:https://cocodataset.org
- YOLOv10 官方仓库:https://github.com/THU-MIG/yolov10
- PyTorch 官方安装指南:https://pytorch.org/get-started/locally/
- NVIDIA CUDA Toolkit 归档:https://developer.nvidia.com/cuda-toolkit-archive
- Miniconda 下载:https://docs.conda.io/en/latest/miniconda.html
- 本节所有脚本代码:见文章各代码块,可直接复制使用
COCO:
| Model | Test Size | AP^val | Params | FLOPs | Latency |
|---|---|---|---|---|---|
| YOLOv10-N | 640 | 38.5% | 2.3M | 6.7G | 1.84 ms |
| YOLOv10-S | 640 | 46.3% | 7.2M | 21.6G | 2.49 ms |
| YOLOv10-M | 640 | 51.1% | 15.4M | 59.1G | 4.74 ms |
| YOLOv10-B | 640 | 52.5% | 19.1M | 92.0G | 5.74 ms |
| YOLOv10-L | 640 | 53.2% | 24.4M | 120.3G | 7.28 ms |
| YOLOv10-X | 640 | 54.4% | 29.5M | 160.4G | 10.70 ms |
希望本文围绕 YOLOv10 的实战讲解,能够在以下几个维度上切实帮助到你:
- 🎯 模型精度提升:结合 YOLOv10 的一致性双重标签分配、端到端检测机制与整体效率-精度设计思想,从网络结构、特征融合、检测头、标签分配、损失函数和数据增强等方向展开优化,通过工程实验进一步提升目标检测精度;
- 🚀 推理速度优化:结合 YOLOv10 的 NMS-Free 推理机制,以及模型轻量化、结构重参数化、剪枝、量化、知识蒸馏与部署加速策略,帮助模型在真实业务场景中运行得更快、更稳定;
- 🧩 工程落地实践:覆盖数据准备、环境配置、模型训练、效果评估、问题排查、模型导出与部署推理等完整链路,提供可直接复用或稍加修改即可迁移的工程级方案;
- 🧠 核心机制理解:深入分析 YOLOv10 中 One-to-Many 与 One-to-One 双标签分配机制、一致性匹配度量、端到端检测以及高效网络设计 的设计逻辑,帮助你理解模型性能提升背后的原因,而不是停留在简单调用层面;
- 🔬 改进方案验证:通过消融实验、指标对比与可视化分析,评估不同改进模块对 Precision、Recall、mAP、FPS、Latency、参数量和 FLOPs 的实际影响。
PS:如果你按照文中步骤对 YOLOv10 进行优化后仍然遇到问题,请不必焦虑或灰心。
YOLOv10 是一个涉及网络结构、特征提取、标签分配、梯度优化、端到端预测与部署环境的复杂目标检测框架,最终表现会受到 硬件环境、数据集质量、任务定义、类别分布、训练配置、代码版本与部署平台 等多重因素的共同影响。
这是目标检测项目中十分常见的客观现象,并不意味着某个改进模块一定无效。
如果你在实践过程中遇到以下问题:
- 🐛 模块替换后出现新的报错或 Bug;
- 📉 Precision、Recall 或 mAP 难以继续提升;
- 📈 训练损失异常、梯度不稳定或模型难以收敛;
- 🎯 One-to-One / One-to-Many 分支训练效果异常;
- ⏱️ 推理速度、Latency、显存占用或部署性能不达预期;
- 🔄 修改网络结构后出现维度、通道数或特征层不匹配;
- ⚙️ 修改检测头后端到端预测分支出现兼容性问题;
- 📦 模型导出 ONNX、TensorRT、OpenVINO 等格式时失败;
欢迎将 完整报错信息 + 环境版本 + 关键配置截图 + 网络配置文件 + 核心代码片段 粘贴至评论区,我们可以一起分析问题根因,并探讨更加可行的解决方案。
如果你已经摸索出更优的训练参数、网络结构、标签分配策略、模块组合或部署优化思路,也非常欢迎在评论区分享。
你的每一条实战经验,都可能成为其他开发者解决问题、减少试错成本的关键线索。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对 YOLOv10 的主流改进方案进行重构与再设计,使内容更加贴近工业检测、智慧交通、游戏分析、行为识别、遥感影像、无人机视觉与边缘设备部署等真实应用场景。
🧧🧧 文末福利,等你来拿!🧧🧧
📌 文中所涉及的技术内容,大多来源于本人在 YOLOv10 项目中的一线实践积累,部分案例参考了开源项目、公开论文、技术社区资料与读者反馈。
如有版权相关问题,欢迎第一时间联系,我将尽快核实并进行修改或下线处理。
部分问题分析思路与排查路径参考了技术社区及 AI 问答平台,在此一并致谢 🙏
最后想说的是:
YOLOv10 的优化本质上是一个高度依赖任务、数据和部署环境的系统工程问题,不存在“一招通杀”的银弹方案。
一致性双重标签分配、One-to-Many / One-to-One 检测策略、注意力机制、轻量化卷积、改进检测头、IoU 损失函数、特征融合模块和数据增强策略,都有其适用条件。
某个模块在公开数据集上取得提升,并不意味着它能够在所有自定义数据集、硬件平台和业务场景中获得同样收益。
尤其对于 YOLOv10 而言,在进行结构改进时还需要额外关注 端到端检测分支、标签分配一致性以及 NMS-Free 推理链路。某些直接从 YOLOv8、YOLOv9、YOLOv11 等模型迁移过来的模块,如果没有处理好检测头与训练分支之间的适配关系,也可能出现精度下降、训练不稳定或推理逻辑异常等问题。
真正有效的优化路径,永远源于:
- 对业务目标与评价指标的准确理解;
- 对数据质量和类别分布的持续分析;
- 对模型瓶颈的定位与针对性改进;
- 对 One-to-Many 与 One-to-One 分支机制的正确理解;
- 对实验变量的严格控制;
- 对精度、速度、Latency、参数量和部署成本的综合权衡;
- 以及一轮又一轮可复现的对比实验。
如果你已经在自己的项目中探索出了更加高效、稳定的 YOLOv10 优化路径,非常鼓励你:
- 💬 在评论区简要分享核心思路与实验结论;
- 📊 分享不同模块的消融实验结果;
- 📝 将完整过程整理成教程、博客或系列文章;
- 🔧 提交可复现的配置文件、代码或工程实践经验。
你的经验,或许正是别人卡关已久所缺少的最后一块拼图。
✅ 本期关于 YOLOv10 优化与实战应用 的内容就先聊到这里。
如果你想进一步深入:
- 🔍 系统理解 Consistent Dual Assignments 与 YOLOv10 的整体网络结构;
- 🎯 深入理解 One-to-Many 与 One-to-One 双标签分配机制;
- 🚀 掌握 YOLOv10 无 NMS 端到端目标检测的实现原理;
- 🧱 学习主干网络、颈部网络、检测头与特征融合模块的改进方法;
- 📉 掌握损失函数、匹配度量、样本分配与训练策略的优化技巧;
- ⚡ 对比不同场景下的模型轻量化与部署加速方案;
- 🧪 建立规范的消融实验、指标对比与模型评估流程;
- 🧠 系统构建一套属于自己的 YOLOv10 调优方法论;
欢迎继续关注专栏:《YOLOv10实战:从入门到深度优化》
期待这些内容能够在你的项目中真正落地见效,帮助你 少踩坑、多提效、快验证、稳部署,我们下期见。
✨ 当然,如果 YOLOv10 专栏已经无法满足你,也可以继续关注:
更多新版本、新模块与新论文的工程复现内容,也会持续更新。
✍️ 码字不易,如果这篇文章对你有所启发或帮助,欢迎给我来个 一键三连:关注 + 点赞 + 收藏。
你的支持,是我持续输出高质量 YOLOv10 技术内容与工程实战案例最直接的动力来源。
同时诚挚推荐关注我的技术号: 「猿圈奇妙屋」
在这里,你可以:
- 📡 第一时间获取 YOLOv10、目标检测、多目标追踪与多任务学习等方向的进阶内容;
- 🛠️ 获取视觉算法、深度学习与模型部署的最新优化方案和工程实战经验;
- 📚 学习 PyTorch、OpenCV、ONNX、TensorRT 等相关技术;
- 🎁 获取 BAT 大厂面经、技术书籍 PDF、工程模板与常用工具清单等实用资源。
期待在更多维度上与你一起进步、共同成长。
👨💻 About Me · 关于作者
我是专注于 计算机视觉、图像识别、目标检测与深度学习工程落地 的讲师和技术博主,笔名 bug菌:
- 活跃于 CSDN|稀土掘金|InfoQ|51CTO|华为云开发者社区|阿里云开发者社区|腾讯云开发者社区|开源中国|博客园|墨天轮 等多个技术社区;
- CSDN 博客之星 Top 30、华为云多年度十佳博主及卓越贡献奖获得者、掘金多年度人气作者 Top 40;
- CSDN、掘金、InfoQ、51CTO 等平台签约作者及优质创作者;
- 全网粉丝累计 30w+。
更多高质量技术内容与成长资料,可查看合集入口:
👉 点击查看 👈️
硬核技术号 「猿圈奇妙屋」 期待你的加入,一起进阶、一起打怪升级。
- End -
鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)