昇腾950DT迁移实战:3类组件锁定排查
一句话结论:换加速卡的成本不在框架层,而在依赖链的传递锁定上。**我在做迁移时踩得最惨的一个坑是:**顶层框架写着「支持昇腾」不算数,得看它依赖的算子库支不支持。
背景:换平台第一次有了路径
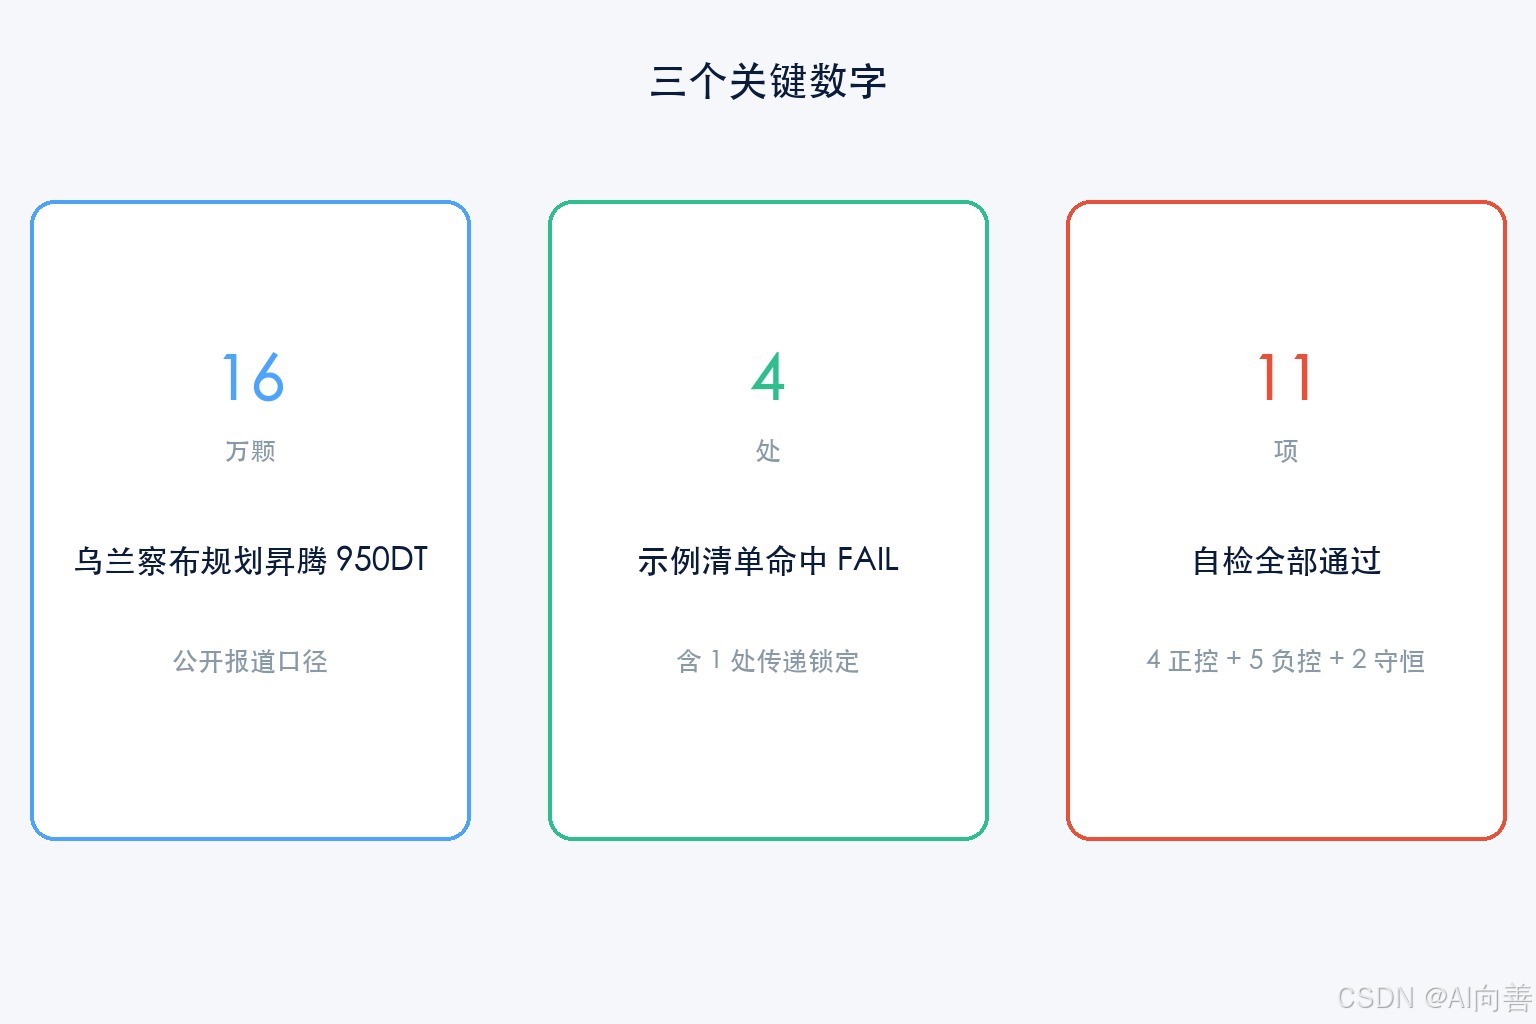
10 月上旬的公开信息里,有一条容易被当成软新闻:DeepSeek 在内蒙古乌兰察布规划建设大型数据中心,部署至少 16 万颗华为昇腾 950DT;同时把面向昇腾平台的整套基础设施组件开源:编译工具、计算库、分布式通信库,与面向英伟达平台的组件一一对应(来源:公开报道,多家中文科技媒体交叉核实)。
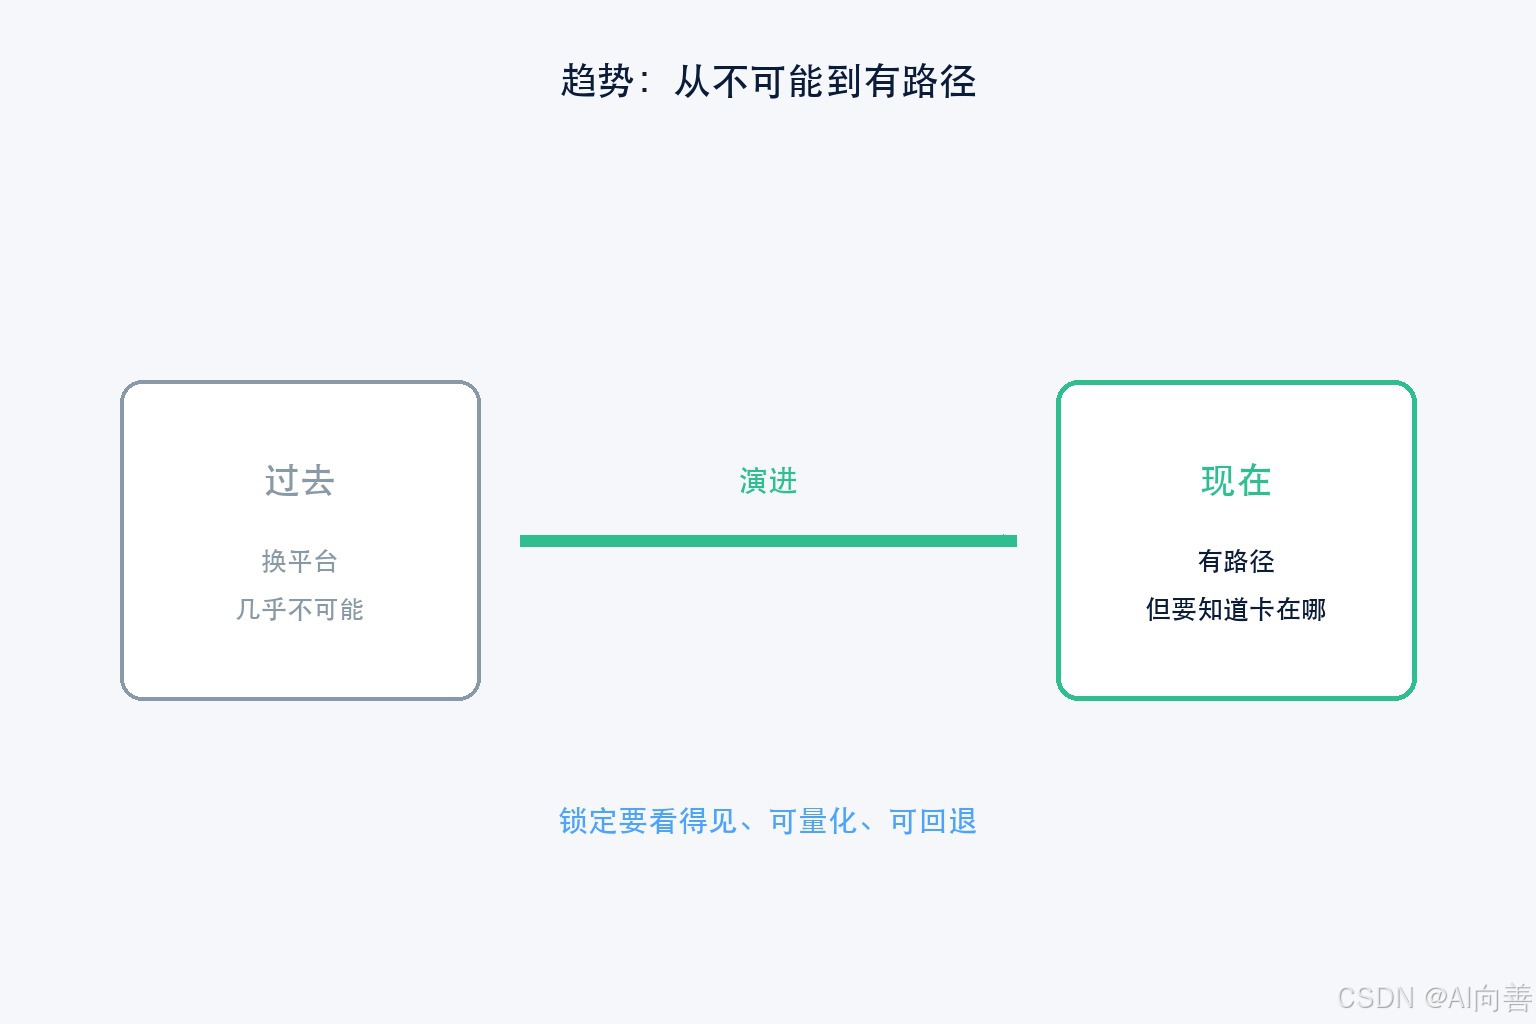
这件事的真正意义是:「换平台」第一次从一个「几乎不可能」的问题,变成一个「有路径但要知道卡在哪」的问题。
卡在哪?行业里最常见的答案是「算子库」。但实际排查下来,你会发现回帖里说的算子库只是最表层的一环,真正拖工期的是依赖链上的传递锁定。
一、三类锁定,先分类再动手
平台适配问题之所以难排,是因为三种完全不同的情况,在清单里长得几乎一样:
| 类型 | 表现 | 后果 |
|---|---|---|
| 直接不支持 | 组件只声明支持 CUDA,没有昇腾后端 | 必须替换或自行移植,工作量明确 |
| 传递锁定 | 顶层框架声明支持昇腾,但依赖一个只支持 CUDA 的组件 | 最坑:看清单以为能跑,编译时才炸 |
| 声明缺失 | 组件根本没写支持哪些平台 | 风险未知,不等于安全 |
第三类是排查里最容易被放过的一类。 「没声明」和「跨平台」在清单里长得一样,但后果相反:前者是不知道风险,后者是风险已排除。把它当 PASS,审计会报出「零锁定」,而真实情况往往是清单根本没填。
另外还有一类信息项:版本锁定,它不算错误,但会影响迁移排期。
二、完整可复制:锁定审计脚本
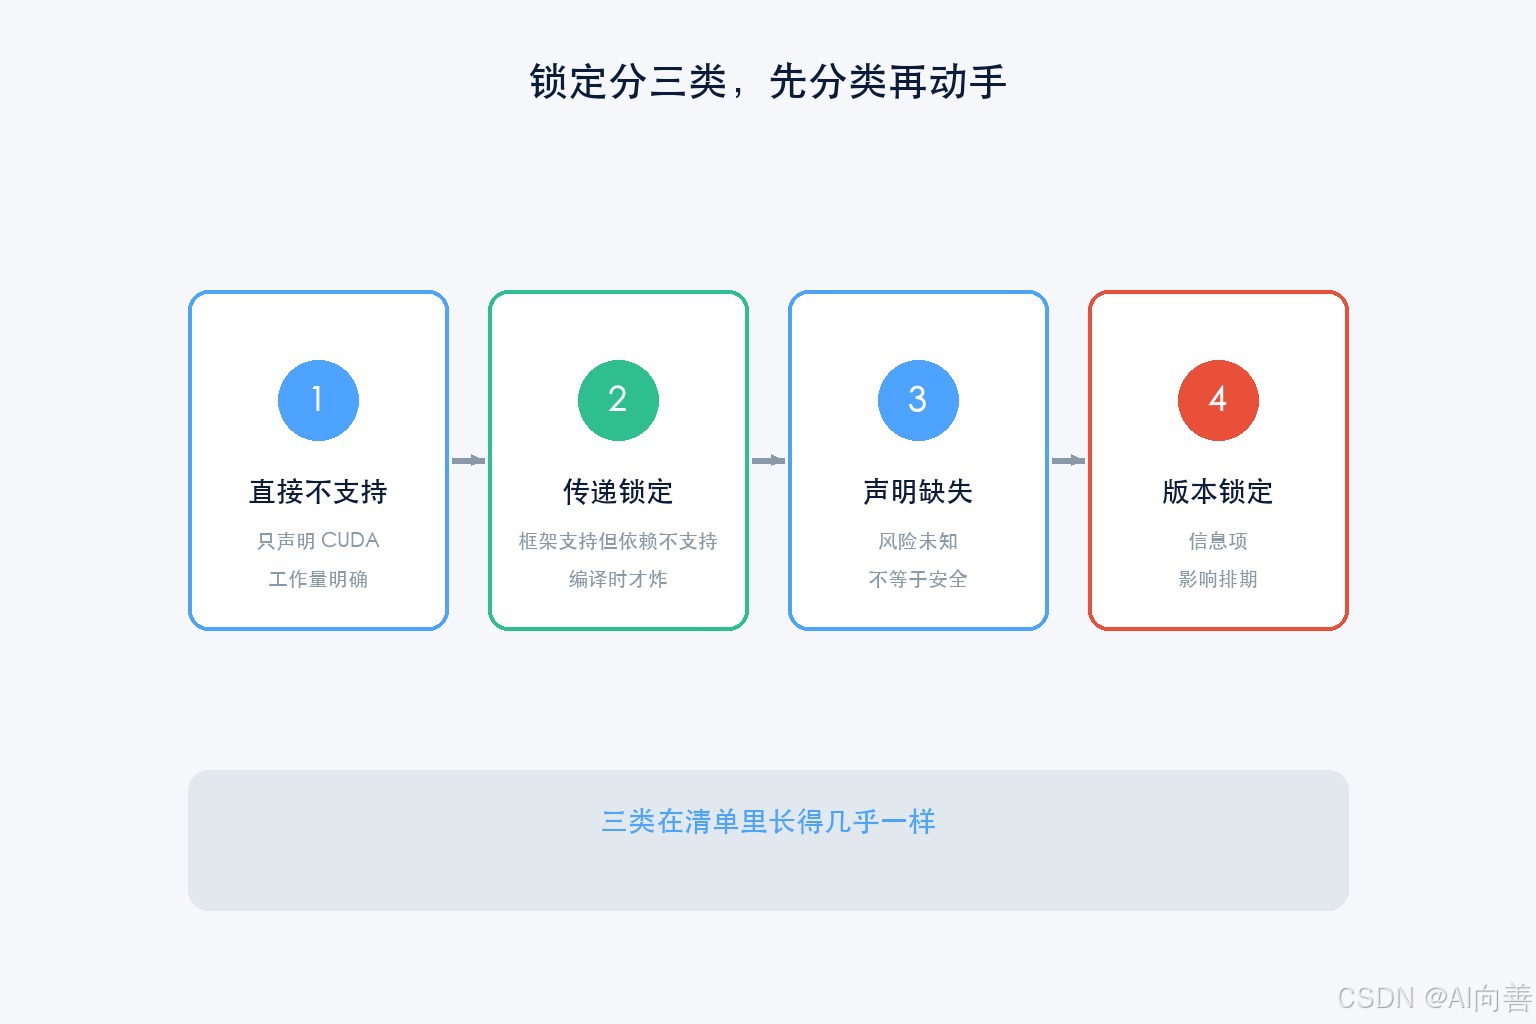
脚本的核心逻辑是「解析声明 → 展开依赖 → 三态判定」,UNKNOWN 单独成一个状态,不并入 PASS。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""算力平台锁定审计:判断一套 AI 技术栈换平台要付多少改动量。"""
from __future__ import annotations
import argparse, json, sys

PASS, FAIL, UNKNOWN = "PASS", "FAIL", "UNKNOWN"

def platforms_of(c):
    """返回组件声明的平台集合;未声明返回 None(注意:None 不等于空集)。"""
    p = c.get("declared_platforms")
    return {str(x).lower() for x in p} if p else None

def audit(manifest):
    target = str(manifest.get("target", "")).lower()
    comps = manifest.get("components") or []
    idx = {c["name"]: c for c in comps}
    findings = []

    for c in comps:
        name = c.get("name", "(未命名)")
        plats = platforms_of(c)

        # I1 未声明平台 ⇒ UNKNOWN(不是 PASS)
        if plats is None:
            findings.append({"level": UNKNOWN, "component": name, "code": "I1",
                             "detail": "未声明 supported platforms,风险未知"})
            continue

        # I2 目标平台不在声明里 ⇒ 直接锁定
        if target and target not in plats:
            findings.append({"level": FAIL, "component": name, "code": "I2",
                             "detail": f"未声明支持 {target}(当前仅 {'/'.join(sorted(plats))})"})

        # I3/I4 传递锁定:自己支持,但依赖的组件不支持
        if target and target in plats:
            for dep in c.get("depends_on") or []:
                d = idx.get(dep)
                if d is None:
                    findings.append({"level": UNKNOWN, "component": name, "code": "I3",
                                     "detail": f"依赖 {dep} 不在清单内 ⇒ 该条依赖无法判定"})
                    continue
                dp = platforms_of(d)
                if dp is None:
                    findings.append({"level": UNKNOWN, "component": name, "code": "I3",
                                     "detail": f"依赖 {dep} 未声明平台 ⇒ 传递判定未知"})
                elif target not in dp:
                    findings.append({"level": FAIL, "component": name, "code": "I4",
                                     "detail": f"声明支持 {target},但依赖的 {dep} 仅支持 "
                                               f"{'/'.join(sorted(dp))} ⇒ 传递锁定"})

        if c.get("version_locked"):
            findings.append({"level": PASS, "component": name, "code": "I5",
                             "detail": "已显式锁定版本,升级需人工确认"})

    summary = {
        "target": target, "components": len(comps),
        "fail": sum(1 for f in findings if f["level"] == FAIL),
        "unknown": sum(1 for f in findings if f["level"] == UNKNOWN),
    }
    summary["verdict"] = "BLOCKED" if summary["fail"] else ("INCOMPLETE" if summary["unknown"] else "CLEAN")
    return findings, summary

if __name__ == "__main__":
    m = json.load(open(sys.argv[1], encoding="utf-8"))
    f, s = audit(m)
    print(s)
    for x in f:
        print(x["level"], x["code"], x["component"], x["detail"])
清单文件(stack.json):
{
  "target": "ascend",
  "components": [
    {"name": "vLLM", "declared_platforms": ["cuda", "rocm", "ascend"],
     "depends_on": ["torch", "flash-attn"]},
    {"name": "torch", "declared_platforms": ["cuda", "rocm", "ascend", "cpu"], "depends_on": []},
    {"name": "flash-attn", "declared_platforms": ["cuda"], "depends_on": []},
    {"name": "xformers", "declared_platforms": ["cuda"], "depends_on": []},
    {"name": "custom-kv-router", "depends_on": ["torch"]},
    {"name": "sglang", "declared_platforms": ["cuda", "rocm"], "depends_on": [], "version_locked": true}
  ]
}
跑法:
python accel_lock_audit.py --manifest stack.json
python accel_lock_audit.py --demo
python accel_lock_audit.py --selftest   # 11 项自检:4 正控 + 5 负控 + 2 守恒
我在本机跑了一遍示例清单,真实输出如下(非示意):
目标平台:ascend   组件数:6
结论:BLOCKED   FAIL=4  UNKNOWN=1

⛔ [FAIL   ] I4  vLLM               声明支持 ascend,但依赖的 flash-attn 仅支持 cuda ⇒ 传递锁定
⛔ [FAIL   ] I2  flash-attn         未声明支持 ascend(当前仅 cuda)
⛔ [FAIL   ] I2  xformers           未声明支持 ascend(当前仅 cuda)
❓ [UNKNOWN] I1  custom-kv-router   未声明 supported platforms,风险未知
⛔ [FAIL   ] I2  sglang             未声明支持 ascend(当前仅 cuda/rocm)
· [PASS   ] I5  sglang             已显式锁定版本,升级需人工确认
这份输出里最值钱的是第一行。 vLLM 的声明栏里写着支持 ascend,但它的依赖 flash-attn 只支持 cuda。这就是典型的「清单看起来能跑,编译时才炸」。
三、工程取舍:为什么必须查整条依赖链
取舍一:只查直接依赖,不做递归展开。 脚本目前只展开一层。原因是一层足以覆盖 80% 的实际卡点,而递归展开在依赖图有环时会打转。代价是会漏掉「依赖的依赖」,如果你的技术栈层数很深,需要把清单拆成多份分层跑。
取舍二:不自动读包管理器的元数据。 直接用 pip show 或 npm ls 抽平台声明看似省事,但上游包的元数据里基本没有「支持哪些加速卡」这个字段。硬抽会得到一列空值,然后被 I1 全判成 UNKNOWN,那等于没审计。所以要求人工维护一个清单文件,把判断显式写下来。
取舍三:UNKNOWN 阻断而不是放行。 这一条最反直觉,也最重要。verdict 的三态是 BLOCKED / INCOMPLETE / CLEAN,只要有 UNKNOWN 就是 INCOMPLETE。因为把 UNKNOWN 当 PASS,等于用一个「报 0 的计数器」做决策。
自检里的负控专门锁这条:
负控(该安静 / 该报未知的场景)
  ✅ N1 全支持的清单必须 CLEAN(不许误报)
  ✅ N2 干净清单不得产出任何 FAIL 条目
  ✅ N3 未声明平台 ⇒ UNKNOWN(不得当 PASS)
  ✅ N4 未声明平台不得产出 PASS 条目
  ✅ N5 依赖不在清单内 ⇒ UNKNOWN(不静默通过)
四、三个踩过的坑
坑一:把「没声明」当「跨平台」。 这是最高频的一个。比如你公司内部自研的 KV 路由模块,README 里没提平台,清单里就会被当成中立组件放行,而它往往直接调了 CUDA 的算子。
坑二:只看顶层框架的官网说明。 比如某个推理框架官网写着「支持昇腾」,但真正跑起来要开特定的 attention 后端,而那个后端又指向一个 CUDA-only 的库。官网的「支持」是关于框架的,不是你那条依赖链的。
坑三:忽略版本锁定。 组件锁版本本身不是错误,但它会让「换平台」和「升级版本」这两件事必须同时做。排期时常被漏掉,最后工期就是这么丢的。
五、辩证:这份清单不能当迁移预算
不过,把这份清单直接读成迁移工期,是会出事的。
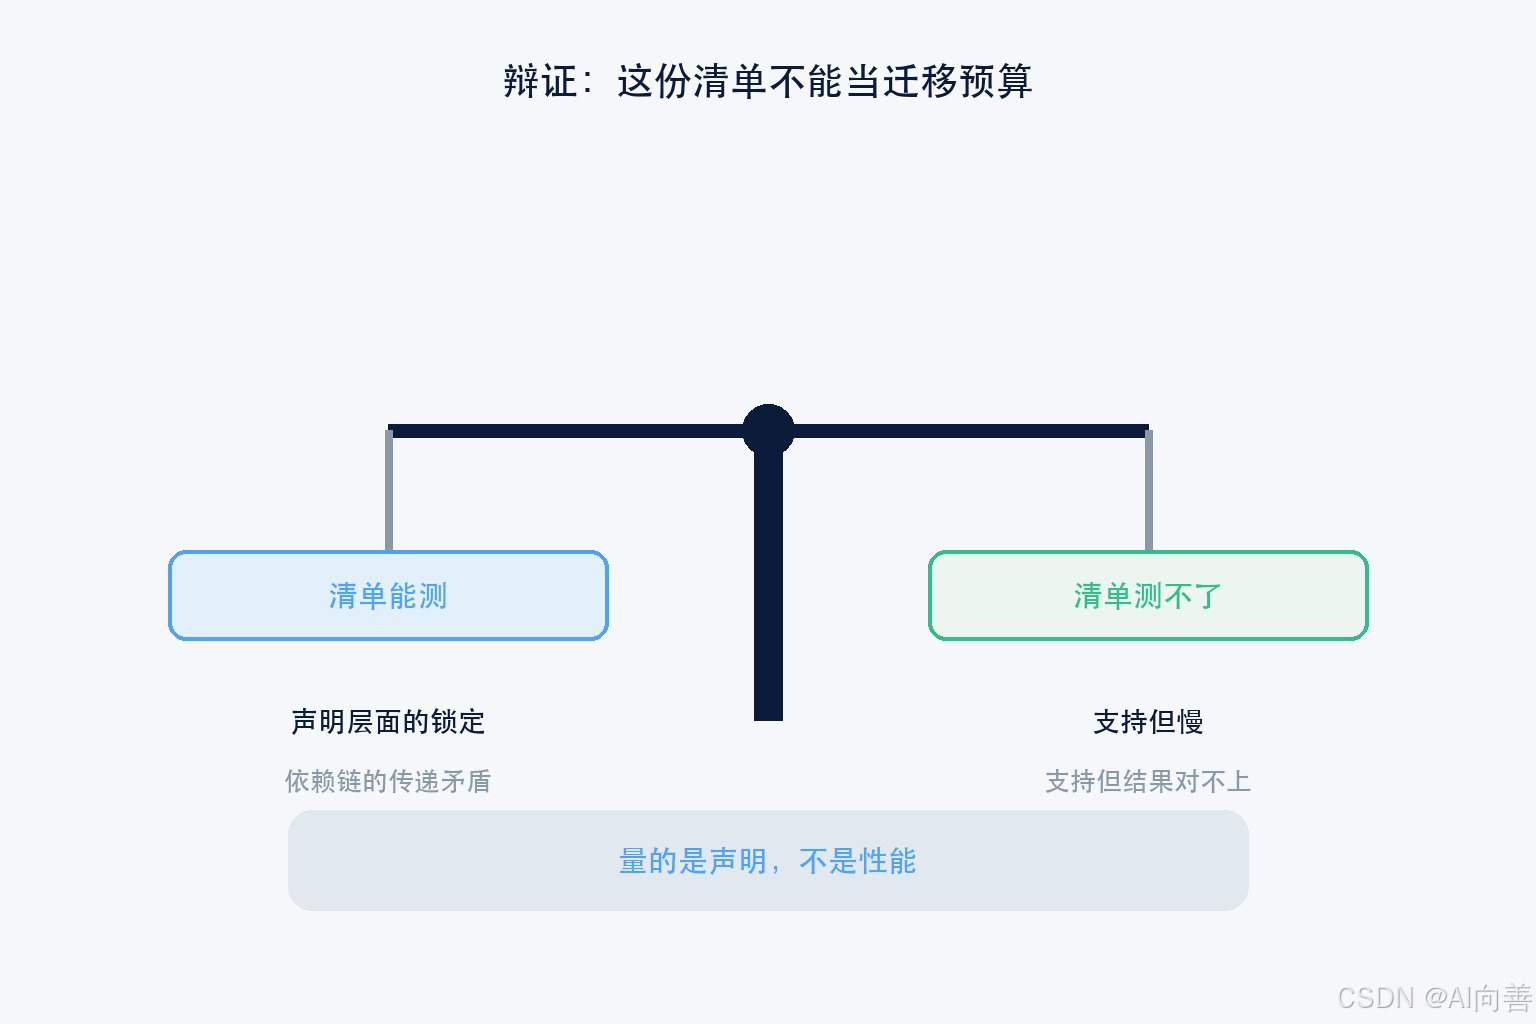
第一个边界:它量的是「声明」,不是「实测」。 一个组件声明支持昇腾,不代表它的昇腾后端性能已经可用。真实迁移里,最花时间的往往不是「不支持」,而是「支持但慢」和「支持但结果对不上」。
第二个边界:结论强依赖清单的质量。 清单是谁维护的、多久更新一次,直接决定审计结果的可信度。清单三个月没更新,审计出来的 CLEAN 只是一个过期的 CLEAN。
另一个角度也得摆出来:换平台从来不只是技术问题。DeepSeek 能把两套基础设施一起开源,前提是它有足够的工程人力承担双份维护成本。对中小团队,这条路径的现实形态往往不是「换平台」,而是「关键环节留一条后路」,比如推理网关同时接两种后端,哪边便宜用哪边。
需要警惕的是把锁定看成纯坏事。 锁定同时意味着优化深度。CUDA 生态性能好的原因之一就是它绑得紧。真正的工程目标是让锁定看得见、可量化、可回退,而不是消灭锁定。
写在最后
三句话收尾:
- 顶层框架说「支持」,不等于你的依赖链支持。 查传递锁定,别只看第一层。
- 「没声明」必须单独成一个状态,不能和「跨平台」混为一谈。
- 清单量的是声明,不是性能。 迁移预算要在真机跑过之后才算数。
三个问题,欢迎在评论区聊聊:
- 你们做过依赖链级的平台锁定排查吗,还是只看顶层框架?
- 「支持但慢」和「不支持」,你觉得哪个在迁移里更贵?
- 自研组件要不要强制写平台声明,你们团队有约定吗?
我的完整脚本已放在本工作区当日产物目录,--selftest 可复现全部 11 项自检。
数据与事件来源
- 乌兰察布数据中心规划部署至少 16 万颗华为昇腾 950DT、面向昇腾平台的开源基础设施组件(编译工具 / 计算库 / 分布式通信库)与英伟达平台组件一一对应:公开报道,多家中文科技媒体交叉核实。
- 「CUDA 与昇腾的算子覆盖差异」属工程共识性判断,本文以自查脚本的三态判定替代厂商口径转述,未引用未经验证的性能数字。
- 三类锁定(直接不支持 / 传递锁定 / 声明缺失)与版本锁定信息项的判定逻辑、以及 11 项自检(4 正控 / 5 负控 / 2 守恒):本工作区当日随文脚本
accel_lock_audit.py,python accel_lock_audit.py --selftest可复现。 - 示例清单
stack.json中的组件与平台声明为演示数据,用于展示判定逻辑,不代表任何特定项目的真实选型结论。
鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)