DeepSeek开源昇腾基础组件:国产算力的软件栈补得怎么样了
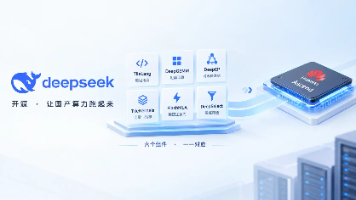
9月30日,DeepSeek 宣布开源一整套面向华为昇腾算力平台的基础设施组件,包括 TileLang 高级语言编译工具、高性能计算库和分布式通信库。据 DeepSeek 官方消息,这些组件与其此前在英伟达平台上开源的组件一一对应。换句话说,DeepSeek 把自己在大模型训练里已经验证过的那套底层工具,成体系地往昇腾上搬了一遍。
这事如果只当成一条"某厂又开源了"的新闻看,会漏掉重点。真正值得琢磨的是:国产芯片缺的到底是什么。
这次到底开源了什么
按官方披露和媒体报道,本次发布的组件大致分工如下:
- TileLang:高级语言编译工具,对昇腾 Ascend C 底层指令做封装,提供更高层的编程方式,宣称不损失硬件性能;
-
- DeepGEMM:通用矩阵运算(GEMM)加速库;
-
- DeepEP:面向 MoE 等场景的大规模跨设备通信库;
-
- TileKernels:常规向量计算和访存算子;
-
- FlashMLA:稀疏注意力算子,用于提升长上下文处理效率;
-
- DeepSelect:数据筛选相关组件。
其中 TileLang 是核心。它的定位是"用更简单的语言写出高性能 AI 算子"。在没有这类工具之前,想把芯片性能榨干,开发者往往要直接写 CUDA 或 Ascend C 这种很底层的东西——复杂,而且换一套芯片就得重写一遍。DeepSeek 表示,其训练中用到的每一个 TileLang 算子,目前在昇腾上都有对应的高性能实现。据华为计算方面披露,双方还联合推进了基于昇腾 950 的 128 卡超节点方案,通信实测形成 Dispatch 375 GB/s、Combine 347 GB/s 的水平。
- DeepSelect:数据筛选相关组件。
变的是什么,没变的是什么
没变的:芯片性能最终能不能发挥出来,仍然取决于算子怎么拆、数据怎么搬、计算和访存怎么衔接。硬件理论算力只是起点,中间这一段"翻译"工作,以前是各家各户自己啃,重复劳动很多。
变了的:以前是"硬件先出来,好用的软件栈、算子库、通信库得慢慢磨很久"。现在 DeepSeek 直接把一套已经在大规模训练里跑过的组件开源出来,模型团队可以复用现成的基础能力,把精力放回自己的模型结构和业务上。某个环节卡住了,还能直接进去看实现、改实现。
这也是国产算力生态一直被诟病的地方——硬件参数写得再漂亮,开发者上手发现工具链不齐、文档跟不上、社区问不到人,落地就慢。这次的信号价值大于某几个库本身:它证明这条路是可以跑通的。
对普通开发者意味着什么
先说结论,避免过度兴奋:如果你只是做上层应用开发,这次开源对你的直接影响接近于零。 你不会突然要写昇腾算子,也不会因为多了几个库就让自己的业务代码变快。
真正直接受益的是这几类人:
- 做大模型训练/推理基础设施、算子优化的团队——可以直接复用,少从零造轮子;
-
- 在做国产化替代、需要把训练/推理迁到昇腾上的团队——迁移的"地基"更实了;
-
- 研究编译器、DSL、异构计算方向的人——TileLang 这类"高层语言 + 不损失性能"的思路本身就是个值得读的样本。
对更广的从业者,更实际的意义是间接的:国产卡上的训练/推理会更容易降本,可选算力多了一条路,长期看对推理价格和供给是好事。
- 研究编译器、DSL、异构计算方向的人——TileLang 这类"高层语言 + 不损失性能"的思路本身就是个值得读的样本。
如果你手上正好有昇腾环境,想确认自己的机器状态,最基础的命令还是那几个:
# 查看昇腾 NPU 设备信息(安装好 CANN 工具包后可用)
npu-smi info
有哪些坑要提前知道
- 别把"开源"等同于"开箱即用"。迁移和调优仍然要动手。官方说"性能接近硬件上限"“部分测试达到理论上限”,那是针对特定测试用例,不是你的业务场景。
-
- 生态成熟度差距还在。CUDA 积累十几年,社区、教程、踩坑帖的量级不是一年两年能追平的。遇到问题能不能搜到答案,是很现实的成本。
-
- 版本绑定要留意。算子库、通信库、编译工具和 CANN 版本之间通常有配套关系,升级前先看清楚兼容矩阵,别踩到版本地狱。
-
- 对"一一对应"保持理性。对应的意思是能力上有对位组件,不代表两边行为完全一致,接口细节和性能表现都要自己验证。
国产算力走到今天,硬件话题已经聊得够多了,真正决定可用性的其实是这层不那么起眼的软件栈。这次开源把一块拼图补上了,但后面还有多少块,得看后续谁愿意持续投入。
- 对"一一对应"保持理性。对应的意思是能力上有对位组件,不代表两边行为完全一致,接口细节和性能表现都要自己验证。
你怎么看国产 AI 芯片的软件生态,评论区聊聊。
鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 1
 0
- 0


 已为社区贡献9条内容

所有评论(0)