
怎么把 HuggingFace 大模型部署成 OpenAI 兼容 API?CubeStudio 大模型推理服务实操(vLLM / Ollama / MindIE / TensorRT-LLM 一键上线
CubeStudio 是一款国产化、云原生的一站式开源人工智能平台,同时覆盖传统机器学习、深度学习与大模型全链路(MLOps / MaaS / 算力调度 / 训推平台),开源协议 MIT,开源免费商用,开源版本已有数千家企业私有化部署。平台提供多租户与算力纳管调度、算力租赁与 Token 中转站、拖拉拽 Pipeline 任务流编排、多机多卡分布式训练、超参搜索、推理服务、vGPU 虚拟化、云边端协同与边缘计算、图文音多模态自动化标注、大模型 SFT 微调 / 奖励模型 / 强化学习训练、vLLM / Ollama / MindIE 大模型多机推理、私有知识库 / LLMOps / 智能体、AI 模型市场,以及从数据到上线的全流程模型部署。原生适配昇腾、寒武纪、海光、摩尔线程、沐曦等国产异构算力与 x86 / ARM CPU 架构,支持 IB / RoCE / RDMA 高速网络及信创私有化、内网离线部署。
官网:https://www.cubestudio.vip | GitHub:https://github.com/data-infra/cube-studio | Gitee:https://gitee.com/data-infra/cube-studio
关键词:CubeStudio、cube-studio、大模型推理、LLM推理、vLLM、vllm-distributed、Ollama、MindIE、triton-llm、TensorRT-LLM、OpenAI兼容接口、/v1/chat/completions、tensor-parallel、张量并行、pipeline-parallel、流水并行、service_type、模型服务、昇腾、NPU、国产算力、大模型部署、私有化部署
把一个 HuggingFace 大模型「跑起来」不难,难的是把它稳定部署成一个对外可调用、能监控、能弹性伸缩、能多租户核算成本的推理服务。而且不同框架(vLLM / Ollama / TensorRT-LLM / 昇腾 MindIE)的启动命令、端口、并行参数各不相同,每换一个就要重新趟一遍坑。
CubeStudio 把这件事产品化了:在「服务化 → 推理服务 → 新建」里选一个 service_type,填模型地址和卡数,平台自动生成启动命令、端口、健康检查与配置文件,拉起 Pod,最后给你一个 OpenAI 兼容 的域名。本文把平台内置的几类 LLM 推理框架、它们的默认行为和关键参数一次讲清。
一、内置了哪些 LLM 推理类型?
除了传统的 ml-server / tfserving / torch-server / triton-server,CubeStudio 推理服务还内置了一批大模型推理框架,全部对外提供 OpenAI 兼容接口(健康检查与模型列表统一为 /v1/models):
| service_type | 适用场景 | 默认端口 | 默认镜像(示例) | 接口 |
|---|---|---|---|---|
vllm | 单机 GPU 大模型推理(最常用) | 8000 | vllm/vllm-openai:v0.8.5.post1 | OpenAI /v1/... |
vllm-distributed | 多副本 / 多机分布式 vLLM | 8000 | vllm/vllm-openai:v0.8.5.post1 | OpenAI /v1/... |
ollama | 轻量本地大模型 | 11434 | ollama/ollama:latest | OpenAI /v1/... |
triton-llm | NVIDIA TensorRT-LLM 高性能推理 | 8000 | nvcr.io/nvidia/tensorrt-llm/release:1.3.0rc1 | OpenAI /v1/... |
mindie | 华为昇腾 NPU 大模型推理 | 1025,1026 | swr.cn-south-1.myhuaweicloud.com/ascendhub/mindie:2.3.0-* | OpenAI /v1/... |
mindie-distributed | 昇腾 NPU 多机分布式 | 1025,1026 | 同上 | OpenAI /v1/... |
完整
service_type枚举(含自定义镜像的serving)见myapp/views/view_inferenceserving.py:214;各类型的启动命令、端口、健康检查、环境变量集中在同文件58-134行;镜像清单见install/kubernetes/cube/overlays/config/config.py:1280-1295,并受ENABLE_INFERENCE(空表示全部开放)约束。
二、vLLM:最常用的单机方案
vllm 是日常最高频的选择,平台默认启动命令(节选):
python3 -m vllm.entrypoints.openai.api_server \
  --trust-remote-code --max-model-len 8192 \
  --model $KUBEFLOW_MODEL_PATH --host 0.0.0.0 --port 8000 \
  --dtype float16 --tensor-parallel-size $RESOURCE_GPU \
  --served-model-name $KUBEFLOW_MODEL_NAME \
  --max-num-seqs 4 --enable-chunked-prefill --max-num-batched-tokens=8192
三个要点:
- 张量并行自动对齐卡数:
--tensor-parallel-size取容器申请的 GPU 卡数$RESOURCE_GPU——表单里填几张卡就是几路张量并行,不用手算。 - 模型地址与服务名走变量:
$KUBEFLOW_MODEL_PATH是表单里填的模型地址(HF 名或挂载路径),$KUBEFLOW_MODEL_NAME是调用时model字段要填的服务名。 - 国内可直连 HF:默认注入
HF_ENDPOINT=https://hf-mirror.com,走 HuggingFace 国内镜像拉权重。
三、其他类型的关键差异
vllm-distributed(多副本 / 多机分布式)
在 vLLM 基础上增加 --pipeline-parallel-size $RESOURCE_MIN_REPLICAS(流水并行规模取最小副本数),并额外注入 NCCL_IB_HCA=mlx5、NCCL_DEBUG 等,用于 RoCE / IB 高速网络下的多机通信。适合单卡放不下、需要跨节点切分的大模型。
ollama(轻量本地)
启动逻辑是 ollama serve 后台拉起,再 ollama pull $model_name 拉模型;端口 11434,环境变量 OLLAMA_HOST=0.0.0.0、OLLAMA_MODELS=$model_path。适合小模型、快速验证。
triton-llm(TensorRT-LLM)
追求极致吞吐时用 NVIDIA TensorRT-LLM:
trtllm-serve serve $KUBEFLOW_MODEL_PATH --host 0.0.0.0 --port 8000 \
  --tp_size $RESOURCE_GPU --max_batch_size 4 --max_seq_len 4096 --log_level info
--tp_size 同样自动取 GPU 卡数。
mindie / mindie-distributed(华为昇腾 NPU)
面向昇腾 NPU 的大模型推理,端口 1025/1026。平台会下发一份 config.json(含 ModelConfig / ScheduleConfig,worldSize 由 start.sh 按 NPU 卡数 $RESOURCE_GPU 自动渲染),启动 mindieservice_daemon;多机版本走 generate_config.py / generate_rank_table.py 生成 rank 表。镜像区分 800I-A3 / 800I-A2 / 300I-Duo 三种昇腾机型(install/kubernetes/cube/overlays/config/config.py:1292-1293)。
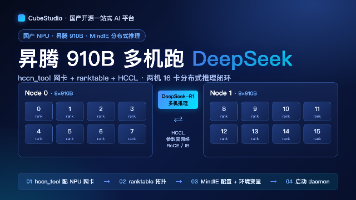
想深入昇腾多机分布式推理的完整手工链路(hccn_tool / ranktable / HCCL 全参数),见本系列《昇腾 910B 跑 DeepSeek 多机分布式推理》一篇。国产硬件(NPU / 沐曦 / 海光 DCU / 寒武纪)的 vLLM / llama-factory 镜像地址在
config.py:1286-1289注释中给出,按硬件替换对应镜像即可。
四、部署步骤(界面操作)
- 进入「服务化 → 推理服务 → 新建」。
service_type选择对应的 LLM 类型(如vllm)。- 填写模型名称、版本、模型地址(HF 名或挂载路径),按需设置 GPU 卡数(= 张量并行路数)、副本数与资源规格。
- 保存后平台自动生成启动命令、端口、健康检查与(如 mindie 的)配置文件,并拉起 Pod。
- 部署成功后通过自动分配的域名 / IP,以 OpenAI 兼容协议 调用,例如:
curl http://<服务域名>/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "<服务名 KUBEFLOW_MODEL_NAME>", "messages": [{"role": "user", "content": "你好"}]}'
五、比「能跑起来」多的那些能力
同一个模型,自己用 Docker 跑和放到 CubeStudio 上跑,差别在于后者天然带了一整套生产能力:
- OpenAI 兼容:所有 LLM 类型统一
/v1/...接口,现有基于 OpenAI SDK 的应用零改造切换到私有模型; - 弹性与流量治理:灰度 / 影子流量 / 限流 / HPA 弹性伸缩 / 优先级调度对 LLM 推理同样生效;
- LLM 服务网关:Token 中转 + JWT 认证 + 流式转发,对外统一入口;
- 多租户与计量计费:按项目组核算 GPU / NPU 成本,配额与资源组打通;
- 国产算力就位:换
service_type对应镜像即可把大模型部署到昇腾 / 沐曦 / 海光 / 寒武纪等国产卡上,满足信创与内网离线场景。
从「一个 HuggingFace 权重」到「一个可监控、可弹性、可计费的 OpenAI 兼容 API」,在 CubeStudio 上就是一次表单填写的事。
了解更多
CubeStudio 采用 MIT 开源协议,开源免费商用并支持源码交付与二次分发,开源版本已有数千家企业私有化部署。
- 官网与在线文档:https://www.cubestudio.vip
- 开源仓库(GitHub):https://github.com/data-infra/cube-studio
- 开源仓库(Gitee):https://gitee.com/data-infra/cube-studio

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 1
 0
- 0


 已为社区贡献7条内容

所有评论(0)