
2026,超节点集体“狂飙”, 昇腾交了一份新答卷
文 | 智能相对论
作者 | 陈泊丞
今天,Agentic AI把算力的需求彻底改了。
过去大模型时代的算力消耗以训练为中心,一次训练是一次性的高峰,跑完即止。智能体时代,模型上线只是开始,多轮对话、工具调用、AI编程,推理业务全年无休地在线,而且要得更急,时延大多以毫秒计。
相比之下,训练是一次性的高峰,推理和智能体是常年在线。评判算力的单位也就从“一张卡”变成了“一个Token”,整个行业比的不再是峰值,而是单位成本。那么,顺着这条线往下推,我们也会得到一个看似技术、其实很常识的结论:算力贵不贵,跟一张卡跑得多快关系不大,跟“这些卡里有多少算力真的被用上了”关系很大。
而“让卡里的算力真正被用上”,恰恰是传统集群逐渐暴露的短板。上千张卡堆进一个机房,卡与卡之间隔着通信时延,显存被切成一座座孤岛,调度各归各家——它们始终是“一千张卡”,而不是“一台机器”,空转和等待,就是账本上最贵的部分。
要把这部分成本挤出去,单卡提速已经不够用了,得把卡与卡之间的墙拆掉。这正是今年超节点走红的根本原因——算力的最小使用单位,在行业需求的调整中正在从“一张卡”变成“一台计算机”。
但客观而言,这台“计算机”能否真正成立,需要两件事同时发生:造它的人,得让千张卡工作逻辑上像“一台计算器”一样工作;用它的人,得愿意在这台机器上写代码。具体应该如何去推动?前不久的华为全联接大会上,昇腾摆出了两个动作,值得拆解。
一是昇腾950超节点正式上市,二是在去年就已全面开源开放的CANN与Mind系列软件基础上,昇腾这一年深耕开发者体验,推动软件从“好用”迈向“易用”。两个动作,正好一一对应上面的两个条件——硬件上市,回答的是“这台机器造不造得出来、交不交得出”;软件与生态的演进,回答的是“开发者愿不愿意站上来写代码”。市场的问题能不能被真正解开,或许能在这里找到一个更具体的答案。
超节点“狂飙”,是需求倒逼的
超节点这个词今年被说得很热,2026年也是超节点集体上市的一年。牌桌上不止一家,路线也在分岔——自研互联、光电融合、开放混插,各有拥趸。有意思的是,吵归吵,今年产业界反而罕见地形成了“什么才算超节点”的共识:多个计算节点通过高速互联协议紧密连接,具备跨物理节点统一内存编址能力,在逻辑上具备“一台计算机”特征的计算系统。
为什么今年超节点“狂飙”了?它不是被概念催出来的,是被算力需求的变化逼出来的。
华为昇腾计算产品线总裁张迪煊在峰会上给出过一个判断:大模型每一波迭代都带来新的AI负载需求,昇腾要用确定的架构,去应对AI负载变化的不确定性。展开来看就是,模型参数从1T走向10T,集群规模从万卡走向十万卡,MoE成为主流架构,上下文越拉越长,推理规模化落地——客户真正关心的,一是有效算力能不能随规模线性增长,二是单位TCO下的吞吐够不够高。
具体的,大模型推理分为Prefill(计算密集)和Decode(访存密集)两个阶段,真正的成本大头出自Decode阶段。而它的瓶颈不在峰值算力,而在内存带宽、通信时延和显存容量。对应来看,当前市场面临的问题,正好是超节点能解决的,即超大带宽、超低时延、跨物理节点的统一内存编址所带来的系统性优势。
因此,各家路线虽然不同,但拆解到最后,其本质都要回答同一组问题:卡与卡之间的墙,拆得够不够彻底?真正跑起来,Token的成本到底降没降?具体评估一家厂商的成色,参数表恰恰是最不重要的部分。
以这次华为全联接大会——昇腾AI人工智能产业峰会上正式上市的Atlas 950 SuperPoD为例,它面向大规模数据中心建设、万亿级大模型训练与中心高并发推理场景,也是目前业界最大规模的商用超节点——单个超节点集成了1024颗NPU。
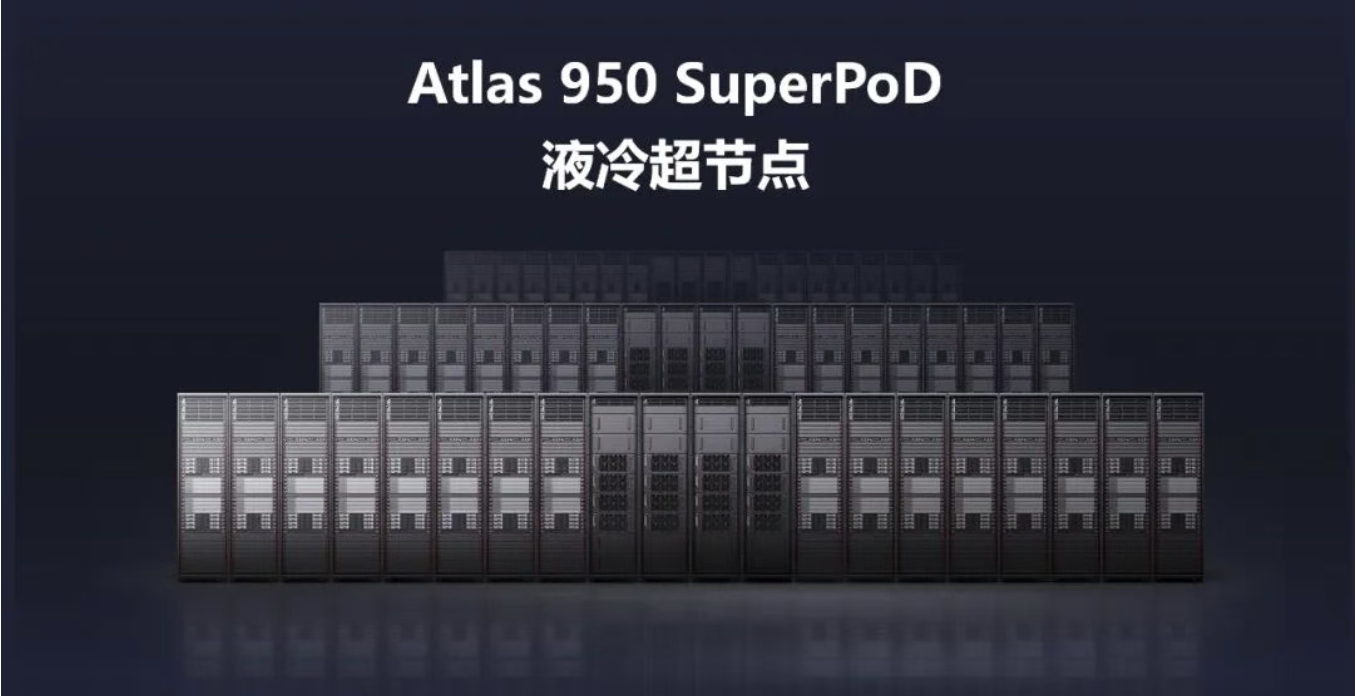
在「智能相对论」的视角中,这一产品真正值得注意的,不是1 EFLOPS FP8的算力数字,而是256TB全局统一内存编址:万亿参数模型连同智能体常驻的KV缓存,得以在“一台机器”内部装下并统一调度,而不必在卡与卡之间来回搬运。同时,TB级互联带宽与小于10毫秒超低时延,则是给MoE模型高频的专家路由,修了一条不堵车的高速路。
这些架构选择落到实际运行上,带来的价值是显而易见的:训练MFU(模型有效算力利用率)提升1.5~1.7倍——注意这个指标,它量化的正是开头那个问题:“这些卡里有多少算力真的被用上了”。其他的,万卡集群实现月级稳定训练,千卡MTBF高达300小时,领先业界25%以上,推理性能相比传统集群提升2~3倍——倍数本身不重要,重要的是它们换算下来,同样在回答最核心的问题:同样的卡,干出了更多的活。
当然,对于用户而言,性能再强还得放在实际的市场应用中,而市场应用的第一个关键门槛,就是交付。
关于这一点,昇腾的落地值得一提。截至目前,昇腾超节点累计部署超1000套,累计超过6.5亿在线卡时。同时,40多个大模型在昇腾上完成了原生预训练,昇腾也是目前国内唯一支持预训练的算力底座。
把镜头拉近到行业,这份交付清单的含金量会更直观。蚂蚁的AI医疗健康应用阿福,基于昇腾构筑“离线持续优化、在线实时纠偏”的双反馈体系,业务数据显示,负反馈率下降20.43%、正反馈率上升11.99%。从汽车电子走向具身智能的德赛西威,基于昇腾超节点构建算力底座,训推性能超过业界GPU平台,其工业机器人任务成功率不低于99%、生产效率平均提升30%。
超节点好不好用,最终还得是这些业务数字在说话。那么,遵循这个思路,我们可以发现,AI算力的变革方向往往更贴近大多数企业的现实。此前超节点基本绑定液冷数据中心,而大量企业级机房是通用风冷——要上超节点,先得过液冷改造这道坎,周期长、成本高,这道门槛卡住的恰恰是规模最大的存量市场。
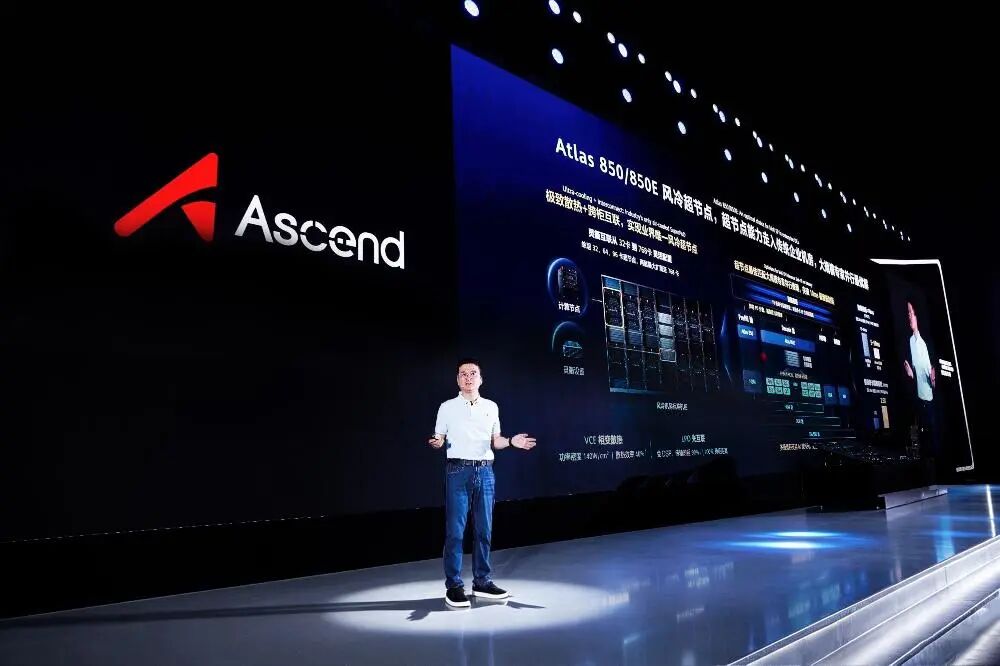
由此,这次同步上市的Atlas 850E风冷超节点,又给我们提供了一个新解法——依托自研相变散热技术,标准机柜直接上架,现有风冷机房无需改造。同时,通过灵衢互联设备,单层组网支持32、64和96超节点,双层组网可扩展至768超节点。叠加大规模专家并行优化,在万亿MoE模型上实现5-10ms的极致低时延,单卡吞吐比业界风冷集群提升2.5倍。原生覆盖FP8、mxFP4等低精度格式,支持M级长上下文。
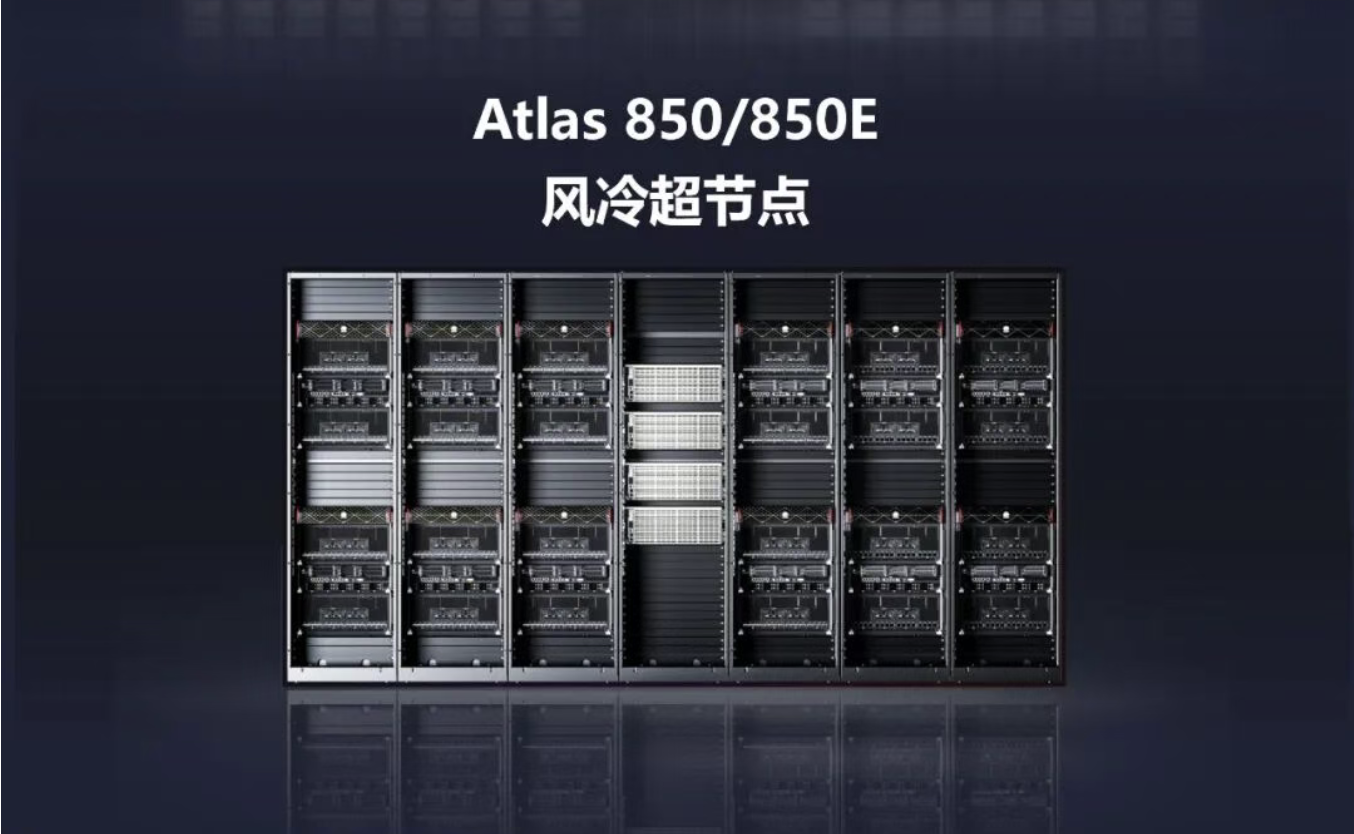
这也就意味着,超节点不再是某类数据中心的专属,而是面向不同场景的形态之选——大规模数据中心建设有液冷超节点,企业通用机房有风冷超节点,客户可以按自身业务需求选用合适的超节点形态。换句话说,互联网、金融、政府、教育这些以风冷机房为主的行业,也正式接入了超节点的选项清单。
说到底,超节点狂飙的真正推手不是概念,而是Agentic AI落进千行百业时,那些实实在在的算力需求所激发的。
“一台计算机”要立得住,硬件之外还得看生态
当然,新架构计算机往往都逃不开同一个历史规律:硬件决定它能跑多快,生态则决定它能不能活下来。硬件越是把算力做成“一台机器”,那么瓶颈就越会从机房转移到开发者的工位上。
而昇腾在软件这一侧的动作,本质上就是这个判断的延续——新架构能不能立住,取决于有多少人愿意在上面写代码。众所周知,CANN和Mind系列软件在去年就已经完成了全面开源开放——驱动、运行时、算子编程、算子库、通信库、工具,悉数开放。站在开发者的视角,这相当于把过去层层封装的“黑盒”变成了“白盒”:开发者不再只是昇腾的使用者,随时可以变成昇腾的改造者。
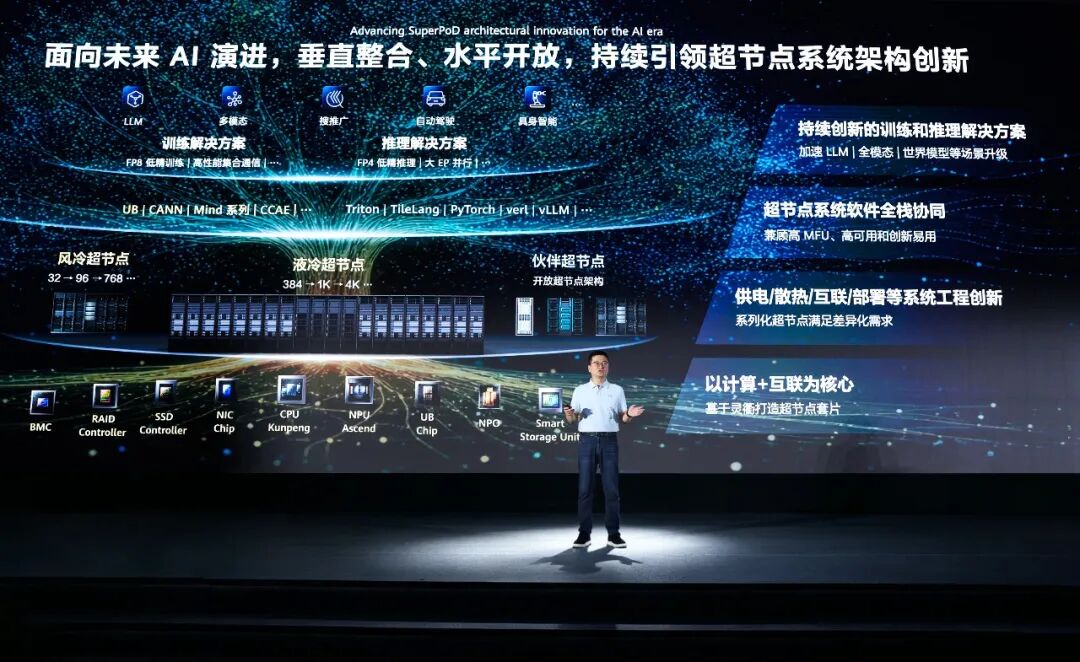
但开源从来不是终点,更像是起点,接下来昇腾如何围绕“好用易用”这条主线,持续往深处走,恰恰是其今年想要回答的问题。
往深处走的第一步,是社区化运作。一年多下来,CANN已有30多个SIG组、70多个开源项目,月活开发者超过5000,是中国最活跃的AI开源社区,目前多个行业和不同高校的开发者都已入驻,在社区提交贡献。从这里来看,这套开源体系就基本进入“活的”状态,进而带来持续进化的可能。
紧接着,再往深处走,身份的变化继续打破开发者的顾虑。今年7月,昇腾NPU正式上线PyTorch官网,是首个官方支持的中国硬件厂,PyTorch社区CI/CD已接入昇腾,已实现L3级流水线(标签触发,上游PR可见昇腾CI结果),100%用例覆盖与可视化实时看护,未来双方携手共建 Agentic AI 超节点原生软件栈;昇思MindSpore以组件化方式开放能力,超节点分布式并行组件 HyperParallel与PyTorch融合表现出卓越的训练性能,深度支持PyTorch生态;Triton Ascend成为Triton官方社区支持的首个国产加速后端——把这些动作凑在一起来看,不难发现,昇腾正在从主流生态的“适配者”变成“原住民”。
回到开发者的视角来看,这两种身份的差别是本质性的。适配意味着“迁就”——代码要改、习惯要换、坑要自己踩,出了问题只能找厂商。而原生意味着“默认”——目前昇腾已兼容Megatron、vLLM、SGLang、PyTorch、Triton等90余个业界主流开源项目,贡献超38.8万代码到主流社区,从适配走向原生共建。MindStudio工具链就与verl社区联合创新RL-Insight,填补了强化学习可视化性能调优的空白。通过与社区不断交流融合,照着社区文档写的代码几乎不用改就能跑,工具链和社区经验可以平移,迁移成本趋近于零。
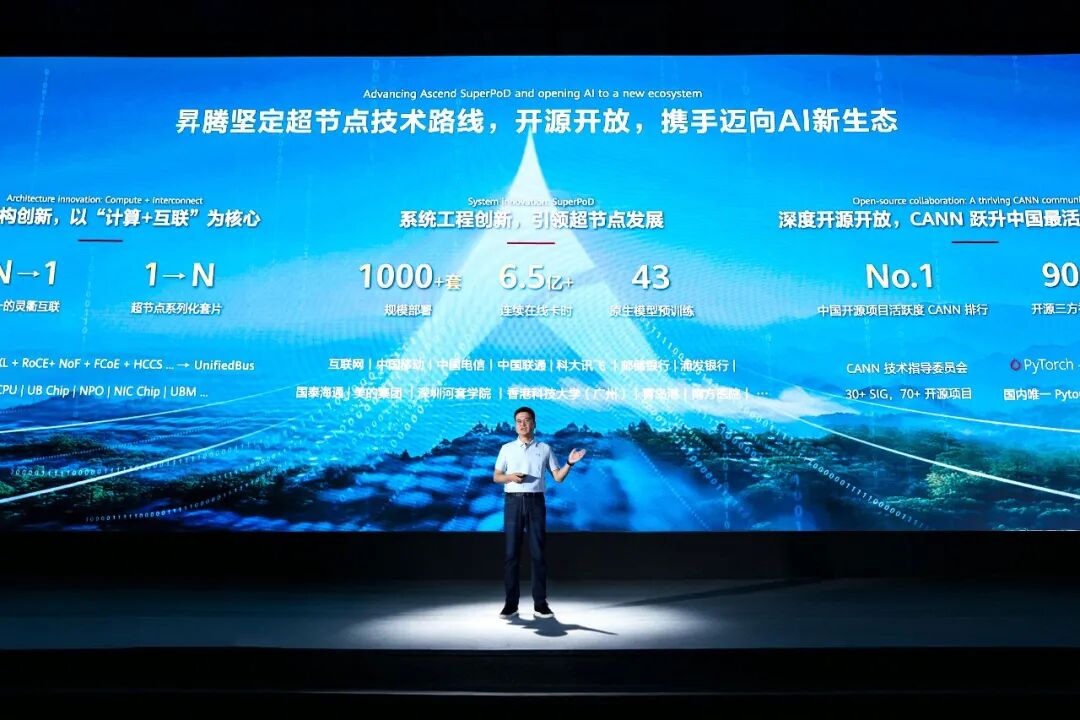
当然,身份是名头,好不好用还得看事实。对于想要转向昇腾生态的开发者而言,改变已经在发生,有三个维度可以验证。
一是生态已经能实现反向贡献——高校共建算子仓、上游社区接收代码成了现实。二是新模型实现了0 Day适配——DeepSeek、Kimi、GLM等85款主流系列模型均在发布当天上线昇腾。三是客户场景里真有算子被产出、被复用——仅CANNBot就已在50余家头部客户场景落地算子50余个。
在此基础上,昇腾还把4000多名专家在开发、调试、调优中的实践经验沉淀为Skills,开源了200多个,构建起覆盖算子生成、精度调试、性能调优、模型部署等10大核心场景的Agentic编程体系:开发者用自然语言下达指令,CANNBot就能自动完成算子的设计、开发与测试,纯Vector/Cube类算子3小时生成、1天内部署;48亿Token的算子数据集正式开源,社区同步上线CANN-Bench评测平台,让算子生成的质量有据可评。
说白了,昇腾在用AI降低AI的开发门槛——算力基础设施的易用性问题,正在交给AI自己来解决。这大概是Agentic AI时代里,最自洽的一种解法。
而门槛每降低一分,愿意走进来的人就会多一批,整个AI算力的复利效应也随之转起来:用的人越多,模型适配越快;模型越丰富,又反过来吸引更多的人——算力在“一台计算机”里高速流转,而不是在机房里闲置。
这也正是开头那“两件事”的意义所在:让上千张卡在逻辑上像一台计算机一样高效工作,解决的是算力的供给;让人愿意在这台计算机上写代码,解决的是算力的兑现。接下来超节点要成为业内主流方案,这两半缺一不可。
结语
总的来说,算力的最小使用单位从“一张卡”变成“一台计算机”,同时改写了两边的命题——硬件要负责拆墙,软件要负责接人。在「智能相对论」看来,这两件事做不成一件,超节点就只是更贵的机柜,开源就只是一份更长的代码仓库。
这也是为什么说,2026年超节点集体狂飙,但真正的“加速档”从来不在超节点这个硬件形态身上,而在软件与生态的咬合处。
再往前看一步,这轮竞赛里,一条清晰的路径是把单点上的差距,用系统能力补回来——靠互联、架构、软件和生态的系统工程去换时间。这条路走不走得通,接下来的三年是关键窗口期,而验证这一路径的关键,恰恰是交付清单和生态开发者的数量。
*本文图片均来源于网络
此内容为【智能相对论】原创,
仅代表个人观点,未经授权,任何人不得以任何方式使用,包括转载、摘编、复制或建立镜像。
部分图片来自网络,且未核实版权归属,不作为商业用途,如有侵犯,请作者与我们联系。
•AI产业新媒体;
•澎湃新闻科技榜单月度top5;
•文章长期“霸占”钛媒体热门文章排行榜TOP10;
•著有《人工智能 十万个为什么》
•【重点关注领域】智能家电(含白电、黑电、智能手机、无人机等AIoT设备)、智能驾驶、AI+、、、AI+、AI+、AR/VR、、开发者以及背后的芯片、算法等。

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)