
【AI 杂谈】芯片没换、卡没加,吞吐却涨了 96%:国产训练栈里藏着的暗牌
96% 的吞吐,是从软件栈里抠出来的
一个 96%,悬在头顶
9 月 17 日,中电信人工智能科技开源了星辰大模型 Xing4.0-29B-A4B。总参数 290 亿,MoE 结构下每个 token 只激活 40 亿,原生 256K 上下文、可扩到 512K,架构是 mHC + MLA + MTP 的组合(来源:Hugging Face 模型卡 XingChen-AGI/Xing4.0-29B-A4B)。这些参数规格其实没什么好说的,29B 在今天开源榜单里排不进前排。真正让我停下来的是另一句:它全程基于昇腾 910C 芯片与 MindSpore 框架训练,且训练吞吐较开箱状态提升约 96%。
96% 这个数字值得盯住。同一批硬件,什么都没换,吞吐却几乎翻了一倍。多出来的这一倍,不是芯片变快了,也不是加了卡。它只可能来自一个地方:软件。
那这一倍,到底是从哪抠出来的?我把这个问题当成全文的线头。
训练比推理,难一个数量级
要先说清楚一件事:在国产芯片上「跑」模型和「训」模型,是两码事。推理单卡就能做,把训练好的权重加载进来,forward 一遍出结果。训练要的是千卡协同——卡与卡之间的互连带宽、all-reduce 这类集合通信、算子库的完备程度、断点续训、混合并行切分,任何一环掉链子,整个训练任务就崩,而且往往是在烧掉几十万美元之后才崩。
这里有个看待性能的视角,叫 Roofline 模型。它用「算术强度」衡量一段计算能跑多接近峰值——每从内存搬一个字节的数据,能换回多少浮点运算。一块芯片的峰值算力是屋顶,内存带宽决定你能往上爬多高,而训练时真正吃到的吞吐落在哪儿,看的是软件栈:算子有没有写对、通信有没有重叠、显存有没有省下来。峰值是屋顶,实际吞吐是你站的位置,中间这段距离,主要靠软件把你往上抬。
国产芯片的裸算力早就够用了。昇腾从 910B 迭代到 910C,单卡峰值一直在追。真正卡住的,是中间这层软件栈。过去两年国产算力在推理侧打转,不是芯片不行,是训练对软件栈的要求高出一个数量级(来源:中国工信新闻网·人民邮电报、华为全联接大会 2026 官方发布),而这层一直没人先补上。
96% 是从软件栈里抠出来的
96% 到底从哪来?官方模型卡里列了四项协同优化:细粒度 MoE 通信优化、选择性重计算、DVM 自动图算子融合,还有 Ascend C 写的 mHC 融合算子(来源:Hugging Face 模型卡)。拆开看,就是三类活儿。
通信。MoE 每个 token 只激活 40 亿参数,意味着每次 forward 都要在专家之间搬数据,通信是藏起来的大头。把 MoE 通信做细、让计算和通信重叠,省下的就是吞吐。
内存。重计算把「存中间结果」换成「用时再算一遍」,牺牲一点算力,换显存空间,塞得下更大的 batch。
算子。融合算子和图算子融合,本质是把一堆小算子焊成一个大算子,少几次显存读写和启动开销。
三件事没有一件是芯片的功劳。所以 96% 不是硬件被榨出来了,是软件栈终于把硬件的实际性能往上抬了一截。模型卡原文是这么写的:
overall training throughput was improved by approximately 96% over out-of-the-box performance.
注意那个 baseline:out-of-the-box,开箱状态。这 96% 是「开箱即用」和「调优之后」的差距,官方内部对比,目前没有第三方复现(来源:Hugging Face 模型卡)。含金量全在「开箱」两个字上——国产训练栈过去长期停在开箱状态,性能潜力一直在,只是没人去调。
不是孤例,是一条正在闭合的栈
单看 Xing4.0,可以说它是孤例。但把时间轴拉开,这一周发生的三件事,拼起来是一条正在闭合的栈。
训练侧,Xing4.0 以 Apache-2.0 协议开源了权重和配置文件(transformers/safetensors 格式,含 custom code),并在模型卡里公开了训练侧的优化方法(来源:Hugging Face 模型卡)。开源训练经验,比开源一个权重值钱。
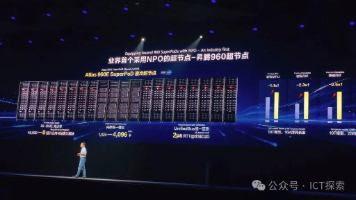
芯片侧,华为 9 月 17 日全联接大会发布昇腾 960 超节点:4096 卡、8 EFLOPS FP8、1PB HBM,配套 L3.5 层 PB 级 KV 缓存方案 OceanStor M900。这里有两件事要分清。PB 级 KV Cache 是已发布的产品;「10 万卡」是华为给十万亿参数模型训练画的参考配置(25 个 4096 卡超节点组网),「100 万卡」是多轨道拓扑下的集群规模上限,属路线图愿景而非落地数字(来源:华为全联接大会 2026 官方发布、InfoQ)。昇腾 960 芯片本身还没就绪——DT 版要到 2027 年一季度、PR 版要到 2027 年三季度,而且都是研发超预期、比原计划提前的结果(来源:澎湃新闻)。这台超节点是「芯片未到、架构先行」。
语音侧,科大讯飞 9 月 16 日发布 Spark-Audio-1.0-Preview,全流程在昇腾 910B、海光 BW1000 等国产芯片上训练(来源:科大讯飞官方微博)。语音这条线也走通了。
「够用、可控、便宜」,跟「越大越好」拧着
把 Xing4.0 放回它自己的定位里,会看到一个有意思的张力。官方对它的描述是「面向智能体时代打造的轻量级代码智能体大模型」,29B 总参、4B 激活、低比特量化后能在消费级显卡本地跑(来源:中国工信新闻网·人民邮电报)。
这个定位是「够用、可控、便宜」,不是「越大越好」。它跟开源社区里 scaling law 的主流信仰是拧着的——过去三年,开源界默认的进步路径是堆参数、堆算力,越大越接近智能。Xing4.0 反着来:先问够不够用,再问贵不贵。
我倒不觉得这是路线之争。它更像是在回答另一个问题:当训练栈只能跑在昇腾上、算力供给受制于国产芯片的产能,你自然会把模型做小、把效率做高。不是不想做大,是「做大」这件事在国产栈上算出来的账,跟英伟达栈上算出来的账,不是同一本。当参数不再是唯一标尺,训练栈的成熟度就浮上来了。
断在一个问题上
写到这里,我其实没有答案,只有一个问题。
当一条「芯片—算子库—框架—模型」的训练栈第一次在公开场合完整走通,并且走通的那一方把它开源了,中国大模型的竞争坐标,会不会从「追参数」悄悄挪到「比栈的成熟度」?
参数是明牌,谁家发布都能报一个数字。栈的成熟度是暗牌:算子库全不全、通信稳不稳、断点续训能不能接上、从昇腾 910C 迁到 960 要改多少代码。这些没人会在发布会 PPT 上写,但决定了一个团队在国产算力上到底能训多大的模型、花多少钱。
Xing4.0 是第一个公开证据,不是终局。它证明「能训」,还远没证明「好训、便宜地训、大规模地训」。那 96% 是从软件栈里抠出来的,反过来也说明,软件栈里还抠得出多少,没人知道。
这个问题,我先放在这儿。
参考资料
- Xing4.0-29B-A4B 模型卡,Hugging Face:https://huggingface.co/XingChen-AGI/Xing4.0-29B-A4B
- Xing4.0-29B-A4B 代码仓库,GitHub:https://github.com/XingChen-AGI/Xing4.0-29B-A4B
- 《首个全栈国产轻量级智能体大模型 Xing4.0-29B 发布》,中国工信新闻网·人民邮电报
- 华为全联接大会 2026 汪涛主题演讲(华为官方发布)
- 《汪涛详解华为 AI 战略:算力为核心,昇腾 960 提前登场,PB 级 KV Cache 把基础设施推入新阶段》,InfoQ
- 科大讯飞官方微博(Spark-Audio-1.0-Preview 发布)

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)