
CANN 异构计算架构详解:连接 AI 框架与昇腾硬件的五层桥梁
CANN 异构计算架构详解:连接 AI 框架与昇腾硬件的五层桥梁
昇腾深度学习技术系列 · 第 4 篇 / 共 20 篇
上一篇:昇腾芯片演进史
下一篇:昇腾软件栈版本体系与开发环境搭建
一、引言:CANN 是什么,为什么重要
芯片再强,没有人写软件,它就是一块硅片。
NVIDIA 的统治地位,本质上不是硬件的统治,而是 CUDA 生态的统治。从 2006 年 CUDA 1.0 发布算起,NVIDIA 用了将近 20 年,构建了一个覆盖编程接口、编译器、算子库、调试工具、框架适配的完整软件栈。全球数百万 GPU 开发者在这个生态上工作、创新、积累——这是 NVIDIA 最深的护城河。
华为在昇腾上面对的核心挑战,不只是设计出一颗算力强大的芯片,更是构建一套能与之匹配的软件栈。这套软件栈,就是 CANN(Compute Architecture for Neural Networks,异构计算架构)。
CANN 的定位
CANN 是昇腾 AI 处理器与其上层的 AI 框架、AI 应用之间的桥梁。向上,它对接 MindSpore、PyTorch、TensorFlow 等主流框架;向下,它驱动昇腾 AI 处理器的 Cube、Vector、Scalar 三大计算单元高效运转。
用 NVIDIA 的类比来理解:CANN 对标的是整个 CUDA 生态——不只是 CUDA Runtime,还包括 cuDNN、cuBLAS、NCCL、TensorRT 等组件的总和。但两者在架构设计上截然不同:CUDA 是一整套紧密耦合的通用 GPU 计算平台,CANN 则是面向神经网络计算的分层解耦架构。
CANN 开源进程
CANN 的开源进程是理解其生态现状的关键:
| 时间节点 | 事件 |
|---|---|
| 2025年8月 | 华为宣布全面开源 CANN |
| 2025年底 | 基于 910B / 910C 的代码完成全面开源 |
| 截至2026年9月 | 外部开发者占比 61%,月活开发者 5200+ |
| 当前版本 | CANN 9.1.1(稳定版)、CANN 9.2.0-beta.2(社区版) |
CANN 的开源代码托管在 AtomGit 平台,外部开发者占比已超过六成,覆盖 PyTorch、Triton、vLLM、veRL 等 90+ 主流社区项目。昇腾也已成为 PyTorch 官网可直接安装的算力平台——这是中国首个获此认可的平台。
一个值得关注的信号是:CANN 9.1.0 完成了商用版与社区版的归一,意味着开源社区版和商业发行版共用同一套代码基线,未来开源节奏将与产品上市保持同步。
这一篇文章,我们深入 CANN 的内部,拆解它的五层架构设计、每一层的核心职责、关键组件的设计思路,以及与 CUDA 生态的对比分析。
二、CANN 五层架构全景
整体架构
CANN 的设计哲学是分层解耦、逐层抽象。从上到下分为五层,每一层对上提供统一接口,对下屏蔽实现细节:
| 层级 | 模块组成 |
|---|---|
| 第①层:AscendCL(编程接口层) | AscendCL编程接口 |
| 第②层:计算服务层 | AOL算子库、AOE调优引擎、ATB加速库、框架适配器 |
| 第③层:计算编译层 | GE图引擎、毕昇编译器、TBE张量加速引擎 |
| 第④层:计算执行层 | Runtime、Graph Executor、DVPP、AIPP、HCCL集合通信 |
| 第⑤层:计算基础层 | SVM共享虚拟内存、VM虚拟化、HDC通信 |
| 底层硬件 | 昇腾 AI 处理器硬件(达芬奇架构) |
为什么是五层?
五层设计不是刻意的"堆叠",而是对应了实际工程中的五个关注点:
- 开发者需要什么接口? → 第①层 AscendCL
- 框架需要什么服务? → 第②层计算服务层
- 代码怎么编译? → 第③层计算编译层
- 任务怎么执行? → 第④层计算执行层
- 底层资源怎么管理? → 第⑤层计算基础层
与 CUDA 对比来看:CUDA 更像是"一个大平层"——CUDA Runtime、cuDNN、cuBLAS 等组件虽然逻辑上独立,但在实际使用中高度耦合,版本绑定紧密。CANN 则通过显式的分层,实现了更好的解耦——你可以在不改动上层代码的情况下,替换某一层的实现。
下面逐层展开。
2.1 第①层:AscendCL(编程接口层)
AscendCL 是 CANN 面向开发者的唯一入口。它提供统一的 C/C++ 和 Python API,所有对昇腾硬件的操作——无论是模型推理、算子执行、内存管理还是设备控制——都通过 AscendCL 完成。
核心功能模块
| 功能模块 | 模块说明 |
|---|---|
| Device 管理 | 设备初始化、信息查询、去初始化 |
| Context 管理 | 上下文创建与销毁,关联设备 |
| Stream 管理 | 流创建、同步、事件管理 |
| 内存管理 | Device 侧内存的申请、释放、拷贝 |
| 模型加载与执行 | OM 模型加载、推理执行、结果获取 |
| 算子加载与执行 | 单算子的编译、加载、执行 |
| 媒体数据处理 | JPEG/PNG 编解码、视频处理(与 DVPP 配合) |
设计亮点
高度抽象,API 归一。 这是 AscendCL 最重要的设计理念。在早期版本中,算子编译、加载、执行分属不同的 API 接口,开发者需要分别调用多个函数来完成一次算子执行。AscendCL 将这些操作统一为一组标准 API,大幅减少了接口数量,降低了学习曲线。
向后兼容。 使用旧版本 CANN 编译的应用程序,可以直接在新版本 CANN 上运行,无需重新编译。这对企业级客户至关重要——他们不可能每次升级 CANN 都重新编译所有应用。
零感知硬件差异。 一套接口适配多款昇腾 AI 处理器。在 910B(arch22)和 910C(arch22)上编写的程序,可以无缝迁移到 950(arch35)上运行,开发者不需要为不同芯片编写不同的代码路径。硬件差异由下层的编译层和执行层自动处理。
典型应用场景
AscendCL 面向三类用户:
- 推理应用开发者:加载训练好的 OM 模型,编写推理服务;
- 框架开发者:通过 AscendCL 将 PyTorch / TensorFlow 的计算请求下发到昇腾硬件;
- ISV(独立软件开发商) :封装第三方 lib 库为昇腾算子,扩展算子能力。
一个简化的 AscendCL 推理流程示例:
// 1. 初始化 ACL
aclInit(NULL);
// 2. 设置设备
aclrtSetDevice(deviceId);
// 3. 创建上下文
aclrtContext context;
aclrtCreateContext(&context, deviceId);
// 4. 加载模型
aclmdlDesc* modelDesc = aclmdlCreateDesc();
aclmdlLoadFromFile(modelDesc, “model.om”);
// 5. 创建模型描述并分配内存
aclmdlDataset* inputDataset = …;
aclmdlDataset* outputDataset = …;
// 6. 执行推理
aclmdlExecute(modelId, inputDataset, outputDataset);
// 7. 获取输出结果
// …
// 8. 资源释放
aclmdlDestroyDesc(modelDesc);
aclrtDestroyContext(context);
aclrtResetDevice(deviceId);
aclFinalize();
可以看到,整个流程与 CUDA 的 cudaMalloc / cudaMemcpy / cudaLaunchKernel 等 API 在概念上是对等的,但 AscendCL 进一步抽象了模型级别的执行——加载一个 OM 模型后,一条 API 就能完成整个推理流程,不需要逐个算子调度。
2.2 第②层:计算服务层
计算服务层是 CANN 的"智能中心",负责算子库、自动调优、模型加速和框架适配四大核心服务。
AOL(Ascend Operator Library)算子加速库
AOL 是昇腾的"cuDNN + cuBLAS",提供 1400+ 深度优化、硬件亲和的高性能算子,按功能分为五个子库:
| 子库功能 | 类别 | 典型算子 |
|---|---|---|
| NN 库 | 神经网络算子 | Conv2d、BatchNorm、ReLU、Softmax、LayerNorm |
| BLAS 库 | 线性代数 | GEMM、MatMul、矩阵分解 |
| CV 库 | 计算机视觉 | Resize、Crop、ColorConvert、Padding |
| Math 库 | 数学基础计算 | Add、Mul、Exp、Log、ReduceSum |
| Transformer 库 | Transformer 专用 | FlashAttention、RoPE、RMSNorm、GeGLU |
开源治理是 AOL 的一个亮点。华为为 AOL 设计了三层贡献模型:
- 核心层:1500+ 基础算子,经过严格性能测试和 API 稳定性验证,长期维护;
- 扩展层:200+ 领域算子,面向特定场景(如 NLP、CV),API 可能随版本调整;
- 孵化层:实验性算子,供社区贡献者提交,尚未经过全面验证。
这种分层治理思路类似于 Linux 内核的 mainline / staging / out-of-tree 模型,既保证了核心算子的质量和稳定性,又为社区贡献提供了低门槛的入口。
AOE(Ascend Optimization Engine)自动调优引擎
AOE 是 CANN 的性能自动优化核心。它的价值在于:让开发者不需要手动调优,就能获得接近最优的性能。
AOE 提供三级自动调优:
| 层级名称 | 缩写 | 做什么 |
|---|---|---|
| 子图级 | Sub-Graph Auto Tuning(SGAT) | 识别计算密集型子图,尝试不同的算子融合策略 |
| 算子级 | Operator Auto Tuning(OPAT) | 搜索最优 Tiling 参数和流水线并行度 |
| 梯度级 | Gradient Auto Tuning(GDAT) | 优化训练场景下通信与计算的重叠 |
SGAT 的工作方式:在图编译阶段,AOE 分析计算图的结构,识别出可以融合的算子组合(例如 Conv + BN + ReLU),然后尝试多种融合策略,用性能模型评估每种策略的预期耗时,选择最优方案。
OPAT 的工作方式:对于一个具体的算子(如 GEMM),OPAT 会搜索不同的 Tiling 配置——数据块大小、流水线深度、并行度等参数组合,找到当前硬件和当前数据规模下的最优配置。
GDAT 的工作方式:在分布式训练场景下,梯度同步(AllReduce)和反向计算之间的重叠度直接影响训练效率。GDAT 自动分析计算图,将通信操作插入到计算空闲期,最大化通信-计算重叠。
对比 CUDA:NVIDIA 的调优主要依赖手动(开发者通过 Nsight 等工具分析性能瓶颈,手动调整),TensorRT 有一定自动优化能力但局限于推理场景。CANN 的 AOE 在训练和推理场景下都能自动调优,这是一个有意义的差异化设计。
ATB(Ascend Transformer Boost)加速库
ATB 是专为 Transformer 模型设计的加速库,是大模型推理的核心组件。它包含:
- FlashAttention:高效注意力计算,减少 HBM 访问量;
- MoE(Mixture of Experts) :专家路由与负载均衡算子;
- KV Cache 管理:PagedAttention 风格的显存管理;
- 量化推理:支持 FP8 / INT8 / INT4 权重量化推理。
ATB 在 MindIE(昇腾推理引擎)和 vLLM-ascend 中作为底层加速组件被调用,是大模型推理性能的关键保障。
框架适配器(Framework Adaptor)
框架适配器负责将 PyTorch、TensorFlow、MindSpore 等框架的计算图,转换为 CANN 内部可以理解和执行的表示形式。
以 PyTorch 为例:当用户调用 torch.nn.functional.conv2d() 时,PyTorch 前端会生成一个 ATen 算子描述。TorchNPU(昇腾的 PyTorch 插件)通过框架适配器,将这个 ATen 算子翻译为 CANN 内部算子调用,再经过 GE 图引擎编译优化后下发到硬件执行。
框架适配器屏蔽了框架间的差异——无论上层是 PyTorch 还是 TensorFlow,到达 GE 图引擎时,算子描述已经是统一的内部格式。
2.3 第③层:计算编译层
编译层是 CANN 的"翻译中枢",负责将高层框架的计算图翻译为昇腾硬件可执行的机器码。它由三个核心组件构成。
GE(Graph Engine)图引擎
GE 是计算图编译和执行的控制中心,功能对标 NVIDIA 的 TensorRT(推理场景)和 XLA(训练场景)。
核心职责:
- 图优化:算子融合(如 Conv + BN + ReLU 融合为单个算子)、常量折叠、死代码消除、内存复用优化;
- 自动流水线:将计算图拆分为可流水线执行的子图,最大化硬件利用率;
- 图执行:在 AI 处理器上创建计算闭环,管理任务调度和数据流;
- 多前端支持:接受来自 PyTorch(通过 TorchNPU)、TensorFlow、MindSpore 的计算图输入,支持 ONNX 和
Protobuf 模型格式。
GE 的图优化能力直接影响最终推理性能。一个设计良好的融合策略,可以将内存访问量减少 50% 以上,推理延迟降低 30-40%。
毕昇编译器(BiSheng Compiler)
毕昇编译器提供 Host-Device 异构编程的编译能力。它将开发者编写的 Ascend C 代码(运行在 Device 侧的算子代码)编译为昇腾 NPU 可执行的二进制。
毕昇编译器的关键特性:
- 微架构精准编译优化:编译器了解达芬奇架构的微架构细节(Cube 单元的数据块大小、Vector 单元的 SIMD
宽度、存储层次结构等),能够生成针对特定微架构优化的机器码; - 完备的调试支持:生成包含完整调试信息的二进制文件,支持断点调试、性能剖析、内存检查等工具链;
- 多架构目标:同一份 Ascend C 代码,可以编译为 arch22(910B/910C)或 arch35(950/960)的目标码。
TBE(Tensor Boost Engine)张量加速引擎
TBE 是基于 Python 的动态编程框架,主要用于自定义算子的开发。它提供两个层次的编程模型:
- TIK(Tensor Iterator Kernel)
:底层的张量迭代编程模型,开发者可以精确控制数据的搬运和计算过程,适合追求极致性能的算子开发; - 高级 DSL:基于 Python 的领域特定语言,提供更高层次的抽象,适合快速原型开发。
TBE 提供自动并行计算和自动内存管理能力——开发者描述计算逻辑,TBE 自动完成多核并行调度和内存分配。
需要注意的是:在 arch35(950/960)引入 SIMT 编程模型后,Ascend C 已取代 TBE 成为华为主推的算子开发方式(详见第三节)。TBE 主要服务于 arch22 平台上的存量算子。
2.4 第④层:计算执行层
执行层直接管理硬件资源,负责任务的调度、执行和通信。
Runtime 运行时
Runtime 是 CANN 最底层的运行时环境,直接管理昇腾 AI 处理器上的硬件资源:
- 内存管理:Device 侧 HBM 内存的申请、释放、回收;支持内存池化管理,减少频繁申请释放的开销;
- 任务调度:将编译后的任务(Task)下发到 NPU 的计算单元,管理任务队列和执行优先级;
- Stream 管理:管理计算流,支持多流并行执行,实现计算-搬运重叠。
Runtime 的 API 在 AscendCL 中被封装,开发者通过 AscendCL 间接调用 Runtime 的功能。
Graph Executor 图执行器
图执行器负责编译后计算图的运行调度。与 Runtime 的单算子执行不同,图执行器管理整个计算图的执行流程——包括算子间的依赖关系、数据传递、内存复用等。
DVPP(Digital Vision Pre-Processing)
DVPP 是昇腾芯片内置的硬件加速视觉预处理单元,独立于 AI Core 运行。它提供:
- 图像编解码(JPEG/PNG/BMP)
- 视频编解码(H.264/H.265)
- 图像缩放、裁剪、旋转
- 色彩空间转换(YUV ↔ RGB)
- 图像拼接与 padding
DVPP 的价值在于:将视觉预处理从 AI Core 中卸载出来,让 AI Core 专注于推理计算。这在图像处理密集的应用场景(如视频分析、自动驾驶)中尤为重要。
AIPP(Artificial Intelligence Pre-Processing)
AIPP 是面向 AI 推理场景的专用预处理单元,支持动态分辨率输入、Batch 维度的自动处理等 AI 特有的预处理需求。AIPP 可以集成到推理模型中,实现"预处理 + 推理"的端到端硬件加速。
HCCL(Huawei Collective Communication Library)集合通信库
HCCL 对标 NVIDIA 的 NCCL,是分布式训练和推理中卡间通信的核心组件。
支持的原语:
| 原语 | 说明 |
|---|---|
| AllReduce | 所有卡的数据归约后广播,最常用于数据并行梯度同步 |
| Broadcast | 一张卡的数据广播到所有卡 |
| AllGather | 收集所有卡的数据片段并拼接 |
| ReduceScatter | 归约后将结果分散到所有卡 |
| AllToAll | 所有卡之间交换数据,MoE 场景的核心原语 |
通信算法:
| 算法 | 适用拓扑 | 特点 |
|---|---|---|
| Ring | 环形拓扑 | 带宽利用率高,延迟与卡数线性增长 |
| Mesh | 网格拓扑 | 适合中等规模集群 |
| HD | 高维拓扑 | 适配昇腾的 HCCS / 灵衢互连拓扑 |
通信链路:HCCL 支持三种底层通信链路——HCCS(昇腾片间高速互连)、RoCE(基于以太网的 RDMA)和 PCIe。在 CloudMatrix 超节点中,HCCL 通过 HCCS / 灵衢链路实现卡间高速通信;在跨节点场景下,通过 RoCE 实现节点间通信。
最新特性:
- PDCCL(Prefill-Decode Collective Communication Library)
:为大模型推理场景设计的显存资源预留机制,避免推理过程中的通信操作抢占推理显存; - HIXL(Huawei Inter-chip eXchange Layer) :底层通信接口开放,允许上层组件(如
HCCL、MindIE)更精细地控制通信行为。
2.5 第⑤层:计算基础层
计算基础层是 CANN 最底层的基础设施,提供三个核心能力:
| 组件 | 全称 | 功能 |
|---|---|---|
| SVM | Shared Virtual Memory | 共享虚拟内存,实现 Host(CPU)与 Device(NPU)之间的统一内存地址空间 |
| VM | Virtual Machine | 设备虚拟化,支持单物理设备虚拟为多个逻辑设备 |
| HDC | Host Device Communication | 主机-设备通信通道,管理 CPU 与 NPU 之间的指令下发和状态上报 |
SVM 的意义在于:CPU 和 NPU 可以访问同一块物理内存(通过地址映射),减少不必要的内存拷贝。这在大模型场景中尤其重要——当模型权重超过单卡 HBM 容量时,SVM 允许部分权重驻留在 Host 内存中,按需加载到 Device。
VM 支持将一块物理昇腾芯片虚拟为多个逻辑设备(MIG 风格的实例隔离),在多租户场景下实现资源的灵活分配。
三、算子开发三条路径
对于需要开发自定义算子的开发者,CANN 提供三条路径:
| 路径 | 语言 | 适用场景 | 特点 |
|---|---|---|---|
| Ascend | CC/C++ | 追求极致性能的系统级开发 | 原生 C/C++ 标准,多层抽象,自动并行,孪生调试 |
| Triton on Ascend | Python | 习惯 GPU 编程范式的开发者 | Python 语法,低成本迁移 NVIDIA Triton 算子 |
| CATLASS 模板库 | C++ 模板 | GEMM 类算子快速开发 | 基于模板的模块化组装,类似 CUTLASS |
Ascend C:华为主推的算子开发语言
Ascend C 是当前华为主推的算子开发方式,从 arch35(950/960)开始成为首选,同时向下兼容 arch22(910B/910C)。
硬件架构抽象
Ascend C 对达芬奇架构的存储层次做了清晰的抽象:
┌──────────────────────────────────┐
│ Global Memory (HBM) │ ← 大容量,高带宽
├──────────────────────────────────┤
│ Local Memory │
│ ┌────┬────┬────┬────┬────┐ │
│ │ UB │ L1 │L0A │L0B │L0C │ │ ← 小容量,超低延迟
│ └────┴────┴────┴────┴────┘ │
│ Unified Vector AIC AIC AIC │
│ Buffer Cache Input Weight Out │
└──────────────────────────────────┘
- Global Memory(HBM) :片外高带宽存储,存放模型权重和激活值;
- UB(Unified Buffer) :Vector 单元的数据缓冲区;
- L1 Cache:Cube 单元的共享数据缓存;
- L0A / L0B / L0C:Cube 单元的输入缓存(L0A 存放输入 A,L0B 存放权重 B)、输出缓存(L0C 存放计算结果)。
编程范式:三阶段流水线
Ascend C 的核心编程范式是 CopyIn → Compute → CopyOut 三阶段流水线:
时间轴 →
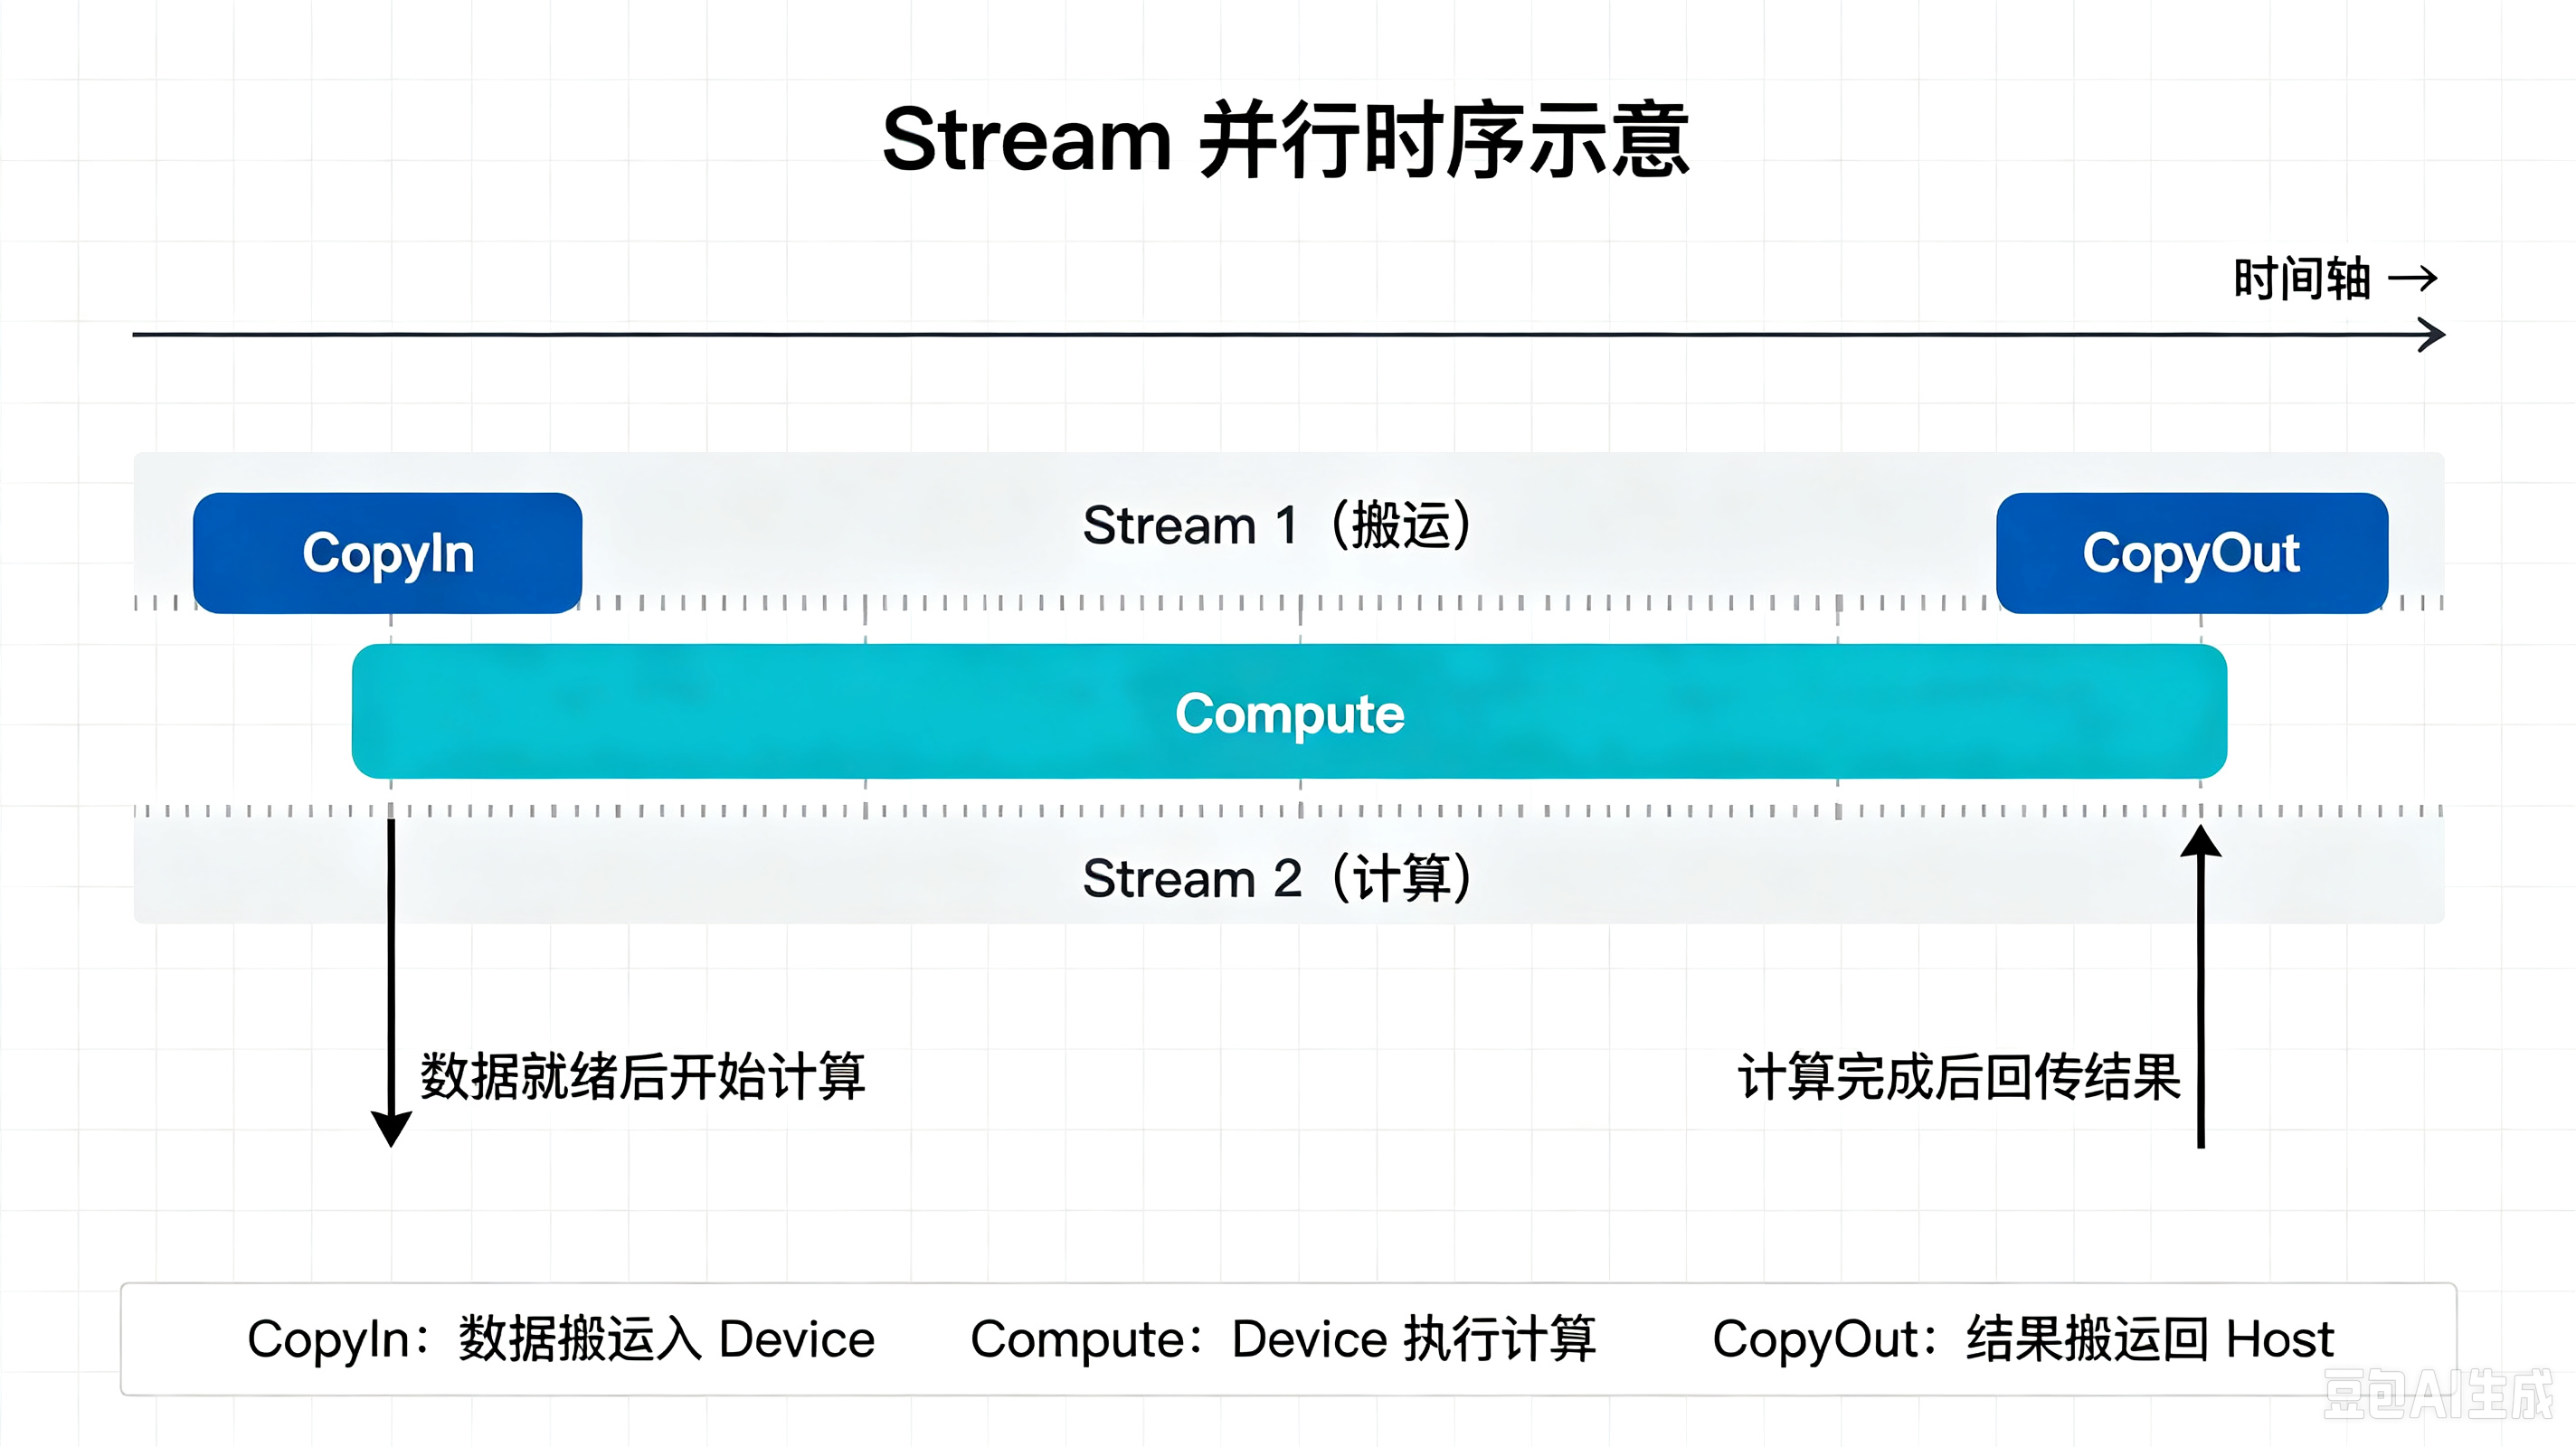
- CopyIn:将数据从 Global Memory 搬运到 Local Memory(UB / L1 / L0A / L0B);
- Compute:在 Local Memory 上执行计算(Cube 矩阵运算、Vector 向量运算、Scalar 标量运算);
- CopyOut:将计算结果从 Local Memory 搬回 Global Memory。
双缓冲技术是 Ascend C 的性能关键:通过合理的流水线编排,让 CopyIn(下一块数据搬运)与 Compute(当前块计算)重叠执行,隐藏内存搬运延迟。这与 GPU 编程中的 software pipelining 思路一致。
SIMD 与 SIMT 双模
- arch22(910B/910C) :仅支持 SIMD 模式,开发者需要显式管理向量化操作;
- arch35(950/960) :同时支持 SIMD 和 SIMT 模式。SIMT 模式下,开发者可以编写类似 CUDA
的线程级代码,编译器自动完成向量化——大幅降低了从 NVIDIA 平台迁移的门槛。
四、CANN vs CUDA:架构对比
| 维度 | CANN | CUDA |
|---|---|---|
| 定位 | 面向神经网络的异构计算架构 | 通用 GPU 计算平台 |
| 硬件基础 | 达芬奇架构(Cube + Vector + Scalar 三单元) | GPU 架构(SM + Tensor Core) |
| 分层设计 | 显式五层架构,逐层解耦 | 隐式分层,组件紧耦合 |
| 算子库 | AOL(1400+ 算子,开源) | cuDNN / cuBLAS(闭源) |
| 图编译 | GE 图引擎 + 毕昇编译器 | TensorRT(推理)/ XLA(训练) |
| 通信库 | HCCL(支持 Ring/Mesh/HD 算法) | NCCL |
| 算子开发 | Ascend C / Triton on Ascend | CUDA C++ / Triton |
| 自动调优 | AOE(三级自动调优:SGAT/OPAT/GDAT) | 以手动为主,TensorRT 部分自动 |
| 开源状态 | 2025 年底全面开源 | 部分开源(CUDA Runtime 闭源) |
| 框架适配 | MindSpore 原生 + PyTorch / TF 适配器 | PyTorch / TF 原生支持 |
| 异构编程 | Host-Device 模式,毕昇编译器 | Host-Device 模式,NVCC 编译器 |
关键差异分析
1. 分层 vs 紧耦合
CANN 的显式五层架构是它最显著的设计特征。每一层有明确的边界和职责,层与层之间通过标准接口通信。这意味着:
- 可以独立升级某一层而不影响其他层;
- 社区可以贡献特定层的实现(如 AOL 算子);
- 不同的硬件版本可以共享上层软件栈。
CUDA 的设计更"一体化"。CUDA Runtime、Driver、cuDNN、cuBLAS 之间耦合紧密,版本绑定。好处是整体优化空间更大(NVIDIA 可以从编译器到硬件做端到端优化),代价是生态的开放性和灵活性较低。
2. 自动调优降低门槛
AOE 的三级自动调优是 CANN 的差异化优势。在 CUDA 生态中,性能优化主要依赖开发者手动完成——分析 Nsight Profiler 输出,调整 Tiling 参数、共享内存用量、线程块配置等。这对开发者的硬件理解要求很高。
CANN 的 AOE 将这个过程自动化了。对于大部分常见场景,AOE 能给出接近最优的配置。开发者不需要深入了解达芬奇架构的微架构细节,就能获得良好的性能。这是一个务实的设计——降低门槛,扩大开发者基数。
3. 生态积累的巨大差距
这是必须正视的现实。CUDA 从 2006 年发布至今,积累了 20 年的生态:
- 数百万开发者;
- 几乎所有主流 AI 框架的原生支持;
- 丰富的第三方库和工具;
- 海量的教程、文档和社区资源。
CANN 的开源还不到一年,生态建设才刚起步。虽然外部开发者占比已达 61%,月活 5200+,覆盖 90+ 社区项目,但与 CUDA 的百万级开发者基数相比,差距仍然巨大。昇腾成为 PyTorch 官网可直接安装的平台是一个重要里程碑,但从"能装上"到"好用"再到"首选",还有很长的路要走。
4. 开源策略的差异化
CUDA 的核心运行时仍然是闭源的。NVIDIA 开源了部分工具链(如 Triton 编译器、NCCL),但核心组件的封闭性一直是社区的一个痛点。
CANN 选择了全面开源的路线,包括算子库、图引擎核心逻辑、通信库等。这是一个大胆的策略——意味着社区可以深度参与 CANN 的开发和优化,而不是仅仅"使用"它。如果执行得好,CANN 有可能建立起一个比 CUDA 更开放的生态。
五、CANN 开源生态现状与展望
开源代码结构
CANN 的开源代码托管在 AtomGit 平台,核心仓库包括:
| 仓库内容 | 说明 |
|---|---|
| ops-nn | 神经网络算子库(Conv、BN、Softmax 等) |
| ops-transformer | Transformer 专用算子(Attention、MoE 等) |
| ops-math | 数学基础算子(加减乘除、规约、扫描等) |
| ops-cv | 计算机视觉算子(Resize、Crop 等) |
| opbase | 基础算子框架和公共组件 |
社区数据(截至 2026 年 9 月)
| 指标 | 数值 |
|---|---|
| 外部开发者占比 | 61% |
| 月活开发者 | 5200+ |
| 覆盖社区项目 | 90+ |
| 原生训练模型 | 40+ |
| 框架适配 | PyTorch、Triton、vLLM、veRL 等 |
生态里程碑
- PyTorch 官方支持:昇腾成为 PyTorch 官网可直接安装的算力平台,这是中国首个获得此认可的平台。用户通过 pip
install torch + torch_npu 即可在昇腾设备上运行 PyTorch 代码。 - 商用版与社区版归一:CANN 9.1.0 实现了商用版和社区版共用同一代码基线,消除了"开源版阉割"的担忧。
- 开源与产品同步:未来 CANN 的开源节奏将与新品上市保持同步,确保社区开发者能第一时间获取新硬件的支持。
展望
CANN 开源生态正处于 “从可用到易用” 的关键转型期。当前阶段的核心任务是:
- 完善文档与教程:降低新开发者的入门门槛;
- 丰富算子覆盖:补全主流模型所需的算子,减少"算子缺失"导致的适配问题;
- 提升调试体验:完善 Profiler、Debugger 等开发工具,让性能调优更直观;
- 扩大社区贡献:吸引更多开发者和 ISV 参与算子贡献、框架适配和最佳实践分享。
开源是 CANN 生态爆发的前提。只有当社区足够活跃、算子足够丰富、文档足够完善时,开发者才会真正"用脚投票",从 CUDA 迁移到昇腾平台。这个过程不会一蹴而就,但方向已经明确。
六、总结
CANN 是昇腾生态的根基。它的五层分层设计,在 AI 框架与昇腾硬件之间建立了清晰的抽象边界——框架开发者不需要了解达芬奇架构的细节,算子开发者不需要关心上层的框架差异,应用开发者只需要调用 AscendCL 的统一接口。
几个核心结论:
- 分层解耦是 CANN 最大的架构优势。它让每一层可以独立演进,让社区可以分层贡献,让不同代的芯片可以共享同一套软件栈。
- AOE 自动调优是差异化的竞争力。在大模型时代,手动调优的门槛越来越高,自动调优的价值越来越大。
- 开源是 CANN 生态爆发的必要条件。2025 年底的全面开源、商用版与社区版归一、PyTorch 官方支持——这些里程碑正在逐步兑现。
- 生态差距仍然巨大。CUDA 20 年的积累不是一朝一夕能追赶的。CANN 需要的是持续投入和耐心,而不是短期冲刺。
从第一篇的全栈概览,到第二篇的达芬奇架构,到第三篇的芯片演进,再到这一篇的 CANN 软件栈——我们已经完整覆盖了昇腾从硬件到软件的核心技术栈。下一篇,我们转向更实用的主题:如何在本地搭建昇腾开发环境,选择合适的 CANN 版本,编写并运行第一个昇腾程序。
下一篇预告
第 5 篇:昇腾软件栈版本体系与开发环境搭建
理论讲够了,该动手了。下一篇是一篇实战指南:
CANN 的版本命名规则、商用版与社区版的区别、如何选择适合的版本
开发环境搭建全流程:驱动安装、CANN 安装、PyTorch + TorchNPU 配置
第一个昇腾程序:从安装到运行一个完整的 PyTorch 推理 Demo
常见问题排查:驱动版本不匹配、CANN 环境变量、NPU 设备不可见等
敬请期待。
本文是「昇腾深度学习技术系列」第 4 篇。系列覆盖从芯片架构到框架、从算子开发到集群训练的完整知识体系,共 20 篇,持续更新中。

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 1
 0
- 0


 已为社区贡献5条内容

所有评论(0)