
slime 源码走读:SGLang-Native 推理架构解析(上)
作者:昇腾实战派
知识地图:https://blog.csdn.net/Lumos_Lovegood/article/details/161601003
前言
昇腾平台当前已支持slime框架
前不久搞了一段时间的 OpenClaw-RL,算是第一次在 slime 框架上完成了一次实战。此前只停留于源码走读,并不深入,趁着这个机会,刚好整理一下对 slime 框架推理部分的源码走读。
本文走读所参照的启动配置来自 OpenClaw-RL/toolcall-rl/retool_qwen3_4b_rl.sh,核心配置如下:
ray job submit ... -- python3 train_async.py \
   --actor-num-nodes 1 \
   --actor-num-gpus-per-node 4 \      # 训练占 4 GPU
   --rollout-num-gpus 4 \             # 推理占 4 GPU
   --rollout-num-gpus-per-engine 2 \  # 每个推理引擎 TP=2
   --n-samples-per-prompt 8 \         # GRPO:每个 prompt 采样 8 条
   --rollout-batch-size 32 \
   --custom-generate-function-path generate_with_retool.generate \
   --custom-rm-path generate_with_retool.reward_func
从这份配置可以读出本文走读的 slime 形态:单节点 8 GPU,训练和推理各占 4 GPU 的解耦部署;推理侧起 2 个 SGLang 引擎,每个 TP=2;工具调用逻辑通过 --custom-generate-function-path 注入。
文章由粗到细介绍每个关键模块,分为四章:
- 第 1 章 推理的整体架构:调用栈、核心组件、与 verl 的对比、异步训练循环
- 第 2 章 资源初始化与四级层级:placement group 切片、四级层级结构
- 第 3 章 推理数据平面:SGLangEngine、sgl-router、HTTP 客户端
- 第 4 章 推理控制流:dynamic sampling 双层 while、partial rollout(下篇介绍)
重点在第 3、4 章。本文主要介绍前3章,第4章内容较多,拆分到下篇了,晚点也会整理出来。
1 推理的整体架构
1.1 服务化推理
slime 从设计之初就采用服务化推理——SGLang 以 HTTP Server 形式作为独立服务运行,训练侧通过 asyncio 并发地发送 HTTP 请求到 sgl-router,router 再将请求转发给后端的 SGLang 引擎。
这条路和 verl 0.7.0 之后切换到的 vLLM async server 方案在思想上一致,都是为了解决 SPMD 模式的两个根本缺陷:
- 同步阻塞,长尾响应拖累整体吞吐。SPMD 把推理引擎嵌入训练 worker 进程内部——一个 batch 里 128 条 prompt,只要有一条生成得特别慢,整个集群都要停下来等它。这个长尾在 RL 场景下尤为突出,因为奖励较高的轨迹往往对应更长的输出。
- 同步批处理的生成模型难以表达 agent 场景。多轮工具调用要求”生成一段 → 调用工具 → 再继续生成”的暂停-恢复语义,而 SPMD 的同步生成模型是”一次调用,一次返回”,中间无法插入工具执行逻辑,也无法让不同请求按自己的节奏独立前进。
服务化推理把推理引擎从”训练 worker 进程内的对象”变成”独立运行的 HTTP 服务”,配合 asyncio.gather 实现请求级并发——每条 prompt 在一个独立的 coroutine 里运行,慢的不阻塞快的,agent 多轮交互也变得自然。
这导致 slime 整个推理架构都围绕”如何与一个原生的、独立运行的 SGLang server 协作”展开——是后续所有设计的起点。
想了解slime设计思想的同学可以直接看他们的官方博客**:**slime:为 RL Scaling 设计的 SGLang-Native 后训练框架 — slime
1.2 整体调用栈
一次异步训练从 train_async.py 启动,rollout 阶段的完整调用链如下:
train_async.py(异步训练入口,无 Trainer 类封装)
  └── async loop(for rollout_id in ...):
        ├── rollout_manager.generate.remote(rollout_id)         # Ray RPC,非阻塞
        │     └── RolloutManager.generate(rollout_id)
        │           ├── _get_rollout_data
        │           │     ├── call_rollout_fn(self.generate_rollout, ...)
        │           │     │     └── generate_rollout(...)               # 同步入口
        │           │     │           └── run(generate_rollout_async(...))   # 同步→异步桥接
        │           │     │                 # ↓ 进入 asyncio 世界
        │           │     │                 └── generate_rollout_async       # 双层 while + dynamic sampling
        │           │     │                       └── generate_and_rm_group   # group 级并发(asyncio.gather)
        │           │     │                             └── generate_and_rm   # 三层并发嵌套 + partial rollout mask
        │           │     │                                   ├── custom_generate(默认 generate / 用户函数如 retool)
        │           │     │                                   │     └── await post(router_url, ...)
        │           │     │                                   └── async_rm
        │           │     └── 展平 + global_batch_size 整除裁剪
        │           ├── _convert_samples_to_train_data
        │           └── _split_train_data_by_dp
        └── actor_model.async_train(rollout_id, ...)
调用链有三个层次值得留意:
- 进程层次:train_async.py 是 driver 进程,RolloutManager 是独立的 Ray Actor 进程,SGLang HTTP Server 和 sgl-router 各自是子进程。一个 rollout 涉及五类进程,跨进程通信用 Ray RPC 和 HTTP 两套机制。
- 执行模型:rollout 涉及三种不同性质的并发——generate.remote() 是 Ray RPC 进程间异步,driver 立即拿到 ObjectRef、不阻塞;generate_rollout 内部的 run(coro) 是线程间桥接——slime 用一个常驻后台线程跑 asyncio event loop,run(coro) 把协程提交过去、Ray worker 线程同步阻塞等结果;asyncio.gather 在后台线程的 event loop 里实现协程级并发,让几百条 sample 在同一个线程内同时在飞。三种并发各管各的层级,不互相替代。
- 数据层次:rollout 产出的 list[Sample] 经过”展平 + 裁剪 → convert → DP 切分”三步,变成训练侧可消费的、按 DP 切分好的引用列表。
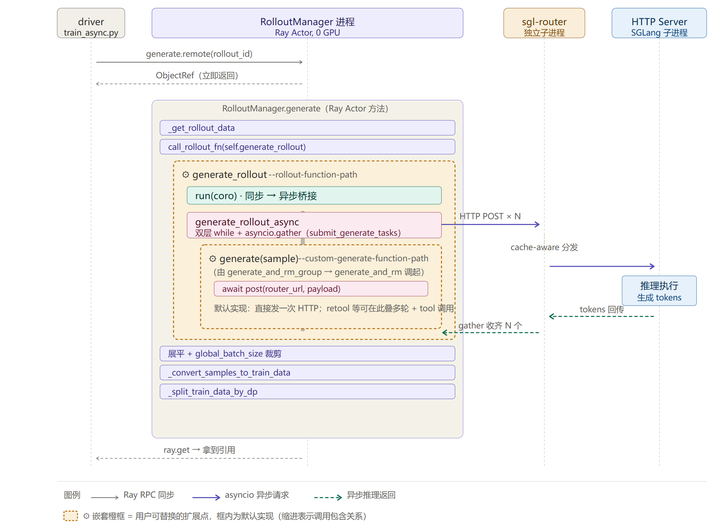
【图示】rollout 阶段的完整调用链
⭐ 这张图里有两个橙色虚框标出的扩展点最值得留意——generate_rollout 和 generate(sample),分别可通过 --rollout-function-path 和 --custom-generate-function-path 替换。它们对应两个不同层次的自定义:
- 替换 generate_rollout(外层),等于换掉整个 rollout 调度策略——双层 while、dynamic sampling、partial rollout 回收这一整套都没了,用户自己组织调度逻辑——比如fully_async的实现
- 替换 generate(sample)(内层),保留框架的并发调度,只换”单条 sample 怎么生成”——比如本文的 retool 就是在这里实现多轮工具调用
更多的自定义逻辑,感兴趣的同学可以直接看官方文档:自定义指南 — slime
第 4 章 4.1 节会展开默认的 generate_rollout 怎么实现 dynamic sampling 双层 while,4.6 节会展开 retool 怎么写 generate(sample)。
1.3 核心组件速览
slime 推理侧的核心组件如下表。需要特别说明的是,这些”组件”并非都是独立进程,其中有几个只是组织结构用的逻辑对象:
| 组件 | 运行形态 | 数量(本文配置) | 核心职责 |
|---|---|---|---|
| RolloutManager | Ray Actor(1 CPU, 0 GPU) | 1 | 调度入口:驱动 rollout、加载用户函数、数据后处理、DP 切分 |
| RolloutServer | dataclass(逻辑对象) | 每模型 1 个 | 一个模型一组引擎 + 一个 router;统一显存生命周期接口 |
| ServerGroup | dataclass(逻辑对象) | 每 worker 类型 1 个 | 同构引擎组,持有引擎槽位 |
| sgl-router | 独立进程 | 每 RolloutServer 1 个 | 统一 HTTP 入口,对引擎做 cache-aware 负载均衡 |
| SGLangEngine | Ray Actor(0.2 GPU 占位) | 2 | 引擎进程的守护者 + 网络注册,本身不做计算 |
| SGLang HTTP Server | 子进程(持有实卡 GPU) | 每引擎 1 个 | 真正执行推理 |
⭐ 这里有两个容易混淆的地方值得单独说明:
RolloutServer 和 ServerGroup 不是进程。 它们是 dataclass,活在 RolloutManager 这个 Ray Actor 的进程内部,只承担”组织结构”的角色。真正跨进程的只有四个:driver、RolloutManager、SGLangEngine、以及 SGLangEngine 拉起的 HTTP Server 子进程和 router 子进程。
SGLangEngine 不是”推理引擎”。 这个 Ray Actor 只占 0.2 GPU,本身不跑推理——它的职责是 launch_server_process 启动真正的 SGLang HTTP Server 子进程,并向 router 注册地址。真正吃 GPU、跑推理的是那个 HTTP Server 子进程。
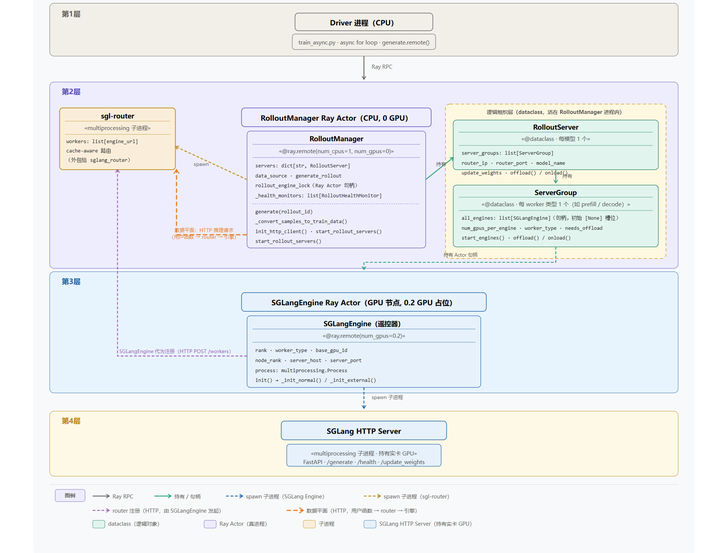
【图示】整体推理架构
1.4 异步训练循环
slime 支持两种部署模式:解耦(训练和推理用完全不重叠的 GPU,对应 verl 的 STANDALONE)和共置(–colocate,训练和推理共享 GPU,对应 verl 的 HYBRID/COLOCATED)。本文走读的是解耦模式,这一点在 train_async.py 的第一行就被钉死了:
def train(args):
    assert not args.colocate, "Colocation is not supported for async training."
异步训练强制要求解耦部署——异步的本质是”训练步执行的同时,rollout 引擎在生成下一批数据”,这要求训练和推理同时占用各自的 GPU。
train_async.py 没有 Trainer 类,训练循环是一个裸的 for loop:
rollout_data_next_future = rollout_manager.generate.remote(args.start_rollout_id)
for rollout_id in range(args.start_rollout_id, args.num_rollout):
    if rollout_data_next_future is not None:
        rollout_data_curr_ref = ray.get(rollout_data_next_future)
    if rollout_id + 1 < args.num_rollout:
        rollout_data_next_future = rollout_manager.generate.remote(rollout_id + 1)
    ray.get(actor_model.async_train(rollout_id, rollout_data_curr_ref))
这个异步循环成立有个前提:RolloutManager 必须是 Ray Actor,不是普通 Python 对象。正因为它是 num_gpus=0 的 Actor,rollout_manager.generate.remote(…) 才会返回 ObjectRef 立即返回,driver 不阻塞,异步流水线才搭得起来。
异步训练做了一件事:在 ray.get 拿到当前 rollout 数据之后、调用训练之前,立刻 .remote() 发起下一轮 rollout。这样训练步在 actor GPU 上执行时,下一轮 rollout 已经在 rollout GPU 上并行跑起来。官方愿景文档把这件事概括为一句话:”改变同步行为就像移动 ray.get 操作一样简单。”
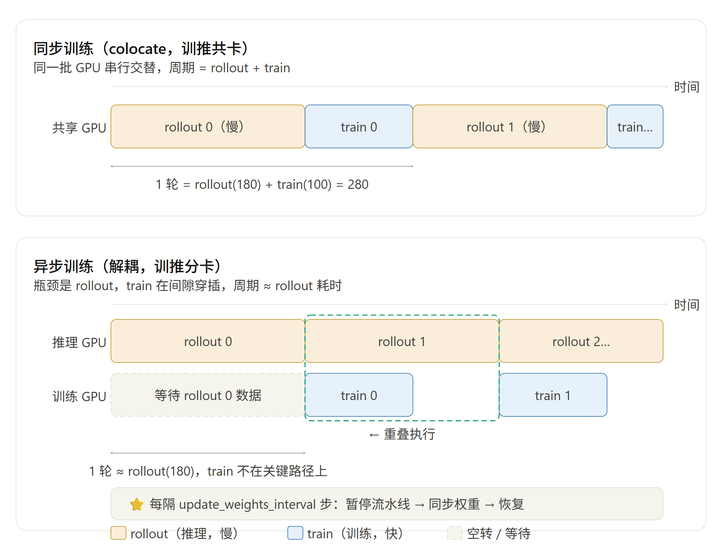
**异步并发的代价是 off-policy。**第 rollout_id+1 轮的数据是在第 rollout_id 轮训练完成之前就发起生成的,用的是上一步训练前的旧权重——也就是 one-step-off。
⭐ 这里有一个细节:权重更新是异步流水线上的”暂停点”。循环里每隔 update_weights_interval 步,会强制 ray.get 把飞行中的 rollout 等回来、把 future 置空,然后才执行 update_weights(),保证数据的新鲜度:
if (rollout_id + 1) % args.update_weights_interval == 0:
    rollout_data_curr_ref = ray.get(x) if (x := rollout_data_next_future) is not None else None
    rollout_data_next_future = None
    actor_model.update_weights()
第 1 章小结:本章建立了 slime 推理架构的整体视图。两个观察值得带到后续章节:
- 一是 slime 的 Ray Actor 在整个架构里只做调度和守护,不做计算——RolloutManager 0 GPU 调度、SGLangEngine 0.2 GPU 占位、SGLang HTTP Server 子进程吃实卡,三者分工严格;
- 二是异步训练循环的关键是 ray.get 的位置而非什么复杂机制,这种”用 Ray API 的位置表达异步语义”的思路贯穿全文。
第 2 章简述资源初始化,把”8 张 GPU 怎么变成 2 个跑起来的引擎”这件事讲清楚,作为后续两章深入推理数据平面和控制流的铺垫。
2 资源初始化与四级层级
这一章简述 slime 怎么把 8 张物理 GPU 组织成 2 个跑起来的推理引擎。底层用的是 Ray placement group 这套通用机制,本文不展开它的工程实现细节(探针、游标、端口分配等),只讲两件对理解推理架构关键的事:GPU 怎么被切分、最终的层级结构是什么样。
2.1 一个 placement group,靠偏移量切片
直觉上”训练和推理用不重叠的 GPU”应该对应”两个独立的资源池”,但 slime 不是这么做的——它只创建一个 placement group,覆盖全部 GPU:
num_gpus = args.actor_num_nodes * args.actor_num_gpus_per_node + args.rollout_num_gpus
pg, ... = _create_placement_group(num_gpus)
本文配置下 num_gpus = 1×4 + 4 = 8。actor 和 rollout 的区分不靠”两个池子”,而靠对同一个有序数组的不相交切片:
完整数组(8 个元素,已按物理位置排好序):
  [ idx0, idx1, idx2, idx3 | idx4, idx5, idx6, idx7 ]
    └─── actor 的视图 ────┘ └─── rollout 的视图 ────┘
                            ↑ rollout_offset = 4
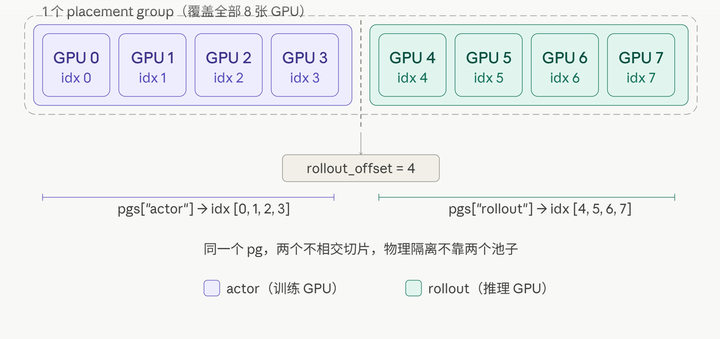
【图示】placement group
create_placement_groups 返回的是一个字典,三个角色引用同一个 pg,但附带的索引数组不同:
return {
    "actor": (pg, actor_pg_reordered_bundle_indices, actor_pg_reordered_gpu_ids),
    "critic": (pg, critic_pg_reordered_bundle_indices, critic_pg_reordered_gpu_ids),
    "rollout": (pg, rollout_pg_reordered_bundle_indices, rollout_pg_reordered_gpu_ids),
}
pgs[“actor”] 和 pgs[“rollout”] 引用同一个 placement group,只是 rollout_pg_reordered_bundle_indices 从 rollout_offset 索引开始取,actor 的从 0 开始取。两者附带的索引数组不相交,物理隔离就此达成。
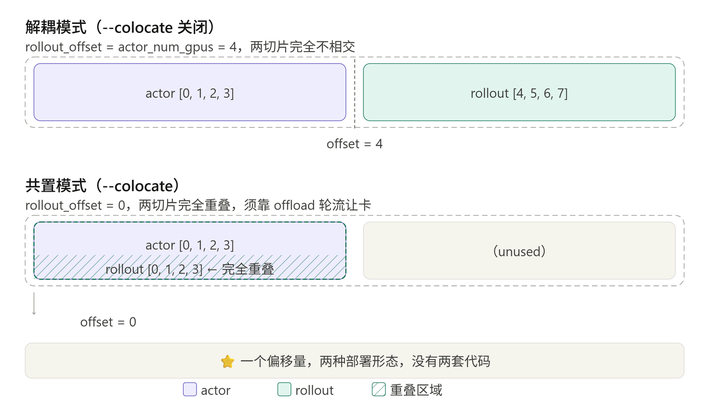
【图示】分离和共卡的差异
⭐ 这里有个和verl不一样的设计:共置和分离的全部差异,就是 rollout_offset 是 0 还是 actor_num_gpus**。**共置时 rollout_offset=0,rollout 切片是 [0:],和 actor 看的是同一段——物理完全重叠,所以才需要 offload 和 torch_memory_saver。解耦时 rollout_offset=actor_num_gpus,两者完全不相交。一个偏移量决定两种部署形态。
这里的数组之所以”已按物理位置排好序”,背后有个工程细节:
Ray 的 placement group API 不暴露 bundle 的物理绑定(”这个 bundle 在哪台机器哪张卡”),slime 通过一个叫 InfoActor 的探针拿到——临时在每个 bundle 上启一个 @ray.remote(num_gpus=1) 的 Actor,让它从进程内部调 ray.get_gpu_ids() 自报家门,收集完物理位置后立刻 ray.kill 销毁。整个流程几秒钟,不占长期资源。排序后逻辑连续即物理连续,上层代码可以用 gpu_offset + i × num_gpu_per_engine 算逻辑索引就拿到挨在一起的物理 GPU。
这套机制是 slime Ray 资源管理的核心工程实现,但对”推理架构”的贡献只是提供了”逻辑连续 = 物理连续”这个干净的世界——细节不展开。
2.2 四级层级
切片产物 pgs[“rollout”] 被传给 create_rollout_manager,后者创建 RolloutManager Ray Actor 并触发其 init,进而调用 start_rollout_servers,自顶向下搭出以下层级:
RolloutManager(Ray Actor, 0 GPU)
  ├── sgl-router(multiprocessing 子进程)       ← 数据平面的统一入口
  └── servers: dict[str, RolloutServer]
        └── RolloutServer(dataclass,每模型 1 个,含独立 router)
              └── server_groups: list[ServerGroup]
                    └── ServerGroup(dataclass,每 worker 类型 1 个)
                          └── all_engines: [SGLangEngine, SGLangEngine]
每一级对应一个真实需求:
- sgl-router 是 RolloutManager 直接 spawn 的独立子进程,不在 servers 体系内,是数据平面的统一入口——所有推理请求先到达它,再由它分发到具体引擎。第 3 章详述。
- servers 字典支持多模型推理共存(actor 采样、reference 算 KL、reward model 打分),每个模型有自己独立的 router 避免请求流相互干扰。
- server_groups 列表支持 PD(Prefill/Decode)分离部署——prefill 计算密集、decode 访存密集,两者最优 TP size 可能不同。本文配置只有一个 group。
- ServerGroup 是同构引擎组,引擎列表初始就是 [None] * num_engines 的槽位数组——这个”None 槽位”设计让初始化和容错恢复变成同一段代码:start_engines 只做一件事,”把所有 None 槽位填满”。
- SGLangEngine 是真正的 Ray Actor,第 3 章详述。
start_rollout_servers 里有个细节值得在第 3 章前先点一下:每个模型启动时都会把自己的 router 地址记录下来,但对第一个模型有一个特殊处理:
if model_idx == 0:
    args.sglang_router_ip = router_ip
    args.sglang_router_port = router_port
单数形式的 args.sglang_router_ip/port 是一个向后兼容的快捷方式——大多数训练任务只有一个模型(一个 actor),用户函数直接用这两个字段拼 URL 就够了,不需要感知”自己用的是哪个模型”。多模型场景下,完整版是 args.sglang_model_routers,它以模型名为 key 存了所有模型的 router 地址。
这条线在第 4 章用户代码里会被收回——retool 的 generate 函数就是用这两个字段拼 URL 调用 router 的。
第 2 章小结: slime 用”一个 placement group + 偏移量切片”统一了共置和解耦两种部署模式;层级结构中 RolloutManager、SGLangEngine、sgl-router 和 SGLang HTTP Server 是真进程,中间两级(RolloutServer、ServerGroup)是活在 RolloutManager 进程内的 dataclass 逻辑对象。至此 2 个 SGLang 引擎已经在 GPU 4-7 上跑起来、注册到了 router。第 3 章不再看”怎么搭起来”,看”搭起来之后是什么形状”——一个推理请求和一条控制指令分别走的是哪条路。
3 推理数据平面
第 2 章讲的是”怎么搭起来”。这一章换一个视角:不看过程,看搭起来之后的形状。一个推理请求从用户函数发出、到拿回生成结果,中间经过哪些进程、哪些通道;一条控制指令从 RolloutManager 发出、到 SGLang 引擎执行,又走的是哪条路。
3.1 三条路径
slime 的推理侧有三条通信路径,终点相同、入口和用途不同。
数据路径承载生成请求。用户的 generate 函数里那句 await post(router_url, payload),请求先到 sgl-router,由 router 分发给某个 SGLang 引擎,引擎生成完返回。这条路是”多对多”的,是稳态运行时最繁忙的通道。
控制路径承载指令。RolloutManager 要让引擎 offload、训练侧要更新权重、HealthMonitor 要探活——这些操作通过 SGLangEngine 这个 Ray Actor 的方法调用发出,内部翻译成 HTTP 请求,直连目标引擎的 host:port,不经过 router。这条路是”点对点”的。
元数据路径承载注册与注销。引擎启动并通过健康检查后,SGLangEngine 主动向 router 发送 POST /workers 注册自己;引擎关闭前,SGLangEngine 向 router 发送 DELETE /workers 注销。这条路只在引擎生命周期的首尾两个时刻发生,不参与稳态运行。
数据路径:   用户 generate 函数 ──await post──> sgl-router ──分发──> SGLang HTTP Server

控制路径:   RolloutManager ──Ray RPC──> SGLangEngine ──requests──> SGLang HTTP Server
                                              (Ray Actor)         (直连,不过 router)

元数据路径:  SGLangEngine ──HTTP POST/DELETE──> sgl-router /workers
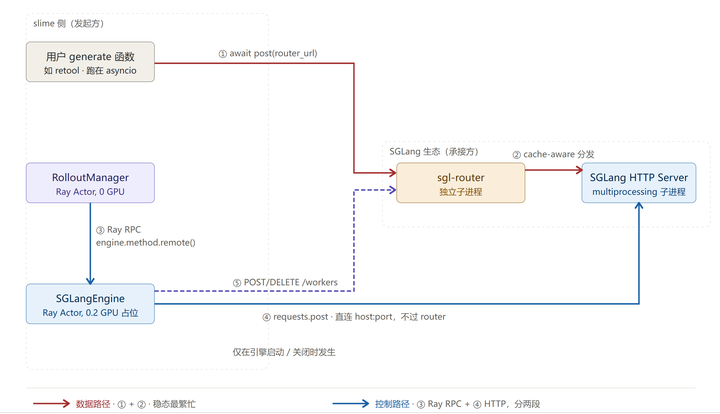
【图示】数据流
三条路径终结于同一个 SGLang HTTP Server 子进程。3.2 节讲控制路径和元数据路径的引擎侧,3.3 节讲数据路径和元数据路径的 router 侧,3.4 节讲数据路径和控制路径各自的 HTTP 客户端。
3.2 SGLangEngine:Ray Actor 形态的遥控器
SGLangEngine 不是推理引擎,它是一个 Ray Actor 形态的遥控器,本质是”SGLang HTTP 端点”到”Ray 可远程调用方法”的一层适配。
两段式初始化
SGLangEngine 有两个初始化方法。init 是 Ray Actor 构造时执行的:
def __init__(self, args, rank, worker_type="regular", base_gpu_id=None, ...):
    self.args = args
    self.rank = rank
    # 只存参数,什么都不启动
init 只做参数赋值;init 才真正干活,由 ServerGroup.start_engines() 显式调用,接收第 2 章 start_engines 分配好的网络参数:
def init(
    self,
    dist_init_addr,                       # 分布式初始化地址
    port,                                 # HTTP server 监听端口
    nccl_port,                            # NCCL 通信端口
    host=None,                            # 本机 IP,None 时自动探测
    disaggregation_bootstrap_port=None,   # PD 分离下 prefill 的 bootstrap 端口
    router_ip=None,                       # router 地址,None 时回退到 args
    router_port=None,
):
    # 1. 确定 router 地址:参数 > args 全局配置
    self.router_ip = router_ip or self.args.sglang_router_ip
    self.router_port = router_port or self.args.sglang_router_port

    # 2. IPv6 地址格式化(::1 → [::1],避免 URL 解析歧义)
    host = _format_v6_uri(host or get_host_info()[1])
    ip_part, port_part = dist_init_addr.rsplit(":", 1)
    dist_init_addr = f"{_format_v6_uri(ip_part)}:{port_part}"

    # 3. 计算完整的 SGLang ServerArgs
    server_args_dict, external_engine_need_check_fields = _compute_server_args(...)
    self.node_rank = server_args_dict["node_rank"]
    self.server_host = server_args_dict["host"]
    self.server_port = server_args_dict["port"]

    # 4. 按 rollout_external 分流
    if self.args.rollout_external:
        self._init_external(server_args_dict, external_engine_need_check_fields)
    else:
        self._init_normal(server_args_dict)   # ← 本文走这条
⭐ 拆成两段是因为”先占位、后配置”——端口在 Actor 创建之后才分配。Ray Actor 构造时拿不到 dist_init_addr、port、nccl_port 等网络参数,只能先 init 把 Actor 进程占在 bundle 上,等第 2 章 start_engines 分配好端口、再 init.remote(…) 把它们传进来。
init 内部做四件事——确定 router 地址、处理 IPv6 格式(一个 slime 真的跑在多种网络环境下的工程细节)、计算 SGLang ServerArgs、按 rollout_external 分流。后两条路径下一节展开。
两条初始化路径:自启 vs 接管
init 根据 args.rollout_external 走两条不同的路:
┌─ rollout_external=False  →  _init_normal     # 自己 spawn SGLang 子进程
init() 内部分流 ──┤
                  └─ rollout_external=True   →  _init_external   # 接管已存在的外部 SGLang
_init_normal**(默认,本文走这条)**:slime 自己 spawn 一个 SGLang HTTP Server 子进程,然后向 router 注册。下一节展开。
⭐ _init_external**(外部接管模式)**:SGLang 已经在外面起好了,slime 只是”连过去”——
def _init_external(self, expect_server_args, external_engine_need_check_fields):
    # 阻塞等外部引擎健康
    _wait_server_healthy(base_url=..., is_process_alive=lambda: True)

    # 从外部引擎拉实际配置
    actual_server_args = requests.get(f"http://.../get_server_info").json()

    # 逐字段校验:外部引擎的实际配置必须和我期望的一致
    for name in external_engine_need_check_fields:
        assert actual_server_args[name] == expect_server_args[name], ...
⭐ SGLangEngine 这个 Ray Actor 甚至能远程接管一个已经运行的 SGLang 实例,而不是非要自己拉起它。接管的方式不是”再启动一遍”,而是”通过 /get_server_info 拉外部配置、逐字段校验和期望一致”。这进一步坐实了 SGLangEngine **不是引擎本身、只是引擎的”代理人”。**本文配置走 _init_normal,这条路径不展开。
_init_normal 做两件事:(1) 拉起 SGLang 子进程,(2) 如果是 node-0,向 router 注册自己:
def _init_normal(self, server_args_dict):
    # (1) 启动 SGLang HTTP server 子进程
    self.process = launch_server_process(ServerArgs(**server_args_dict))

    if self.worker_type == "encoder":
        return                            # encoder worker 不参与 router 注册

    # (2) 只有 node-0 注册到 router
    if self.node_rank == 0 and self.router_ip and self.router_port:
        # ... POST /workers ...           # 详见 3.3.2
本节先看第一件,注册细节留到 3.3.2 节。
launch_server_process 的核心只有三行:
multiprocessing.set_start_method("spawn", force=True)
p = multiprocessing.Process(target=launch_server, args=(server_args,))
p.start()
⭐ SGLang 的 HTTP Server 不是 Ray Actor——它是 SGLangEngine 用 multiprocessing.Process spawn 出来的独立 OS 进程。launch_server 来自 sglang.srt.entrypoints.http_server,是 SGLang 自己的服务入口,没有任何包装。这是”SGLang-native”在进程层面的兑现。
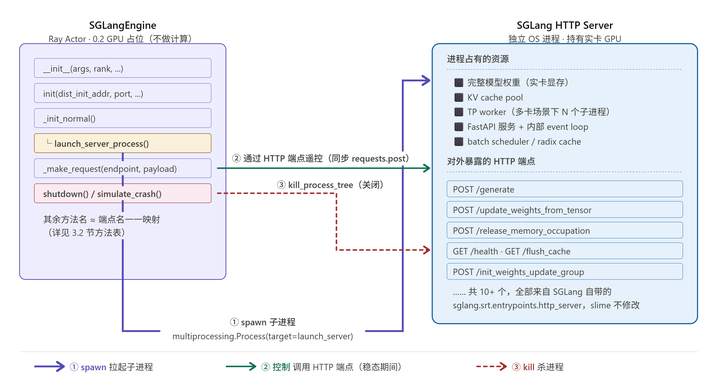
方法表 ↔ 端点表
SGLangEngine 类剩下的方法高度同构,核心是一行 _make_request:
def _make_request(self, endpoint, payload=None):
    if self.node_rank != 0:
        return
    url = f"http://{self.server_host}:{self.server_port}/{endpoint}"
    response = requests.post(url, json=payload or {})
    response.raise_for_status()
    return response.json()
⭐ SGLangEngine 的方法表本质上是 SGLang HTTP Server 端点表的一一映射——Ray Actor 的方法名就是 HTTP 端点名:
| SGLangEngine 方法 | HTTP 端点 | 用途 |
|---|---|---|
| release_memory_occupation | /release_memory_occupation | 释放显存 |
| resume_memory_occupation | /resume_memory_occupation | 恢复显存 |
| update_weights_from_tensor | /update_weights_from_tensor | 从 GPU 直传权重 |
| update_weights_from_distributed | /update_weights_from_distributed | 通过 NCCL 通信组拉取权重 |
| update_weights_from_disk | /update_weights_from_disk | 从磁盘重载权重 |
| init_weights_update_group | /init_weights_update_group | 初始化 NCCL 权重更新组 |
| destroy_weights_update_group | /destroy_weights_update_group | 销毁 NCCL 通信组 |
| check_weights | /weights_checker | 校验权重一致性 |
| post_process_weights | /post_process_weights | 权重加载后处理 |
| get_weight_version | /get_weight_version | 获取当前权重版本号 |
if self.node_rank != 0: return 意味着非 node-0 的 Actor 对所有控制指令都是空操作:SGLang 内部的 TP 通信会把 node-0 上的 offload / update_weights 等状态变更同步给整个 TP 组。
当然也有少数例外,绕开了通用通道:
| 方法 | 为什么不同 |
|---|---|
| flush_cache | 自己写了 60 次重试循环——”有 pending 请求时 flush 会失败” |
| health_generate | 对非主节点 return True 而非 None——健康检查不能因为是 TP worker 就被视为”不响应” |
| pause_generation | 直接 requests.post,需要拿 response 对象本身而非 JSON |
| continue_generation | 同上 |
| start_profile | 参数多且复杂,直接拼 JSON body 更灵活 |
| stop_profile | 同上 |
这些例外说明”方法表 ↔ 端点表”的映射不是完全机械的——业务语义有特殊需求时,slime 会绕开通用通道。
_make_request 用的是同步 requests——因为这些方法被 Ray RPC 调用,Ray 已提供进程间并发。这和数据路径上用户函数里的异步 post 是两套,3.4 节展开。
3.3 sgl-router:slime 视角下的统一入口
数据路径和元数据路径的核心都是 sgl-router。但讲它之前要先说清楚一件事:router 不是 slime 的代码,是 sglang_router 这个独立包的东西。slime 对它的全部”掌控”,就是启动它、配置它、通过接口往它的 worker 列表里增删引擎——router 内部怎么路由,slime 不实现、也不直接知道。这个边界本身就是本节的一个论点。
3.3.1 启动
router 在 RolloutManager类的初始化中调用start_rollout_servers 通过 _start_router 启动:
router_args = RouterArgs.from_cli_args(args, use_router_prefix=True)
process = multiprocessing.Process(target=run_router, args=(router_args,))
process.daemon = True
process.start()
router 和 SGLang 引擎是同一个模式——都是用 multiprocessing.Process spawn 出来的 SGLang 生态原生组件子进程。run_router 只是对 sglang_router.launch_router 的薄封装。process.daemon = True 意味着 router 的生命周期跟着 RolloutManager 走、自动清理。
_start_router 里 force_new=(model_idx > 0) 回收第 2 章的设计——第一个模型复用已有 router,后续每个模型强制起新 router。多模型 = 多个 router 子进程、各监听各的端口,避免请求流互相干扰。
RouterArgs.from_cli_args(args, use_router_prefix=True) 是 slime 第三套”前缀透传”机制——Megatron 参数直接透传、SGLang 参数 --sglang- 前缀透传,这里是 --router- 前缀透传。⭐ 三个第三方组件、三套透传、slime 不重新封装任何一个的配置。
3.3.2 引擎注册:”先健康,后注册”
router 启动时 worker 列表为空。引擎的注册发生在 SGLangEngine.init() → _init_normal() 里——这是 3.1 节”元数据路径”的具体落点:
self.process = launch_server_process(...)   # ① spawn 子进程 + ② 内部 _wait_server_healthy

if self.node_rank == 0 and self.router_ip and self.router_port:
    payload = {
        "url": f"http://{self.server_host}:{self.server_port}",
        "worker_type": self.worker_type,
    }
    response = requests.post(
        f"http://{self.router_ip}:{self.router_port}/workers",
        json=payload,
    )
三个关键细节:
“先健康,后注册”。 launch_server_process 内部对 node-0 的引擎调用 _wait_server_healthy,阻塞等到 /health 返回 200 才返回。执行到 POST /workers 时引擎已真正可用。
由 SGLangEngine 代为注册。 注册是 SGLangEngine 这个 Ray Actor 发起的 HTTP POST,HTTP Server 本身不感知 router 的存在——这一点很重要:SGLang 子进程是 SGLang-native 的,它接受来自任何来源的请求(包括 router 转发的数据请求、也包括 SGLangEngine 直连的控制指令),它不知道也不关心自己有没有被注册到某个 router 上。router 是 HTTP Server 的前置代理,但 HTTP Server 不依赖 router。这种解耦让 slime 可以在引擎之外灵活配置路由策略,SGLang 子进程不需要任何修改。
多卡 TP 下只有 node-0 注册。 非 node-0 的 _make_request 直接 return,TP worker 不暴露 HTTP 接口、不向 router 注册。router 的 worker 列表里每个引擎只出现一次——以 node-0 的地址为代表。
引擎注销时对称执行:先从 router DELETE /workers,再 kill_process_tree。生与死两端,”先健康后注册,先注销后杀”——保证 router 的 worker 列表始终只包含真正可用的引擎。
3.3.3 请求路由
引擎注册完毕后,数据平面的流通路就完整了。这个流程的起点是第 4 章将展开的 generate_and_rm,其中用户函数(如 retool)调用 await post(router_url, payload):
用户 generate 函数
  → await post(router_url, payload)
    → sgl-router 从 worker 列表中按 cache-aware 策略选择引擎(详见 3.3.5)
      → 转发 /generate 请求到该引擎的 HTTP Server
        → SGLang 执行推理
      → 透传结果给调用方
slime 负责把 worker URL 注册进去、在不可用时注销;router 负责在可用 worker 之间做选择。两者不越界。
3.3.4 两个被刻意关掉的开关
_start_router 里有两个配置最有信息量:
router_args.disable_circuit_breaker = True   # PD 分离下 RDMA 瞬时超时 ≠ worker 死
router_args.disable_health_check = True      # 容错由 slime 自己做
⭐ 两个 disable 合起来是同一个判断:router 被降级为纯粹的请求分发器——它路由,但不评判。
3.3.5 内部是黑盒
router 内部怎么在多引擎之间路由?这一层对 slime 是黑盒。cache-aware routing、负载均衡策略都在 sglang_router 包里。这和verl自己实现形成了鲜明的对比,slime把路由逻辑完全外包给了 sglang_router。这是”框架做减法 / SGLang-native”哲学最极端的样本——连负载均衡器都用 SGLang 生态现成的。
3.4 HTTP 通信层:两套客户端
3.2 节末尾埋了一笔:_make_request 用同步 requests,和用户函数里的异步 post 是两套。3.1 节的数据路径和控制路径,最终贯彻到了 HTTP 客户端这一层——两条路径对应两套完全不同的客户端:
| 维度 | 控制路径 | 数据路径 |
|---|---|---|
| 客户端 | requests(同步) | httpx.AsyncClient(异步) |
| 在哪 | SGLangEngine._make_request | http_utils.post |
| 调用者 | RolloutManager / 训练侧,经 Ray RPC | 用户函数(retool)、PRM,在 asyncio 里 |
| 目标 | 直连引擎 host:port | router 的统一入口 |
| 为什么这样 | Ray RPC 已提供进程间并发 | 跑在 event loop 里,几百并发必须 await |
控制路径。 _make_request(3.2 节已详述)用同步 requests,没有重试、没有异步、没有连接池——控制路径调用频率低(一次 rollout 只 offload/onload/update_weights 几次),Ray RPC 本身的重试和并发已经够用,内部只需把方法名翻译成 HTTP 端点名。
数据路径。 核心是 _post,带重试的异步函数:
async def _post(client, url, payload, max_retries=60, headers=None):
    retry_count = 0
    while retry_count < max_retries:
        try:
            response = await client.post(url, json=payload, headers=headers)
            response.raise_for_status()
        except Exception as e:
            retry_count += 1
            if retry_count >= max_retries:
                raise e
            await asyncio.sleep(1)        # 异步 sleep,不阻塞 event loop
            continue
        finally:
            if response is not None:
                await response.aclose()   # 防止连接池耗尽
        break
    return output
⭐ max_retries=60 意味着一个请求最多扛将近一分钟的间歇性失败——引擎可能正在 offload/onload、weight update 打断、router 在 worker 注册/注销窗口期。和 3.3 节关掉 circuit breaker 同一个判断:瞬时失败不等于真的坏了。重试等待用 await asyncio.sleep(1) 而非 time.sleep(1)——同步 sleep 会阻塞整个 event loop;finally 里无条件 await response.aclose()——否则连接池很快耗尽。
连接池容量 = semaphore 容量。 连接池在 init_http_client 里初始化:
_client_concurrency = args.sglang_server_concurrency * args.rollout_num_gpus // args.rollout_num_gpus_per_engine
_http_client = httpx.AsyncClient(
    limits=httpx.Limits(max_connections=_client_concurrency),
    timeout=httpx.Timeout(None),
    trust_env=False,
)
⭐ 公式和第 4 章 GenerateState.semaphore 容量完全一样。semaphore 是逻辑层并发闸门,连接池是传输层上限。两者相等,semaphore 是唯一的并发闸门,连接池不多不少正好接住。timeout=None 因为 RL 生成请求可能很长,设超时反而误杀;trust_env=False 避免 HTTP_PROXY 把内网直连请求绕到代理上。
第 3 章小结:
- 三条路径: 数据路径(用户函数 → router → 引擎)承载生成请求,控制路径(RolloutManager → SGLangEngine → 直连引擎)承载指令,元数据路径(SGLangEngine → router /workers)承载注册/注销——终点都是同一个 SGLang HTTP Server 子进程
- SGLangEngine 是遥控器: 真正的 SGLang 是 multiprocessing spawn 出来的独立 OS 进程,Ray Actor 只做启动和遥控
- router 是被外包的组件: slime 只配置、只通过 /workers 接口增删 worker,刻意关掉 health check 和 circuit breaker,把 router 降级为纯粹的请求分发器
- 两套 HTTP 客户端: 控制路径同步、数据路径异步;连接池容量和 semaphore 容量刻意对齐
全文小结
本文作为 slime 源码走读的上篇,聚焦于其推理侧的核心架构,揭示了 slime 如何以“SGLang-Native”的设计哲学,构建一套高效、解耦的异步推理系统。
我们不难发现,与从 SPMD 模式演进的 verl 不同,slime 自诞生之初便坚定地走向服务化推理。这种“没有历史包袱”的设计,使其整个架构围绕“与原生 SGLang 服务器协作”展开,呈现出几个鲜明的特点:
- 极简的资源隔离:通过“一个 Placement Group + 偏移量切片”的巧妙方式,用一个参数 rollout_offset 就统一了共置与解耦两种部署模式,实现物理资源的零冲突。
- 清晰的进程边界:架构中的“四级层级”严格区分了“逻辑组织”(RolloutServer, ServerGroup)与“物理进程”(RolloutManager, SGLangEngine, router)。SGLangEngine 被精确定义为 SGLang 进程的“遥控器”,而非引擎本身,这种抽象避免了职责混淆。
- 路径分离与组件外包:数据、控制、元数据三条路径各行其道,并分别配以同步 (requests) 与异步 (httpx) 两套客户端。同时,slime 将复杂的负载均衡工作完全外包给 sglang_router,自身仅做配置与 Worker 生命周期管理,体现了“框架做减法”的务实理念。
本篇已为理解其数据平面与控制平面打下基础。在下篇中,我们将以retool这个case为例,走读slime推理的端到端流程,深入 dynamic sampling 的双层 while 循环与 partial rollout 的精妙实现。

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)