
29B 的模型只要 4B 激活:中国电信 Xing4.0 的本地长上下文账
29B 的模型只要 4B 激活:中国电信 Xing4.0 的本地长上下文账
TL;DR 速览
- 发布:中国电信发布 Xing4.0-29B-A4B,29B 总参 / 4B 激活,原生 256K 上下文、可扩至 512K
- 显存账:FP16 下 29B 的权重约需 58GB;4-bit 量化后降到 15GB,省约 75% → RTX 3090 / 4090 这个档位能本地跑长上下文
- 训练侧:用昇腾 + 国产框架完成,是一条全栈国产路径
- 评测:SuperCLUE 智能体能力 93.52,列第 3,与前两名 Qwen 的差距不足 1 分
- 口径提醒:模型权重已上线 HuggingFace / 魔搭 / Gitee,但开源仓库 Xing4.0-29B-A4B 是 9-17 才建的,星标还在三位数——模型的分量和仓库的体量是两件事
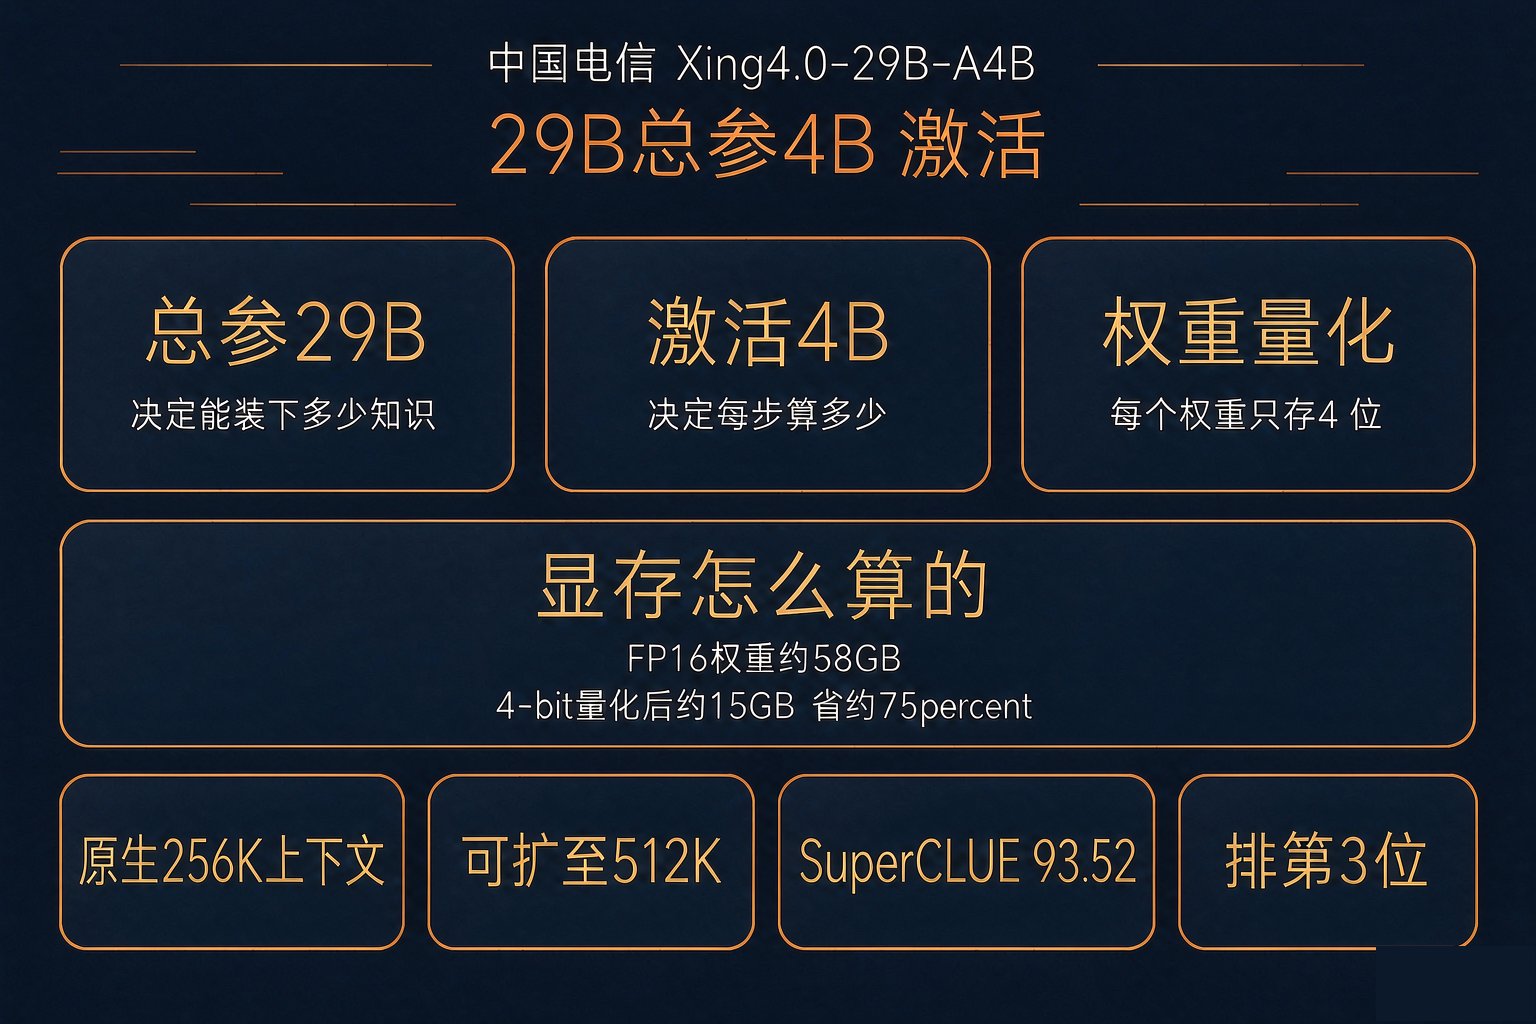
中国电信发布了 Xing4.0-29B-A4B,一个 29B 总参、4B 激活的智能体向模型。它的三个数字组合在一起才构成完整信息:原生 256K 上下文(可扩至 512K)、4-bit 量化后显存约 15GB、SuperCLUE 智能体能力 93.52 排在第 3,与前两名 Qwen 的差距不到 1 分。训练用的是昇腾和国产框架,权重已上线 HuggingFace、魔搭和 Gitee。
对打算在本地跑长上下文 Agent 的人来说,这篇要回答的是一个问题:4B 激活 + 15GB 这两个数字,在什么条件下成立,代价又是什么。
一、A4B 是什么意思:每生成一个 token 只惊动 4B 参数
先把命名拆开。29B-A4B 读作"总参数 29B,激活参数 4B"。
这类结构通常来自 MoE(混合专家):模型里有很多组专家权重,但一次前向只走其中一小部分。所以:
总参 29B 决定的是"模型能装下多少知识"——它决定了权重文件有多大、加载要多少显存。
激活 4B 决定的是"跑一步要算多少"——它决定的是计算量、吞吐和延迟。
这两个数字分离之后,模型设计就有了一个新的自由度:可以一边把总参堆上去(提升容量),一边把激活压住(控制成本)。 29B/4B 这个比例大概是 7 比 1,意味着同一份权重里,每一步只用到约 14% 的参数。
但这里有个工程上的坑必须说清楚:激活参数少,不等于显存占用小。 因为显存主要由权重决定,不是由计算量决定——29B 的权重就是 29B,你不因为在某个 token 上只激活 4B 就能少加载那 25B。这就是下一节那笔账存在的原因。
二、15GB 是怎么算出来的
把两笔账分开算,这个数字就顺了。
FP16 下:29B 参数 × 2 字节 = 约 58GB。这个量级不是 3090(24GB)或者 4090(24GB)能装下的,需要专业卡或者多卡。
4-bit 下:29B × 0.5 字节 = 约 14.5GB,官方口径四舍五入到 15GB。相比 FP16 节约约 75%。
24GB 的 3090 / 4090 装 15GB 权重是有余量的,而余量是要留给两个东西的:
KV cache:上下文越长,KV cache 越大。这是"本地跑长上下文"这件事真正的成本项——不是权重占多少,而是上下文能开多长。256K 这个数字听起来爽,但在 24GB 卡上,权重占掉 15GB 之后,留给 KV cache 的空间要靠量化 KV、滑窗、或者 paged attention 这类手段去挤。
激活与中间张量:MoE 的专家路由和临时张量还有额外开销,实际峰值显存会高于权重加 KV cache 的静态估算。
所以"3090 能跑 256K"是一个需要限定条件的说法。 更准确的说法是:3090 这个档位能装下这个模型的权重,长上下文能开到多长取决于你的量化策略和推理框架。 上手第一步别直接拉满 256K,先跑短上下文确认吞吐,再往上试——不然很容易撞 OOM,然后误判成模型不能用。
三、256K 扩到 512K:翻倍的不是一个数,是两笔成本
"原生 256K、可扩至 512K"这句话里,"原生"和"可扩"是两个不同的东西,值得分开看。
原生 256K 意味着训练阶段就在这个长度上做过对齐,长距离依赖的能力是训出来的,不是外推出来的。
可扩到 512K 通常靠位置编码外推加长上下文微调。这类扩展的典型代价有两个:一是中段召回下降(长上下文模型普遍存在的"lost in the middle"问题在更长的序列上更容易暴露),二是推理成本上升。
第二笔成本容易被低估。上下文从 256K 到 512K,KV cache 的规模近似翻倍,而注意力部分的计算量增长比线性更快。结果就是:上下文越长,单次请求的显存峰值和耗时涨得越快,而且这个涨幅不是线性的。
实用建议是把上下文当预算用,而不是当容量用。 512K 能开不代表该开。检索到多少喂多少、把不相关的历史主动截掉,在长上下文模型上通常比"全塞进去"效果更好,成本还低一个档次。这条在别的模型上也成立,不是这个模型特有的。
四、训练侧的国产全栈
官方给出的另一个信息是训练用了昇腾 + 国产框架。这件事的技术意义在于:
它验证的不只是"能跑通",而是"能训出可用的智能体模型"。 智能体向模型的训练难点不在预训练,而在后训练这一段——工具调用格式的对齐、多轮轨迹的信用分配、失败案例的筛选。这一段对框架稳定性和通信效率的要求,比纯预训练更高。
它同时约束了推理侧的硬件选择。 训练和推理如果都在同一套国产栈上,从权重格式到算子覆盖都能对齐,迁移成本低;但如果只有训练侧国产、推理侧还是 CUDA,中间会有一层转换损耗或者算子缺失的风险。这是选型时要问清楚的第一个问题。
配套的兼容面官方也列了:微调支持 LLaMA-Factory 和 MindFormers;推理支持 SGLang、vLLM、KTransformers;Agent 框架定向适配了 OpenCode、Claude Code、OpenClaw、Hermes。
这份清单本身就能当验收标准用:你现有的工具链在不在这四个里边。 如果不在,那"能不能跑"就要靠自己做适配,成本和直接换个模型重训一遍相比,未必更便宜。
记录本地部署经验我习惯只留两样东西:一张"上下文长度 vs 显存峰值"的实测表,和一份"哪个框架在哪一步报什么错"的清单。模型换代很快,这两份不用重做。我把它们和选题素材一起收在 墨衍 里,下次换模型直接拿曲线当基线比。
五、SuperCLUE 93.52 的读法
这个分数的正确读法是三点:
第一,看的是相对位置,不是绝对值。 93.52 排第 3,和前两名 Qwen 差不足 1 分。在一个差 1 分就能错开好几个名次的榜单上,这个差距基本落在评测噪声区间内。说得稳一点:“进入了第一梯队”,别说"追平了"。
第二,智能体能力是一个合成项。 它通常由工具调用、多步规划、指令遵循等子项加权而成。合成分接近,不代表子项分布接近——你的任务如果集中在某一个子项上,必须去看那一项的分,而不是看合成分。
第三,4B 激活这个体量拿到这个位置,本身就是信息。 它说明在小激活规模上做智能体能力是可行的。对小显存设备用户来说,这个结论比第 3 名这个名次更有价值。
别把榜单名次当部署依据。 榜单测的是通用任务,你的任务是具体的。93.52 的作用是让你愿意花时间试一下,不是让你跳过试这一步。
六、上手路径
按这个顺序走,每一步都有明确的失败信号:
- 先用最重的框架验证能不能跑起来。 SGLang 或 vLLM 起服务,上下文先设在 8K,只验证对话和工具调用格式对不对。这一步不通,后面都是白费。
- 确认量化版本。 直接拉 4-bit 版本(约 15GB)而不是 FP16——24GB 卡上 FP16 装不下,先用大模型跑通再降精度的顺序在这里不成立。
- 把上下文往上推到 32K,观察显存峰值曲线。 记录每个档位的峰值和吞吐,找到你这张卡的拐点。这一步的产物是一条你自己的曲线,比任何"能跑 256K"的说法都可靠。
- 跑一轮真实工具调用。 Agent 向模型和自己写的 prompt 之间最容易出问题的不是能力,是调用格式的严格程度。用你真实的工具清单测一遍。
- 要微调的话,先确认框架分支。 LLaMA-Factory 和 MindFormers 是两条不同的路,选错后续的算子问题会一直跟着你。
- 要接 Agent 框架的话,从官方清单里挑。 OpenCode / Claude Code / OpenClaw / Hermes 是做过定向适配的,自己接新的框架要有踩格式坑的心理准备。
七、值得记住的两个判断
第一个判断:MoE 让"本地跑大模型"的边界从"参数总量"挪到了"显存带宽和 KV cache"。 29B 总参能塞进 24GB 卡,靠的是量化;能开多长的上下文,靠的是 KV cache 治理。门槛从"买得起卡"变成了"调得动 KV cache"——这是个更便宜、但也更需要手艺的门槛。
第二个判断:国产栈的关键指标不是能不能跑,而是"从训练到推理有没有断点"。 昇腾训练 + SGLang/vLLM 推理 + 官方列出的四个 Agent 框架,构成一条如果成立就很有价值的链路;而这条链路上任何一个环节的适配缺口,都会变成你自己的工作量。
对读者的动作建议:先算你的上下文需求,再决定要不要碰 512K。 大部分 Agent 任务真正需要的是 32K 到 64K 之间的稳定表现,而不是极限长度。把预算花在"把你的典型任务塞进 64K"这件事上,收益通常比追那个更大的数字高。

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)