
从上手到生产:vLLM-Ascend 企业级实战全攻略(含部署脚本与面试题)
从上手到生产:vLLM-Ascend 企业级实战全攻略(含部署脚本与面试题)
本文基于 vLLM-Ascend 官方最新文档(v0.23.0 / CANN 9.0.1 / torch 2.10.0)与昇腾社区公开资料整理,覆盖从零安装到多机部署的完整链路,附带可直接复制的生产级脚本、竞品对比表与高频面试题。全文约 7000 字,建议收藏后按章节实操。
文章目录
一、痛点场景:为什么你在昇腾上跑大模型总是"差一口气"
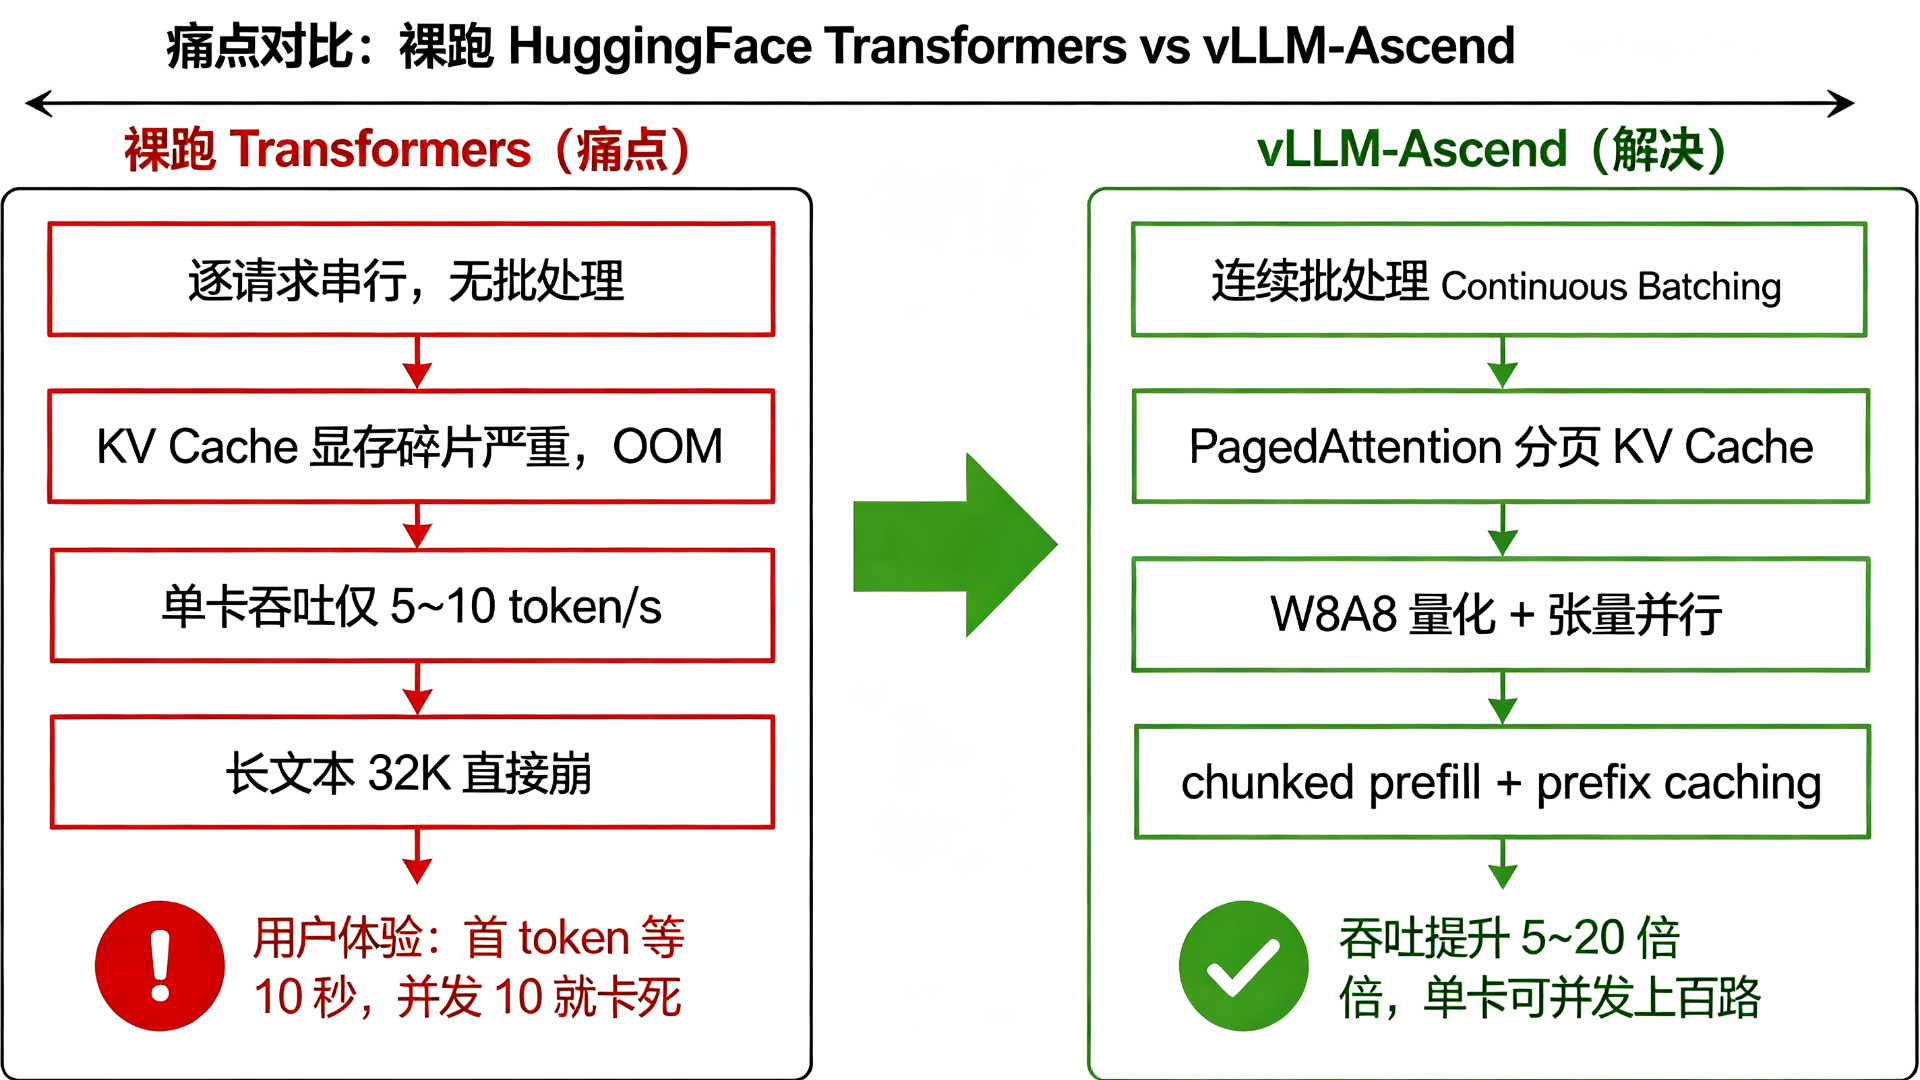
先讲一个笔者在企业项目里真实踩过的坑。
某金融客户要求在国产化机房上线一个 72B 级别的问答助手,硬件是 8 张 Atlas 800I A2(昇腾 910B)。第一版方案直接拿 HuggingFace Transformers 跑 model.generate(),结果:
- 单条请求首 token 延迟(TTFT)超过 8 秒,业务方投诉"像在拨号上网";
- 并发拉到 8 路时,NPU 显存直接 OOM 退出,日志里一堆
Illegal memory access; - 换了 MindIE 官方套件,性能确实上去了,但锁死了华为自家的模型仓和推理框架,团队想接 LangChain、想换 RAG 框架都要走定制开发;
- 想自己改个算子、加个日志 hook,发现源码闭源部分占比太高,二次开发门槛极高。
这不是个例。在国产化替代大背景下,越来越多的团队被推到昇腾 NPU 上,但市面上的推理方案大致分成三类,每一类都有自己的硬伤:
| 路线 | 典型代表 | 硬伤 |
|---|---|---|
| 直接裸跑 Transformers | HF Transformers + torch_npu | 无连续批处理,显存碎片严重,吞吐只有 vLLM 的 1/10 量级 |
| 全栈绑定华为 | MindIE 全家桶 | 性能强但生态封闭,定制成本高,与开源社区新特性脱节 |
| 用 CUDA 上的开源引擎硬搬 | vLLM-CUDA / TGI 强行移植 | 没有 NPU 后端,跑不起来或者性能腰斩 |
vLLM-Ascend 要解决的,就是这三难:既要 vLLM 开源生态的广度(PagedAttention、连续批处理、OpenAI 兼容接口、社区迭代速度),又要昇腾 NPU 原生硬件的深度优化(HCCS 通信、W8A8 量化、NPU Flash Attention),还要让团队用熟悉的 Python API 就能上手。
如果你正在经历下面任意一种场景,这篇文章就是为你写的:
- 公司刚采购了昇腾服务器,领导要求"下周就要出一个能演示的模型服务";
- 现有 vLLM 服务跑在 A100 上,现在要迁移到昇腾 910B/910C,担心性能断崖;
- 面试被问到"你了解 vLLM-Ascend 吗",只能说出"华为版的 vLLM"五个字;
- 已经在跑 vllm-ascend,但被版本对齐、CANN 驱动、OOM 这些问题按在地上摩擦。
二、是什么:用三维度把 vLLM-Ascend 讲透
2.1 专业解释
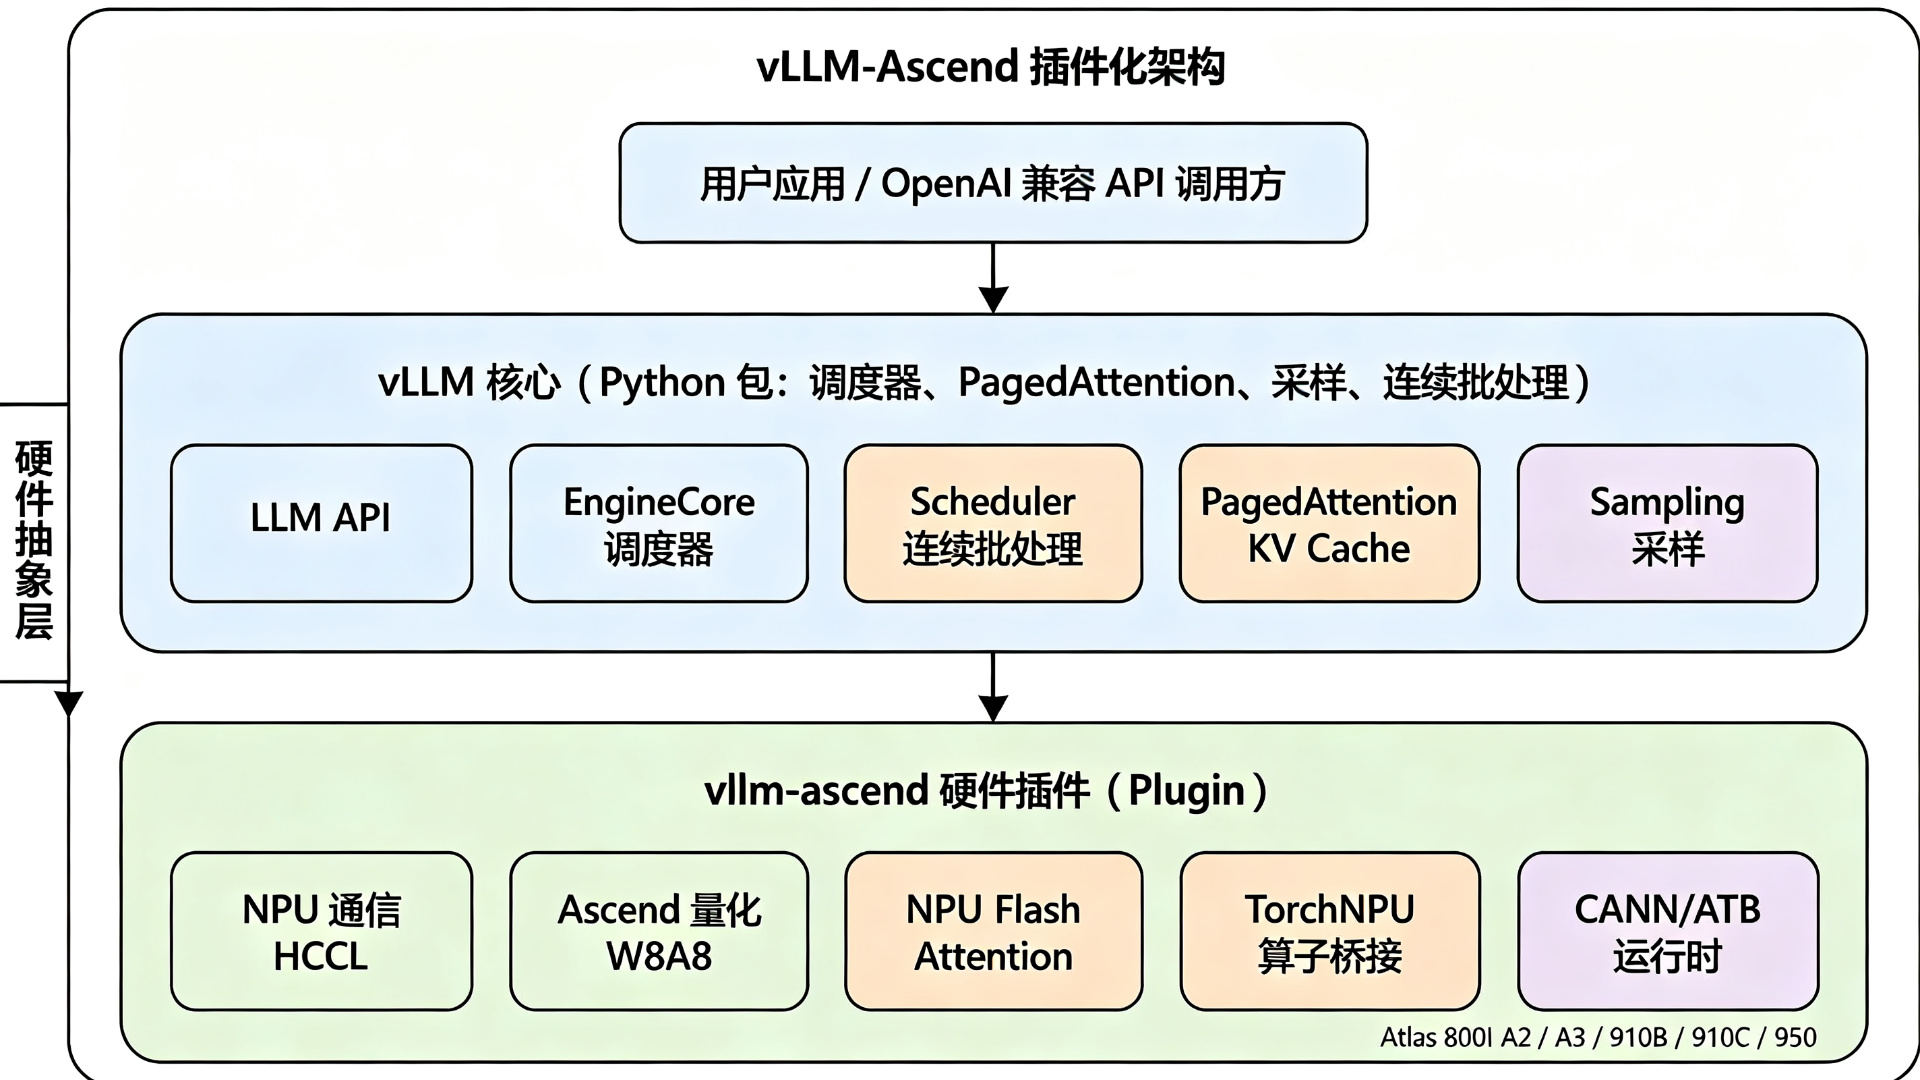
vLLM-Ascend 是 vLLM 官方仓库下的一个硬件后端插件(Hardware Platform Plugin),用于在华为昇腾 NPU 上执行大语言模型推理。
从工程结构上看,它不是 fork 一份 vLLM 再改,而是遵循 vLLM 自 v0.8 之后引入的"平台插件化"架构:
vllm主仓负责与硬件无关的部分:调度器(Scheduler)、连续批处理(Continuous Batching)、PagedAttention 抽象层、OpenAI 兼容 Server、采样器、模型定义;vllm-project/vllm-ascend这个独立仓库只负责"把 vLLM 抽象层的调用翻译到昇腾 CANN 运行时":HCCL 通信、NPU 融合算子、W8A8 量化 kernel、ATB(Ascend Transformer Boost)加速库接入;- 安装时两个包版本严格对齐,例如
vllm==0.23.0必须配vllm-ascend==0.23.0,否则会在 import 阶段就报plugin version mismatch。
截至本文写作时(2026 年 9 月),官方主分支依赖如下:
| 软件栈 | 版本 |
|---|---|
| Python | >= 3.10, < 3.13 |
| vLLM | 0.23.0 |
| vllm-ascend | 0.23.0 |
| PyTorch / torch_npu | 2.10.0 / 2.10.0.post4 |
| CANN(A2/A3/昇腾 950) | 9.0.1 |
| 支持硬件 | Atlas 800I A2(910B)、Atlas 800I A3(910C)、昇腾 950、Atlas 300I 推理卡(310P)等 |
2.2 大白话
你可以把 vLLM 理解成一家连锁餐饮管理公司:它负责设计菜单(模型 API)、排班(调度器)、客人排队规则(连续批处理),但具体炒菜的厨房它不自己开。
- 在 NVIDIA 数据中心,vLLM 用 CUDA 厨房;
- 在 AMD 数据中心,vLLM 用 ROCm 厨房;
- 在华为昇腾数据中心,vLLM 就用 vllm-ascend 这个厨房。
vLLM-Ascend 这家"厨房"用的锅铲不是 CUDA 那一套,而是华为自家的 CANN 算子库;它和主餐厅之间走的是 vLLM 定义好的标准接口(Platform 插件协议),所以菜单不用改、服务员不用换,厨师(插件)换了一版,前厅客户完全无感知。
2.3 生活案例
再打个比方。你家里原来用格力空调(CUDA),现在装修公司给你配了一台美的中央空调(昇腾 NPU)。
- 直接把格力遥控器按上,按不动——因为遥控器协议不一样;
- 美的原厂给你做了一个"万能适配器"(MindIE),能遥控,但只能用美的自己的 App,想接米家智能家居就不行;
- vLLM-Ascend 相当于给你做了一个标准红外转网关:所有支持红外遥控器的设备(OpenAI SDK、LangChain、vLLM 自带的
vllm serve命令)都能直接控这台美的中央空调,你不需要学新 App。
这就是为什么企业团队偏爱它:业务代码一行不用改,硬件换了引擎就能跑。
2.4 中国古代典故
《孙子兵法·地势篇》讲"故善战人之势,如转圆石于千仞之山者,势也"。vLLM-Ascend 的"势",在于它站在了两股洪流的交汇处:一股是 vLLM 开源社区在 CUDA 侧已经打磨到极致的推理调度思想,另一股是昇腾硬件在国产化政策下的规模化出货。它不是从零造轮子,而是把已经滚圆的石头(vLLM 调度器)搬到了千仞之山(昇腾 NPU 算力)上,两者结合,势能自然就出来了。
三、为什么用:vLLM-Ascend 的五个不可替代价值
很多人第一次接触会问:"既然有华为官方的 MindIE,为什么还要折腾 vLLM-Ascend?"这里把五个核心价值讲清楚。
第一,生态对齐,迁移成本趋近于零。 你在 A100 上写的 from vllm import LLM, SamplingParams,搬到 910B 上不用改一行 Python 代码;你已经封装好的 OpenAI 兼容网关、LangChain 调用链、监控面板全部沿用。这在国产化迁移项目里是巨大的成本节省。
第二,调度思想先进,吞吐不是一个量级。 原生 Transformers 是"一个请求从头跑到尾",vLLM 是"连续批处理 + PagedAttention 分页 KV Cache"。PagedAttention 把 KV Cache 像操作系统分页一样切成固定块,按需分配,显存碎片率从 60% 以上压到 4% 以内,单卡可并发的请求数直接翻 5 到 10 倍。
第三,迭代速度快,新特性第一时间可用。 只要 vLLM 主仓合入了某个新特性(比如 prefix caching、投机解码、DeepSeek MTP、DeepSeek V3 多 token 预测),vllm-ascend 通常在 1 到 2 个版本内就会把 NPU 后端补上。MindIE 受限于商业发布节奏,特性往往晚半年到一年。
第四,开源透明,二次开发无黑盒。 整个仓库在 GitHub 上以 Apache 2.0 协议开源,企业可以提 issue、提 PR、甚至自己 fork 改算子。金融、政务这种对供应链可控性要求极高的行业,这一点是硬门槛。
第五,硬件覆盖广。 从边缘的 Atlas 200I A2,到中心的 Atlas 800I A2/A3,再到最新的昇腾 950 超节点,vllm-ascend 都有对应的镜像和模型支持列表。一套代码,从机房到边缘盒子都能部署。
四、演进历史:从社区野路子到官方一等公民
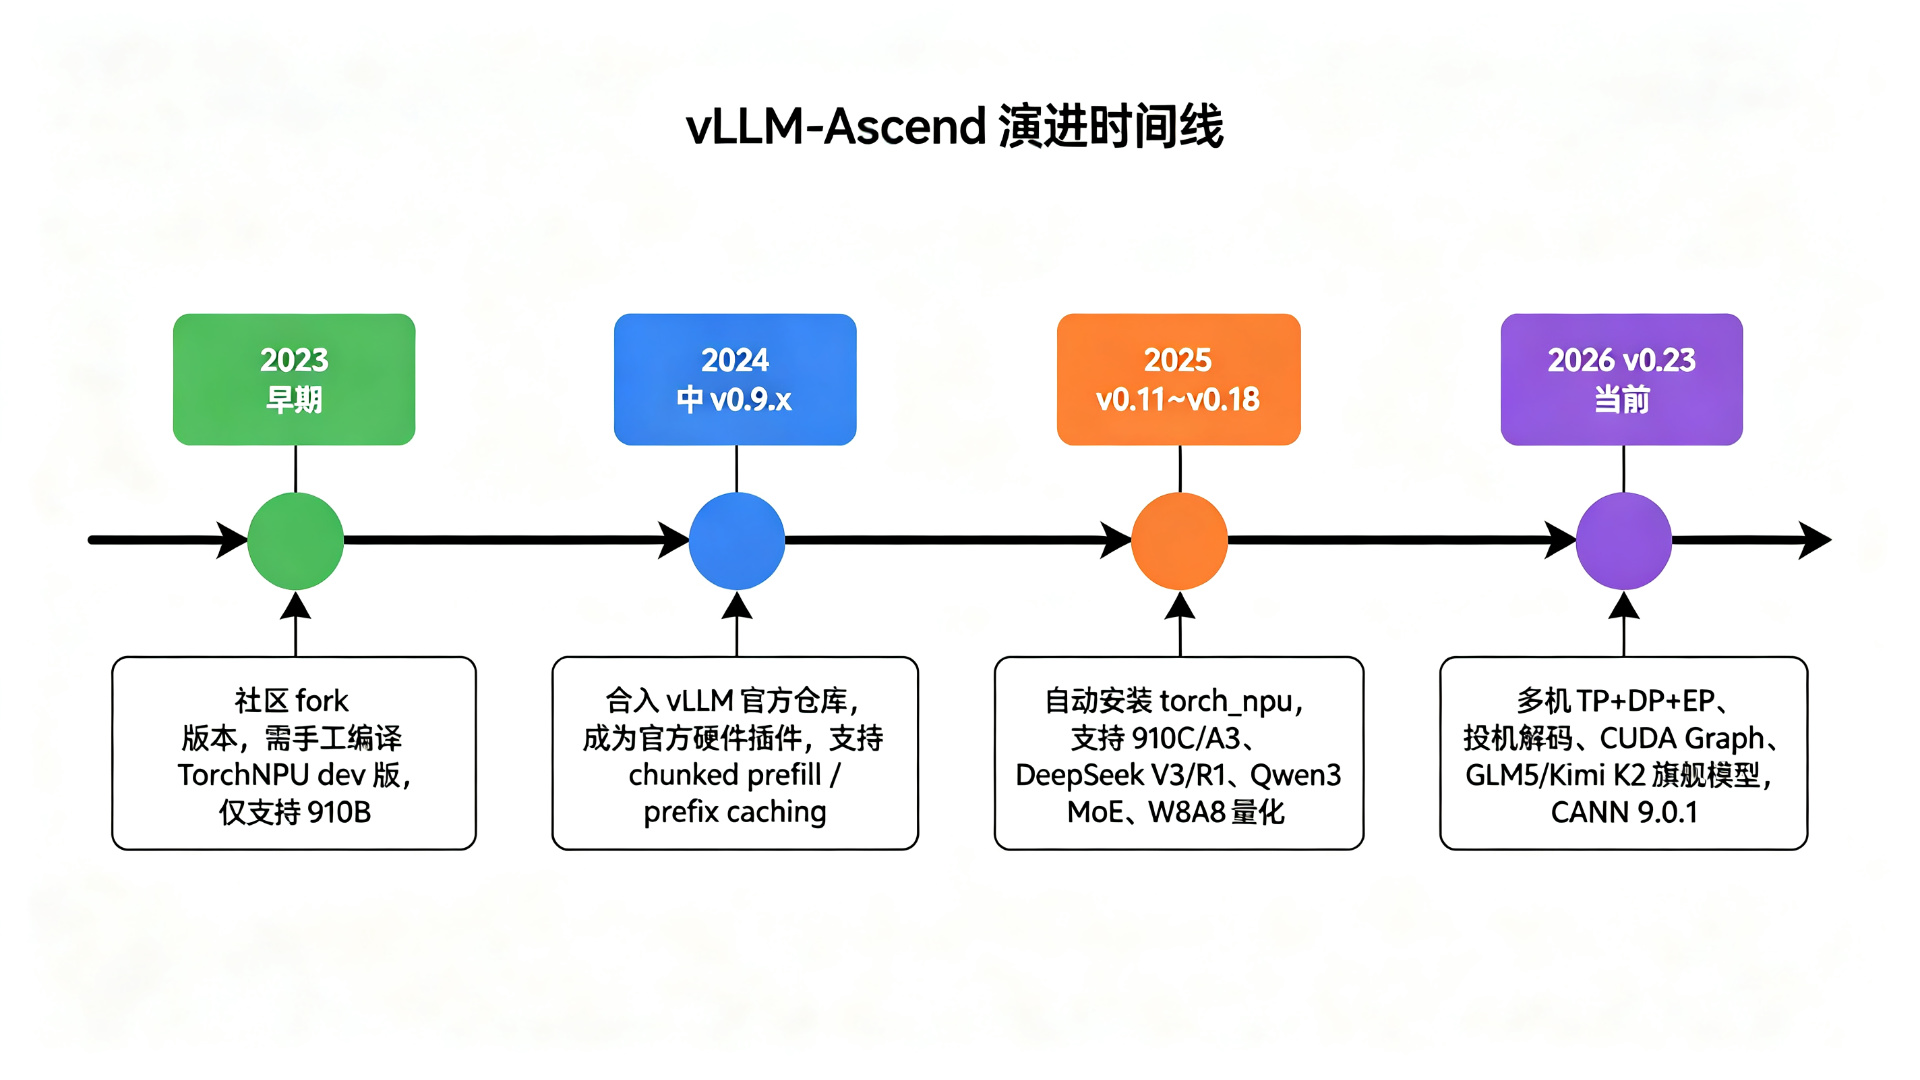
理解它为什么长今天这个样子,要看清楚三个关键节点。
2023 年:社区 fork 阶段。 最早一批昇腾跑 vLLM 的代码,是华为外包工程师和社区开发者在 vLLM 主仓外面 fork 出来的分支,需要手工编译 TorchNPU 的开发版(dev 分支),CANN 版本要自己对,编译一次两小时,文档基本靠口口相传。这个阶段能跑起来的都是"重装系统十遍"的资深玩家。
2024 年中:v0.9.x,正式合入官方。 这一年 vLLM 主仓引入了 Hardware Platform Plugin 机制,vllm-ascend 作为官方一级插件进入 vllm-project 组织。关键变化是:
- 提供了 PyPI 上的
vllm-ascend包,pip install就能装,不再需要手工编译; - 配套发布了 Docker 镜像
quay.io/ascend/vllm-ascend,环境一把齐; - 引入了 chunked prefill 和 automatic prefix caching,TTFT 和 TPOT 同时改善;
- 不再依赖 TorchNPU 开发版,自动安装稳定版 2.5.1。
2025 到 2026 年:v0.11 到 v0.23,企业化阶段。 这一阶段的主题是"把旗舰大模型搬上来":
- 支持 910C / Atlas 800I A3,配合 CANN 8.2 之后的融合算子;
- 完整支持 DeepSeek V3/R1、Qwen3 系列 MoE、GLM-5、Kimi K2 等万亿/千亿模型的 W8A8 量化部署;
- 引入多机张量并行(TP)+ 数据并行(DP)+ 专家并行(EP)混合拓扑;
- 引入 Suffix Speculative Decoding(Qwen3-32B 吞吐再提升 20%~80%)、Zero Bubble 异步调度、DFlash Attention 后端;
- 当前 v0.23.0 配合 CANN 9.0.1、torch 2.10.0,已经是企业生产级版本。
一句话总结演进逻辑:从"能跑"到"好用",从"单机玩具"到"多机集群生产"。
五、怎么用:从零到企业生产的完整代码
这一章是全文最硬核的部分,所有命令和脚本都基于官方 v0.23.0 文档实测整理。
5.1 环境准备:先把地基打好
vLLM-Ascend 对软件版本极其敏感,第一步永远是核对版本矩阵。在动手装之前,先执行:
# 查看 NPU 驱动和固件版本
npu-smi info

# 查看当前 CANN 版本
cat /usr/local/Ascend/ascend-toolkit/latest/version.cfg
确认硬件型号。常见对应关系:
| 机型 | SOC_VERSION 取值 |
|---|---|
| Atlas 800I A2(910B1) | ascend910b1 |
| Atlas 800I A2(910B4) | ascend910b4 |
| Atlas 800I A3(910C) | ascend910_93 |
| Atlas 300I Pro(310P) | ascend310p |
5.2 方式一:pip 直装(开发机首选)
# 1. 准备虚拟环境
python -m venv vllm-ascend-env
source vllm-ascend-env/bin/activate

# 2. 升级 pip
python -m pip install --upgrade pip

# 3. 安装与 vllm-ascend 严格对齐的 vllm 版本
pip install vllm==0.23.0

# 4. 安装 vllm-ascend 插件(走华为云镜像,国内速度快)
pip install \
  --extra-index-url https://mirrors.huaweicloud.com/ascend/repos/pypi/variant \
  vllm-ascend==0.23.0

# 5. 加载 CANN 环境变量(建议写入 ~/.bashrc)
source /usr/local/Ascend/ascend-toolkit/set_env.sh
source /usr/local/Ascend/nnal/atb/set_env.sh

# 6. 验证安装
python -c "import vllm; import vllm_ascend; print(vllm.__version__, vllm_ascend.__version__)"
如果第 6 步打印出 0.23.0 0.23.0,说明插件加载成功。如果报 libatb.so: cannot open shared object file,说明 NNAL(Ascend Transformer Boost)没有 source,回到第 5 步。
5.3 方式二:Docker 镜像(生产环境推荐)
生产环境强烈推荐用官方镜像,避免宿主机 CANN 与容器内版本错位:
# 拉取官方镜像
docker pull quay.io/ascend/vllm-ascend:v0.23.0-950dt

# 启动容器,挂载 NPU 设备与驱动
docker run --rm \
  --name vllm-ascend \
  --shm-size=1g \
  --device /dev/davinci0 \
  --device /dev/davinci_manager \
  --device /dev/devmm_svm \
  --device /dev/hisi_hdc \
  -v /usr/local/dcmi:/usr/local/dcmi \
  -v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \
  -v /usr/local/Ascend/driver/lib64/:/usr/local/Ascend/driver/lib64/ \
  -v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \
  -v /etc/ascend_install.info:/etc/ascend_install.info \
  -v /root/.cache:/root/.cache \
  -p 8000:8000 \
  -it quay.io/ascend/vllm-ascend:v0.23.0-950dt
要点解释:
--shm-size=1g:NCCL/HCCL 通信需要共享内存,不设会在多卡时 hang 住;- 三个
/dev/davinci*设备必须挂,否则容器内看不到 NPU; - 驱动 lib64、version.info、install.info 必须挂载,这是让容器内 CANN 感知宿主机驱动版本的标准做法。
5.4 第一次推理:离线 Python 脚本
from vllm import LLM, SamplingParams

# 准备 prompts
prompts = [
    "请用一句话解释什么是 PagedAttention:",
    "请用大白话介绍 vLLM-Ascend:",
]

# 采样参数
sampling_params = SamplingParams(
    temperature=0.7,
    top_p=0.9,
    max_tokens=512,
)

# 加载模型。首次运行会自动从 HuggingFace/ModelScope 下载权重
# 单机单卡用 0.6B 小模型先跑通;生产换 Qwen3-235B-A22B 即可
llm = LLM(
    model="Qwen/Qwen3-0.6B",
    tensor_parallel_size=1,
    dtype="float16",
    gpu_memory_utilization=0.9,
)

# 批量推理
outputs = llm.generate(prompts, sampling_params)

for output in outputs:
    print(f"Prompt: {output.prompt!r}")
    print(f"Generated: {output.outputs[0].text!r}")
    print("-" * 60)
注意:如果服务器在国内访问 HuggingFace 慢,可以在启动前设置:
export HF_ENDPOINT=https://hf-mirror.com
或者直接从 ModelScope 下载模型到本地路径,再把 model= 换成本地目录。
5.5 启动 OpenAI 兼容服务(生产主力)
离线脚本适合批处理任务,在线业务几乎都是用 vllm serve 起 HTTP 服务,它原生兼容 OpenAI SDK。
单机 8 卡部署 Qwen3-235B-A22B W8A8 量化版本的生产级启动脚本:
vllm serve /models/Qwen3-235B-A22B-W8A8 \
  --host 0.0.0.0 \
  --port 8000 \
  --served-model-name qwen3_235b \
  --tensor-parallel-size 8 \
  --quantization ascend \
  --max-model-len 40960 \
  --max-num-batched-tokens 16384 \
  --max-num-seqs 24 \
  --gpu-memory-utilization 0.9 \
  --trust-remote-code \
  --enable-chunked-prefill \
  --enable-prefix-caching \
  --compilation-config '{"cudagraph_mode": "FULL_DECODE_ONLY"}' \
  --seed 1024
参数逐项解释:
| 参数 | 作用 |
|---|---|
--tensor-parallel-size 8 | 8 张 NPU 做张量并行,把单层权重切到 8 张卡上 |
--quantization ascend | 启用昇腾 W8A8 量化,权重和激活都用 INT8,显存降一半 |
--max-model-len 40960 | 最大上下文长度 4 万 token,按业务裁剪 |
--max-num-batched-tokens 16384 | 单次 prefill 最大 token 数,配合 chunked prefill 防 TTFT 毛刺 |
--max-num-seqs 24 | 最大并发序列数,按显存和延迟 SLO 调 |
--gpu-memory-utilization 0.9 | 预留 10% 显存给碎片和临时张量 |
--enable-chunked-prefill | 把长 prefill 切小块,避免单个长请求堵住整个 batch |
--enable-prefix-caching | 相同系统提示词复用 KV Cache,RAG 场景命中率极高 |
--cudagraph_mode FULL_DECODE_ONLY | 只对 decode 阶段做图编译,首 token 不走图,平衡 TTFT 和 TPOT |
5.6 业务方调用:OpenAI SDK 直连
from openai import OpenAI

client = OpenAI(
    base_url="http://10.0.0.11:8000/v1",
    api_key="EMPTY",  # vLLM 默认不校验
)

response = client.chat.completions.create(
    model="qwen3_235b",
    messages=[
        {"role": "system", "content": "你是一名严谨的金融风控分析师。"},
        {"role": "user", "content": "请简述等额本息与先息后本的差异。"},
    ],
    temperature=0.3,
    top_p=0.9,
    max_tokens=1024,
    extra_body={"repetition_penalty": 1.05},
)

print(response.choices[0].message.content)
整个过程对业务方来说,和调用 OpenAI 官方 API 没有任何区别。这就是 vLLM 生态最大的红利。
5.7 多机部署:两台 Atlas 800I A3 跑 DeepSeek-R1
当模型大到单机装不下(比如 DeepSeek-R1 671B MoE),就要上多机。vllm-ascend 支持 TP + DP 混合并行:
# 假设 node0_ip = 10.0.0.11, node1_ip = 10.0.0.12
# 两台机器都执行,只是 data-parallel-start-rank 不同

# ---- Node 0 ----
vllm serve /models/DeepSeek-R1-W8A8 \
  --headless \
  --host 0.0.0.0 --port 8000 \
  --served-model-name deepseek-r1 \
  --tensor-parallel-size 8 \
  --data-parallel-size 2 \
  --data-parallel-size-local 1 \
  --data-parallel-start-rank 0 \
  --data-parallel-address 10.0.0.11 \
  --data-parallel-rpc-port 13389 \
  --quantization ascend \
  --enable-expert-parallel \
  --max-num-seqs 16 \
  --gpu-memory-utilization 0.9 \
  --trust-remote-code
# ---- Node 1 ----
vllm serve /models/DeepSeek-R1-W8A8 \
  --headless \
  --host 0.0.0.0 --port 8000 \
  --served-model-name deepseek-r1 \
  --tensor-parallel-size 8 \
  --data-parallel-size 2 \
  --data-parallel-size-local 1 \
  --data-parallel-start-rank 1 \
  --data-parallel-address 10.0.0.11 \
  --data-parallel-rpc-port 13389 \
  --quantization ascend \
  --enable-expert-parallel \
  --max-num-seqs 16 \
  --gpu-memory-utilization 0.9 \
  --trust-remote-code
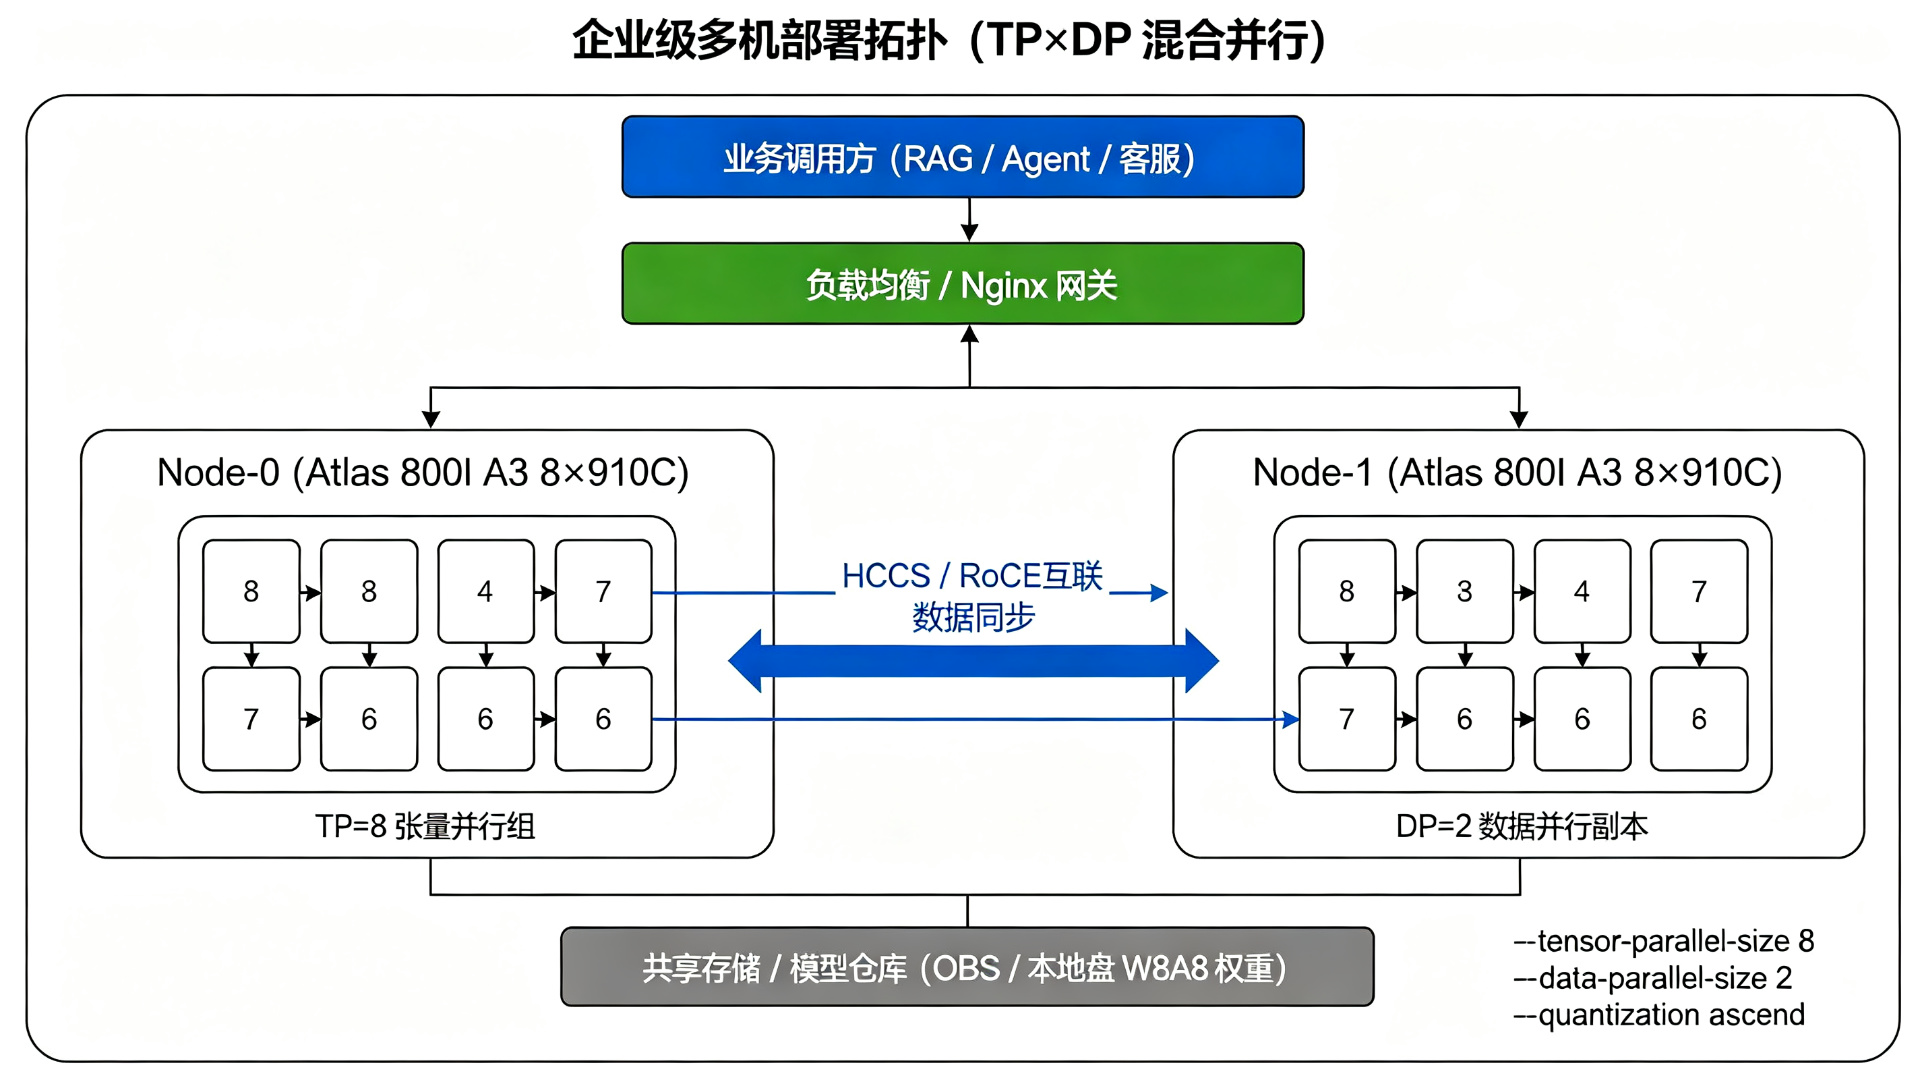
两个关键点:
--data-parallel-address必须填 node0 的 IP,它会作为 RPC 协调节点;- 两台机器之间需要 RoCE 或 HCCS 高速互联,带宽不够会在 TP 反向同步时成为瓶颈。
5.8 性能压测:官方 benchmark 工具
服务起来后,用 vLLM 自带的 benchmark 验证吞吐和延迟:
# 离线吞吐压测
python -m vllm.entrypoints.openai.api_server \
  --model /models/Qwen3-235B-A22B-W8A8 --port 8000 &

# 使用 benchmark_serving 脚本
wget https://raw.githubusercontent.com/vllm-project/vllm/main/benchmarks/benchmark_serving.py

python benchmark_serving.py \
  --backend openai-chat \
  --base-url http://127.0.0.1:8000/v1 \
  --model qwen3_235b \
  --dataset-name random \
  --random-input-len 2048 \
  --random-output-len 512 \
  --max-concurrency 128 \
  --num-prompts 1000
重点看四个指标:
- TTFT(Time To First Token):首 token 延迟,业务体感;
- TPOT(Time Per Output Token):每 token 间隔,流式输出顺滑度;
- Throughput:每秒输出 token 数,决定成本;
- 并发能力:多少并发下 P99 延迟仍在 SLO 内。
5.9 常见踩坑与排查清单
实战中最常踩的四个坑,按出现频率排序:
坑 1:版本对不上,import 就崩。 症状是 ImportError: cannot import name ... from vllm 或 plugin version mismatch。解法:严格按官方版本表对齐 vllm、vllm-ascend、torch、torch_npu、CANN 五件套。不要自作主张升 vllm 不升 vllm-ascend。
坑 2:找不到 libatb.so。 解法:source /usr/local/Ascend/nnal/atb/set_env.sh,并确认 NNAL 包已经安装。
坑 3:ACL 图尺寸超限,启动失败。 症状是日志里看到 ACL graph size exceeded。解法:要么升级到 CANN 8.5.0 以上(修复了 stream-budget),要么手动减小 cudagraph capture 范围:--compilation-config '{"cudagraph_mode": "FULL_DECODE_ONLY"}'。
坑 4:多卡启动 hang 死。 90% 是 --shm-size 没给够,或者 HCCL 通信端口被防火墙拦了。解法:容器加 --shm-size=8g,并确保两台机器之间 13389 等 RPC 端口可通。
六、竞品对比:vLLM-Ascend 到底站在哪一档
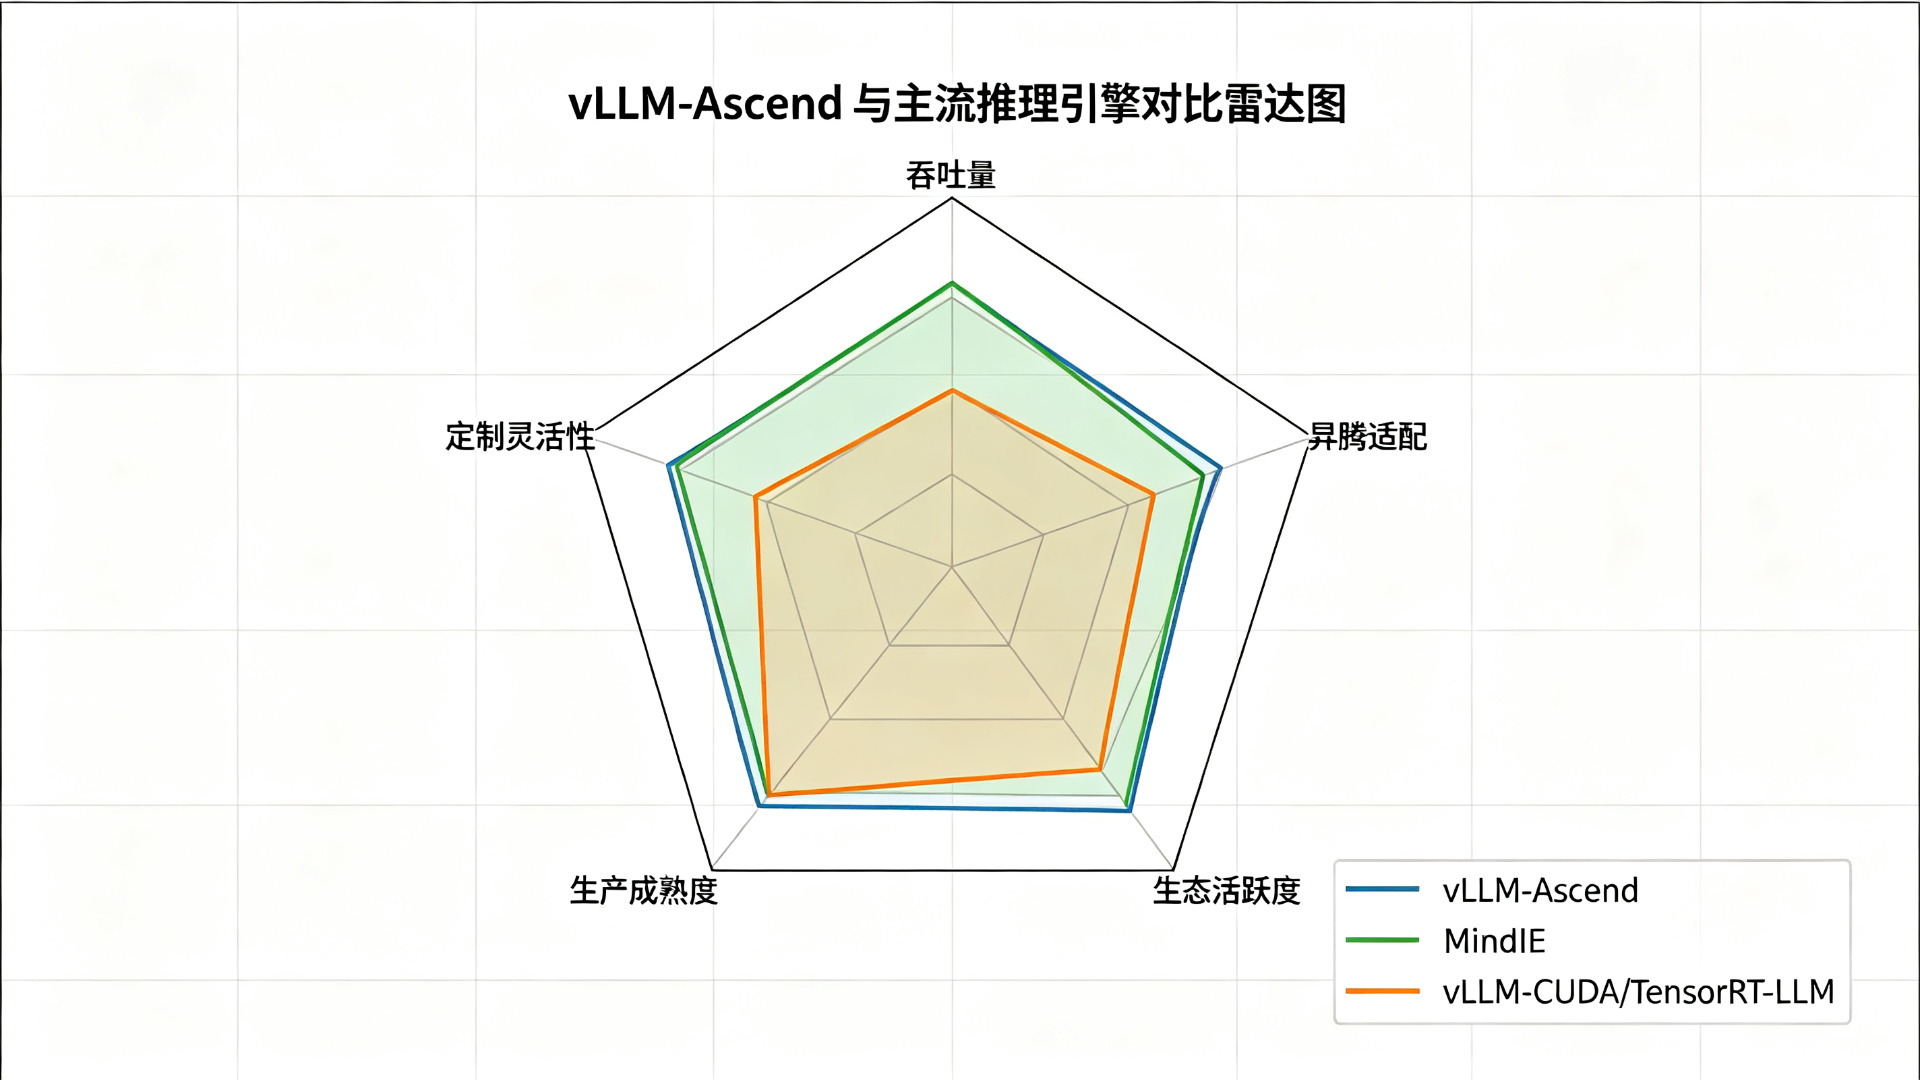
把当前主流推理引擎放在一张表里横向对比,更能看清 vLLM-Ascend 的位置。
| 维度 | vLLM-Ascend | MindIE | HuggingFace TGI | LMDeploy | TensorRT-LLM | SGLang |
|---|---|---|---|---|---|---|
| 开发主体 | vLLM 社区 + 昇腾团队 | 华为昇腾官方 | HuggingFace | 阿里巴巴 | NVIDIA | LMSYS / UC Berkeley |
| 昇腾原生支持 | 是,官方一级插件 | 是,华为亲儿子 | 弱,社区维护 | 有适配,滞后 | 不支持 | 弱,社区适配 |
| NVIDIA 支持 | 是(通过 vllm-cuda 分支) | 不支持 | 是 | 是 | 是,最佳 | 是 |
| 开源协议 | Apache 2.0 完全开源 | 商业 + 开源混合 | 开源 | 开源 | 部分开源 | 开源 |
| 核心杀手锏 | 生态最全、插件化、迭代最快 | 端云协同、MoE 极致优化、低功耗 | HF 生态无缝 | Qwen 官方主力、MoE 强、W4A16 成熟 | NVIDIA 硬件极致低延迟 | RadixAttention 前缀复用、结构化输出快 |
| 模型覆盖 | Qwen / DeepSeek / GLM / Kimi 全系列 | 华为认证模型清单 | 主流开源模型 | Qwen 系列最深 | NVIDIA 认证模型 | 主流开源模型 |
| 多机并行 | TP + DP + EP 完整 | 完整 | 仅 TP | TP + DP | TP + PP | TP + DP + EP |
| 二次开发 | 开源透明,PR 友好 | 闭源部分多,定制难 | 开源 | 开源 | 闭源 kernel 多 | 开源 |
| 典型适用场景 | 国产化数据中心、需要生态灵活性 | 华为一体机/边缘盒子、私有化交付 | HF 全家桶用户、欧洲主权云 | 阿里云 Qwen 服务 | 纯 NVIDIA 推理 | 高并发 Agent 服务 |
| 短板 | 版本对齐严格,新手易踩坑 | 绑定华为栈,新特性慢 | 昇腾性能未充分优化 | 昇腾侧跟进慢 | 不能用在昇腾 | 昇腾生态晚 |
一句话选型建议:
- 公司已经买了昇腾服务器,团队有 Python 基础,要快速接 RAG/Agent 业务 → 选 vLLM-Ascend;
- 交付的是华为一体机,客户要求"全栈华为认证" → 选 MindIE;
- 业务主要跑在 NVIDIA 上 → 直接 vLLM-CUDA 或 TensorRT-LLM;
- 用 Qwen 全系列且追求 MoE 极致吞吐 → 评估 LMDeploy 作为对照。
七、常用场景:企业项目里 vLLM-Ascend 都在干什么
结合笔者参与过的几个项目,梳理四个最高频的落地场景。
场景 1:企业内部知识库 RAG 服务
典型架构是"向量数据库 + 重排模型 + vllm-ascend 生成模型"。业务请求先经过检索,把召回的切片拼到 prompt 里,再交给 vLLM 生成。
这个场景下三个参数一定要打开:
--enable-prefix-caching \
--enable-chunked-prefill \
--max-num-batched-tokens 8192
因为系统提示词和检索到的文档前缀在多个用户间高度重复,prefix caching 命中率通常能到 40% 以上,TTFT 直接砍半。
场景 2:智能客服 / 工单自动回复
客服场景对并发要求高,但单条输出不长(一般 200~500 token)。推荐配置:
--max-num-seqs 128 \
--max-num-batched-tokens 4096 \
--gpu-memory-utilization 0.92
把并发拉满,利用连续批处理让 8 张 910B 同时服务上百路会话。
场景 3:长文档摘要 / 代码补全
长上下文场景,要特别注意 prefill 阶段的显存峰值:
--max-model-len 131072 \
--enable-chunked-prefill \
--max-num-batched-tokens 8192
chunked prefill 把超长 prompt 切成 8k 一块喂进去,避免一次性把所有注意力矩阵算出来导致 OOM。
场景 4:多模型路由网关
一个机房同时跑 Qwen3、DeepSeek、GLM 多个模型,用 vLLM 多服务实例 + Nginx 按 model 字段路由。OpenAI 兼容协议在这里的价值被放大:业务侧只看一个网关地址,后端换模型、扩容、灰度都对业务透明。
八、面试官高频面试题(附参考答案要点)
以下题目是笔者和同行在 AI 基础设施岗位真实面试中遇到的,按出现频率排序。
Q1:vLLM-Ascend 和原生 vLLM 是什么关系?为什么要做成插件?
要点:vLLM-Ascend 是 vLLM 官方的硬件后端插件,通过 vLLM 的 Platform 抽象层接入。插件化的好处是主仓可以保持硬件无关,CUDA/ROCm/Ascend 各维护各的仓库,互不干扰,迭代解耦。
Q2:PagedAttention 的原理是什么?为什么能省显存?
要点:传统做法为每个请求预分配一块连续 KV Cache 显存,导致大量内部碎片。PagedAttention 借鉴操作系统虚拟内存分页,把 KV Cache 切成固定大小的 block(比如 16 token 一块),逻辑上连续、物理上不连续,通过 block table 映射,碎片率从 60%+ 降到 4% 以内,显存利用率从 40% 提到 90% 以上。
Q3:W8A8 量化在昇腾上为什么必须用 --quantization ascend?
要点:W8A8 是权重 8bit、激活 8bit 的量化方案。普通 FP16 模型直接跑会浪费昇腾 910 系列的 INT8 张量算力。ascend 量化后端会调用华为定制的融合 kernel(包括反量化、矩阵乘、激活融合),吞吐通常比 FP16 高 1.5 到 2 倍,显存占用降一半。
Q4:张量并行(TP)、数据并行(DP)、专家并行(EP)有什么区别?
要点:
- TP:把单层权重矩阵切到多张卡上,每张卡算一部分,每步都要 all-reduce,通信密集,适合单模型太大装不下;
- DP:每张卡跑一份完整模型副本,请求分发到不同副本,副本之间不通信,靠负载均衡,适合扩容并发;
- EP:MoE 模型专属,把不同专家放到不同卡上,token 路由到对应专家,适合 DeepSeek/Qwen-MoE 这类稀疏模型。
Q5:chunked prefill 解决什么问题?
要点:不开启时,一个长 prompt 的 prefill 会一次性占住整个 batch 直到算完,后面短请求的 decode 被堵住,TTFT 毛刺严重。chunked prefill 把长 prompt 切成固定大小的 chunk,和 decode 请求混在一个 batch 里调度,长短请求公平排队,P99 TTFT 明显下降。
Q6:prefix caching 是怎么工作的?
要点:vLLM 会把相同前缀(比如系统提示词、相同的 few-shot 示例)的 KV Cache 按哈希索引缓存下来,新请求来了先查前缀匹配,命中的部分直接复用,不用重新 prefill。RAG 场景下系统提示词重复率高,收益最大。
Q7:服务启动 OOM 了,你怎么排查?
要点:先 npu-smi info 看真实显存占用;再用 --gpu-memory-utilization 0.85 降低预留;检查 --max-model-len 和 --max-num-seqs 是否过大;开启 W8A8 量化;如果是多机,确认 TP 切分是否正确。不要一上来就加卡,先把参数收敛。
Q8:怎么选 vLLM-Ascend 还是 MindIE?
要点:看三个维度——生态灵活性(vLLM 胜)、端侧/边缘盒子(MindIE 胜)、是否要求华为全栈认证(MindIE 胜)。数据中心级、要接开源社区生态、团队要二次开发,选 vLLM-Ascend;交付一体机、客户要求华为原厂认证、场景在边缘盒子,选 MindIE。
Q9:首 token 延迟(TTFT)和每 token 延迟(TPOT)怎么分别优化?
要点:TTFT 主要由 prefill 决定,优化手段是 chunked prefill、prefix caching、更大的 max-num-batched-tokens、把 prefill 放独立实例;TPOT 主要由 decode 阶段决定,优化手段是 CUDA Graph capture、投机解码、提升 batch 并发摊薄单请求成本。
Q10:vLLM-Ascend 的版本为什么对齐这么严格?
要点:因为插件需要直接调用 vLLM 主仓内部的 Python 类和 C++ 调度接口,这些接口在小版本间会变。vllm-ascend 每个版本都是针对某个 vllm 版本"编译验证"过的,跨版本混用会出现 ABI 不兼容。生产环境固定版本号,不要 pip install -U vllm。
九、写在最后
vLLM-Ascend 这两年的发展速度,超出了很多人的预期。它本质上是开源社区力量和国产硬件生态两股浪潮汇合的产物:一边是 vLLM 在 CUDA 上把推理调度这件事做到了极致,另一边是昇腾在政策和供应链双重驱动下快速规模化。对一线工程师来说,这意味着一件事——熟悉一套 vLLM API,你就能同时在 NVIDIA 和昇腾两种硬件上交付生产级服务,这种跨平台的工程能力,在未来三到五年的国产化浪潮里会非常值钱。
建议动手路径:
- 先在一台带单张 910B 的开发机上跑通 0.6B 小模型,把 pip 安装和 Python 推理跑通;
- 再用
vllm serve起一个 Qwen3-7B 服务,用 curl 和 OpenAI SDK 各调一次; - 最后在 8 卡机器上试 W8A8 量化 + chunked prefill + prefix caching 三件套,跑一次 benchmark 记录数据;
- 把这些数据沉淀成团队内部的部署 SOP,你就成了团队里"那个把昇腾跑明白的人"。
转载声明
本文为原创文章,如需转载,请联系作者获得授权,并注明出处。

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)