
具身智能工业视觉识别 + 华为云物联监护:从摄像头到 CodeArts 部署全流程实战
实训报告--具身智能工业视觉分析与物联监护应用演练
拟制__________________________________________________________
1 工效组合展示
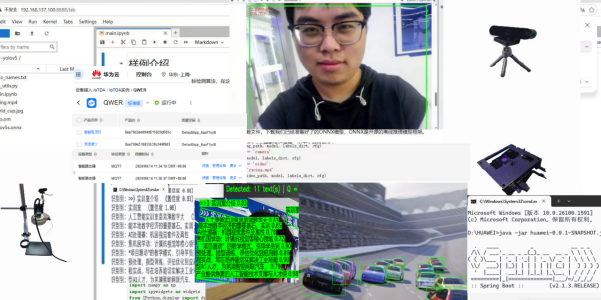
2 具身智能工业视觉获取与分析应用
2.1 工具软件安装
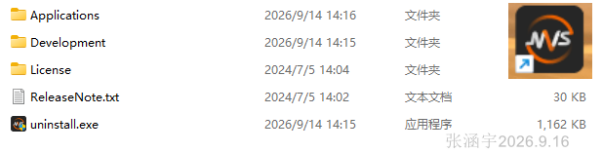
该软件(MVS 客户端)是面向工业机器视觉的相机管理与图像采集调试平台,支持多类型工业相机的发现连接、实时采集预览、参数配置、固件与网络管理,并提供 SDK 便于二次开发,是工业检测、测量与定位等视觉应用的基础工具。
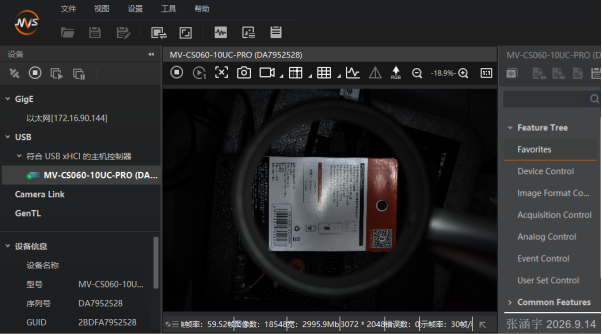
2.2 工业视觉环境构建与应用
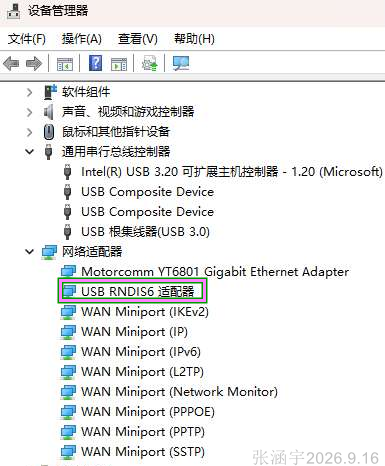
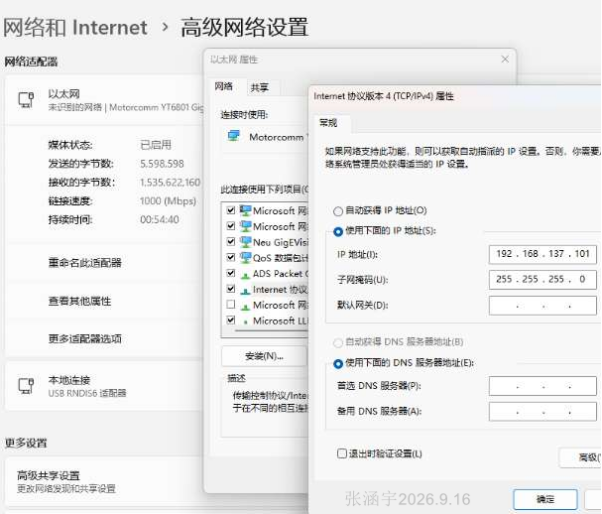
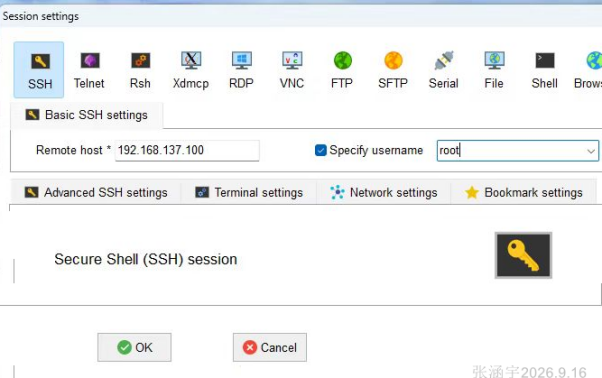
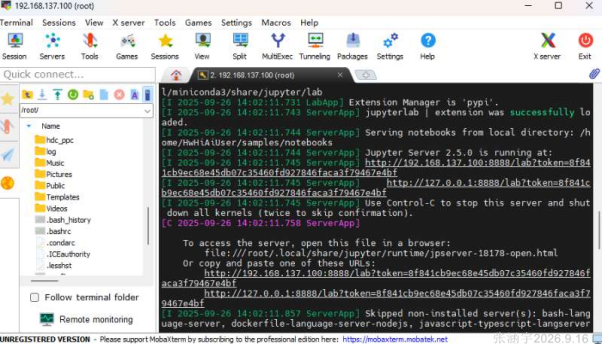
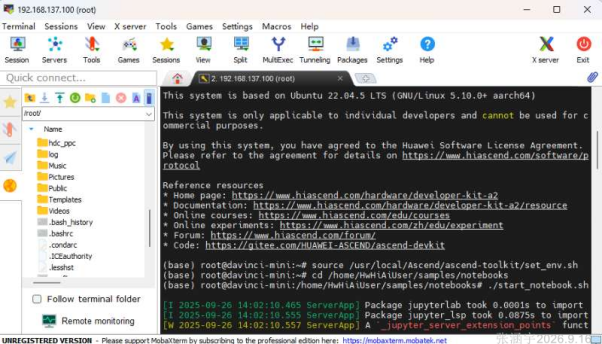
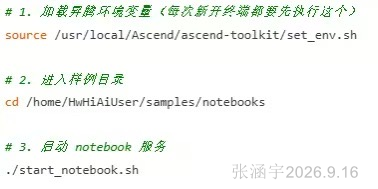
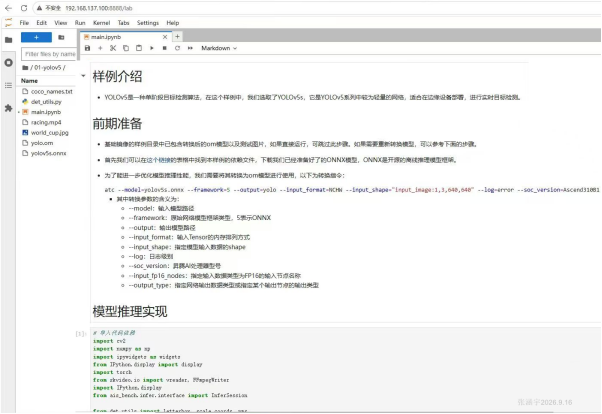
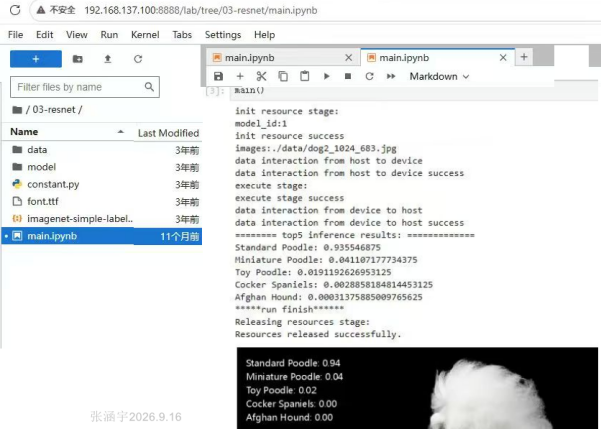
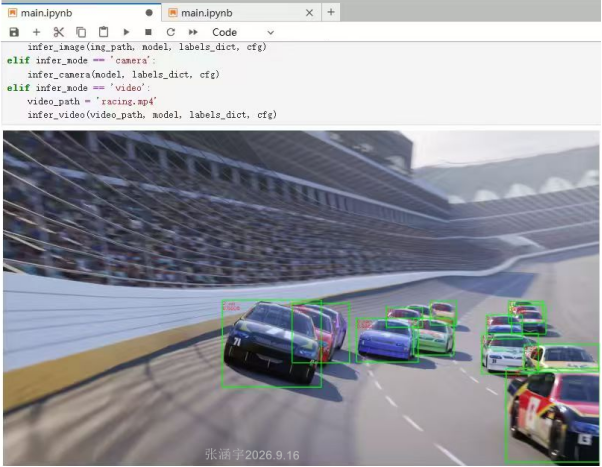
2.3 昇腾工业视觉终端应用展现
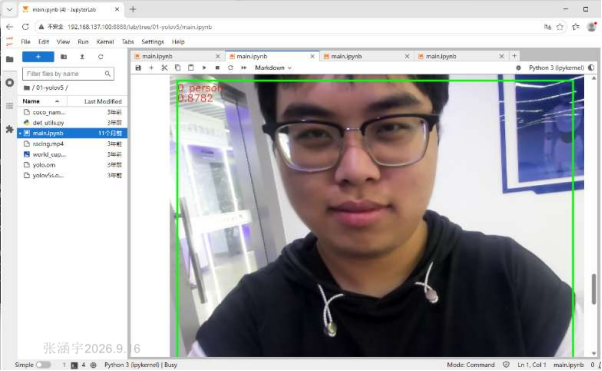
3 具身智能工业视觉识别快速编码实现
3.1 IMA-DS借力
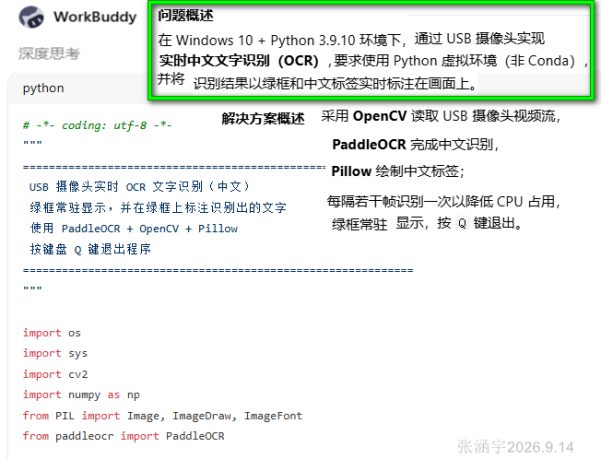
3.2 运行环境构造
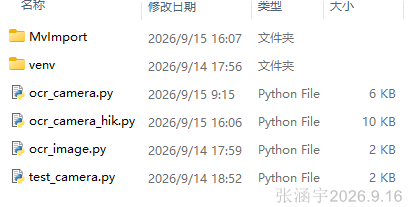
1.python -m venv venv
2.venv\Scripts\activate
3.python -m pip install --upgrade pip -i https://pypi.tuna.tsinghua.edu.cn/simple
1.创建虚拟环境(非 Conda,用 Python 自带的 venv)
2.激活虚拟环境
3.升级 pip(原版本 21.2.4 过旧)
3.3 编码实现
3.3.1 test_camera.py —— 摄像头“体检工具”
核心逻辑:用 OpenCV 打开摄像头(编号 0),把每一帧画面显示在窗口里,你按 Q 就退出。
# -*- coding: utf-8 -*-"""============================================================ 测试 USB 摄像头能否正常显示画面 按键盘 Q 键退出============================================================"""
import cv2
CAMERA_INDEX = 0

def open_camera(index):    """打开摄像头,自动尝试两种方式,提高成功率"""
    cap = cv2.VideoCapture(index, cv2.CAP_DSHOW)
    if cap.isOpened():
        return cap
    cap.release()

    cap = cv2.VideoCapture(index)
    return cap

def main():
    print(f"正在打开 USB 摄像头(编号 {CAMERA_INDEX})...")
    cap = open_camera(CAMERA_INDEX)

    if not cap.isOpened():
        print("\n[错误] 打开摄像头失败!请检查:")
        print("  1. 摄像头的 USB 线是否插好")
        print("  2. 如果插了多个摄像头,把上面 CAMERA_INDEX 从 0 改成 1 再试")
        print("  3. 摄像头是否被其他软件(如微信视频、QQ)占用")
        return

    print("打开成功!正在显示画面,按 Q 键退出。")

    while True:
        ret, frame = cap.read()
        if not ret:
            print("[提示] 读取画面失败")
            break

        cv2.imshow("Camera Test (按 Q 退出)", frame)

        if cv2.waitKey(1) & 0xFF == ord('q'):
            break

    cap.release()
    cv2.destroyAllWindows()
    print("已退出。")

if __name__ == "__main__":
    main()
3.3.2 ocr_image.py —— 图片识别“练手工具”
核心逻辑:加载 PaddleOCR 中文模型,读取 test.png 这张图,把识别到的文字和置信度打印出来。
if __name__ == "__main__":
main()
# -*- coding: utf-8 -*-"""============================================================ 对本地图片进行 OCR 文字识别(中文) 适合先拿一张带文字的图片,验证 OCR 环境是否装好============================================================"""
import sysfrom paddleocr import PaddleOCR
# 解决 Windows 控制台中文乱码问题if sys.platform == "win32":
    try:
        sys.stdout.reconfigure(encoding="utf-8")
    except Exception:
        pass
# ==================== 改成你的图片路径 ====================# 把一张带中文文字的图片放到本文件同一文件夹,# 然后把下面的文件名改成它,例如 "photo.jpg" 或 "test.png"
IMG_PATH = "test.png"# ========================================================

def main():
    print("正在加载 OCR 模型(首次运行会自动下载模型,请耐心等待)...")
    ocr = PaddleOCR(use_angle_cls=True, lang="ch", show_log=False)
    print("模型加载完成,开始识别图片...\n")

    result = ocr.ocr(IMG_PATH, cls=True)

    if result and result[0]:
        print(f"共识别到 {len(result[0])} 处文字:\n")
        for i, line in enumerate(result[0], start=1):
            text = line[1][0]
            score = line[1][1]
            print(f"[{i}] {text}   (置信度 {score:.2f})")
    else:
        print("没有识别到文字,请换一张清晰的图片试试。")

if __name__ == "__main__":
    main()
3.3.3 ocr_camera.py —— 最终成品
核心逻辑:
1.加载中文 OCR 模型;
2.打开 USB 摄像头;
3.每 10 帧抽一帧做识别(降低 CPU 压力);
4.识别结果用绿框框出来,并在框上方标注中文;
5.画面左上角显示识别数量,按 Q 退出。
# -*- coding: utf-8 -*-"""============================================================ USB 摄像头实时 OCR 文字识别(中文) 绿框常驻显示,并在绿框上标注识别出的文字 使用 PaddleOCR + OpenCV + Pillow 按键盘 Q 键退出程序============================================================"""
import osimport sysimport cv2import numpy as npfrom PIL import Image, ImageDraw, ImageFontfrom paddleocr import PaddleOCR
# 解决 Windows 控制台中文乱码问题if sys.platform == "win32":
    try:
        sys.stdout.reconfigure(encoding="utf-8")
    except Exception:
        pass
# ==================== 需要你修改的地方 ====================# USB 摄像头编号:0 表示电脑上的第一个摄像头。# 如果打不开,把 0 改成 1(表示第二个摄像头)再试。
CAMERA_INDEX = 0
# 每隔多少帧识别一次文字。# 数字越小识别越"跟手",但画面越卡;数字越大画面越流畅,但识别更新慢。# 建议 5 ~ 20,普通 CPU 电脑建议 10。
FRAME_INTERVAL = 10# ========================================================
# Windows 常见中文字体(按顺序找第一个存在的)
FONT_PATHS = [
    "C:/Windows/Fonts/msyh.ttc",    # 微软雅黑
    "C:/Windows/Fonts/simhei.ttf",  # 黑体
    "C:/Windows/Fonts/simsun.ttc",  # 宋体
]

_font_cache = {}

def get_font(size):    """加载中文字体(带缓存)"""
    if size in _font_cache:
        return _font_cache[size]
    font = None
    for path in FONT_PATHS:
        if os.path.exists(path):
            try:
                font = ImageFont.truetype(path, size)
                break
            except Exception:
                continue
    if font is None:
        font = ImageFont.load_default()
    _font_cache[size] = font
    return font

def open_camera(index):    """打开摄像头,自动尝试两种方式,提高成功率"""
    # 方式一:DirectShow(Windows 上读 USB 摄像头最稳)
    cap = cv2.VideoCapture(index, cv2.CAP_DSHOW)
    if cap.isOpened():
        return cap
    cap.release()

    # 方式二:系统默认方式
    cap = cv2.VideoCapture(index)
    return cap

def draw_text_box(frame, box, color=(0, 255, 0), thickness=2):    """在画面上画出文字的四边框"""
    pts = [(int(p[0]), int(p[1])) for p in box]
    for i in range(4):
        cv2.line(frame, pts[i], pts[(i + 1) % 4], color, thickness)

def draw_chinese_labels(frame, items):    """在画面上为每个文字框绘制中文标签(文字显示在框上方)"""
    if not items:
        return frame

    # OpenCV 用 BGR 颜色,PIL 用 RGB,先转换
    img = Image.fromarray(cv2.cvtColor(frame, cv2.COLOR_BGR2RGB))
    draw = ImageDraw.Draw(img)
    font = get_font(20)

    for box, text, score in items:
        xs = [int(p[0]) for p in box]
        ys = [int(p[1]) for p in box]
        x = min(xs)
        y = min(ys)

        label = f"{text} {score:.2f}"

        # 标签默认放在框上方;如果太靠屏幕顶部,就放到框内部
        text_y = y - 28
        if text_y < 0:
            text_y = y + 2

        # 先画绿色背景条,再画黑色文字
        bbox = draw.textbbox((x, text_y), label, font=font)
        draw.rectangle(bbox, fill=(0, 255, 0))
        draw.text((x, text_y), label, font=font, fill=(0, 0, 0))

    # 转回 OpenCV 的 BGR
    return cv2.cvtColor(np.array(img), cv2.COLOR_RGB2BGR)

def main():
    # 1. 初始化 OCR(中文,带方向分类)
    print("正在加载 OCR 模型(首次运行会自动下载模型,请耐心等待)...")
    ocr = PaddleOCR(use_angle_cls=True, lang="ch", show_log=False)
    print("OCR 模型加载完成!\n")

    # 2. 打开 USB 摄像头
    print(f"正在打开 USB 摄像头(编号 {CAMERA_INDEX})...")
    cap = open_camera(CAMERA_INDEX)

    if not cap.isOpened():
        print("\n[错误] 打开摄像头失败!请检查:")
        print("  1. 摄像头的 USB 线是否插好")
        print("  2. 如果插了多个摄像头,把 CAMERA_INDEX 从 0 改成 1 再试")
        print("  3. 摄像头是否被其他软件(微信视频、QQ 等)占用")
        return

    print("打开成功!画面窗口打开后,按键盘 Q 键退出。\n")

    frame_count = 0
    last_items = []  # 保存最近一次识别到的 [(框坐标, 文字, 置信度), ...]

    while True:
        ret, frame = cap.read()
        if not ret:
            print("[提示] 读取画面失败")
            break

        frame_count += 1

        # 3. 每隔 FRAME_INTERVAL 帧做一次 OCR 识别
        if frame_count % FRAME_INTERVAL == 0:
            last_items = []
            result = ocr.ocr(frame, cls=True)

            if result and result[0]:
                for line in result[0]:
                    box = line[0]       # 文字框的四个角坐标
                    text = line[1][0]   # 识别出的文字
                    score = line[1][1]  # 置信度(0~1,越大越可信)

                    last_items.append((box, text, score))
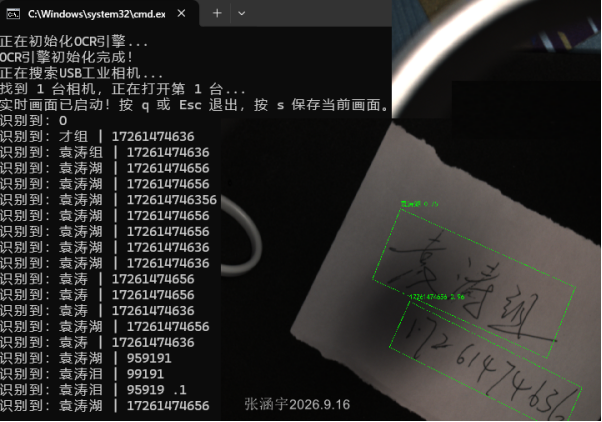
                    print(f"识别到:{text}   (置信度 {score:.2f})")
                print("-" * 40)

        # 4. 每一帧都画框(常驻显示,不闪烁)
        for box, text, score in last_items:
            draw_text_box(frame, box)

        # 5. 在绿框上方标注识别出的中文文字
        frame = draw_chinese_labels(frame, last_items)

        # 6. 画面左上角显示识别数量
        info = f"Detected: {len(last_items)} text(s) | Q = quit"
        cv2.putText(frame, info, (10, 25),
                    cv2.FONT_HERSHEY_SIMPLEX, 0.7, (0, 255, 0), 2)

        # 7. 显示画面
        cv2.imshow("OCR Camera (按 Q 退出)", frame)

        if cv2.waitKey(1) & 0xFF == ord('q'):
            print("已退出。")
            break

    cap.release()
    cv2.destroyAllWindows()

if __name__ == "__main__":
    main()
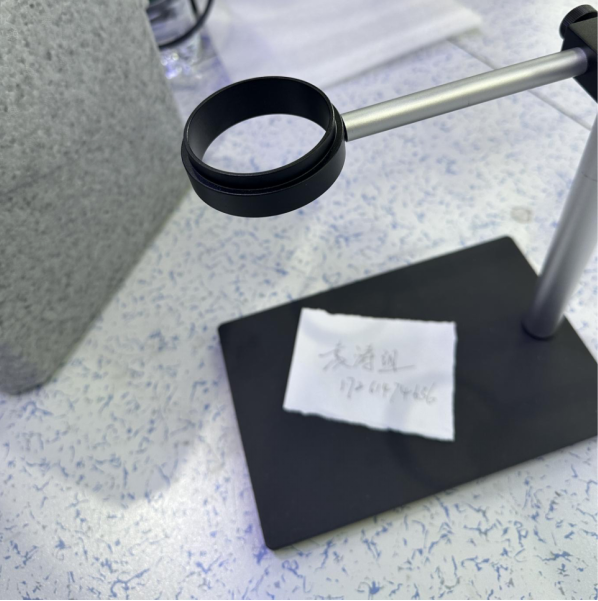
3.4 运行测试
4 IoTDA中转空间构建
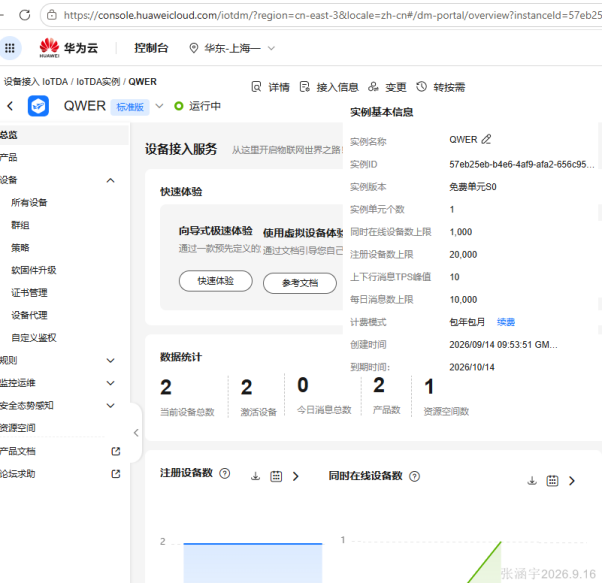
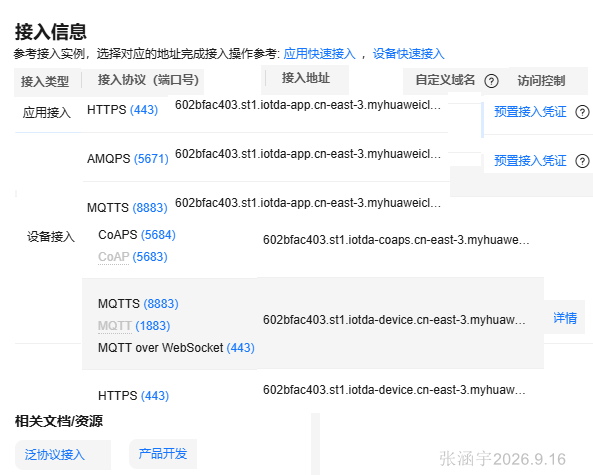
4.0 IoTDA构造
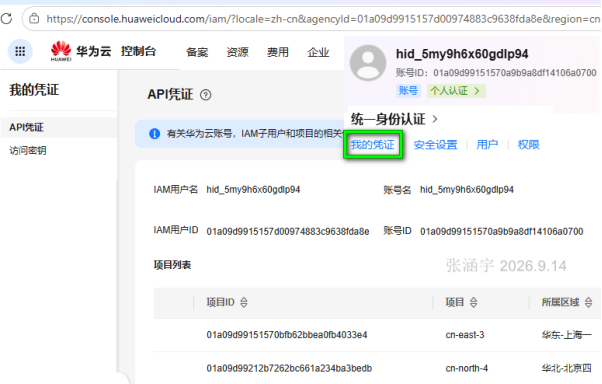
4.1 产品及其模型构建
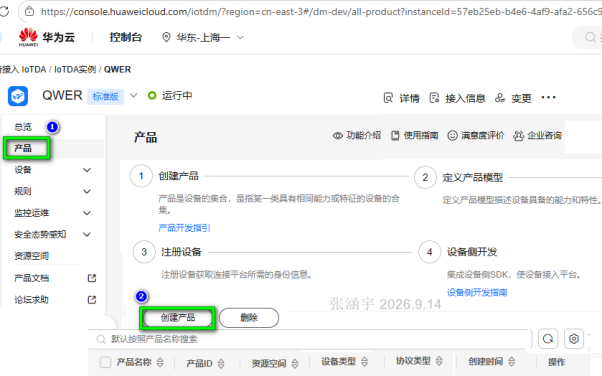
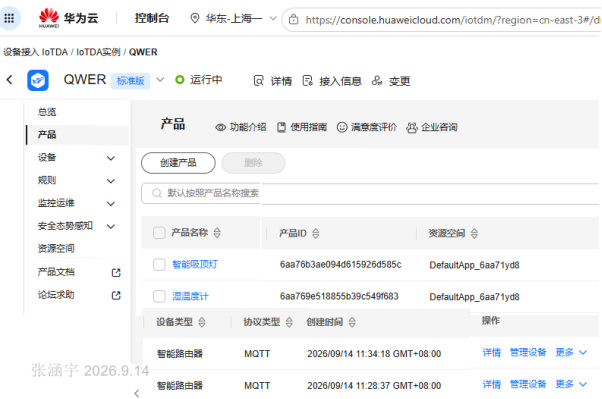
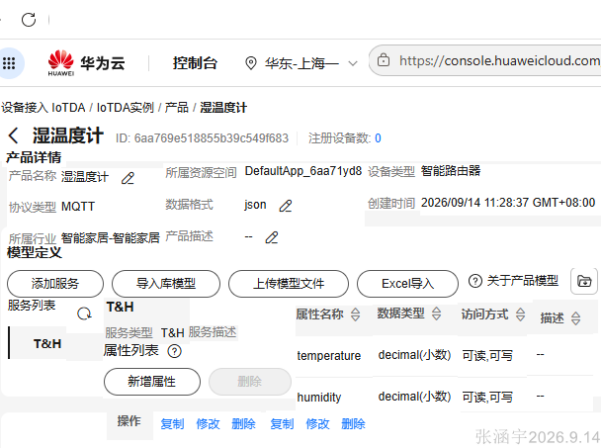
4.1.1 温湿度计
4.1.2 吸顶灯
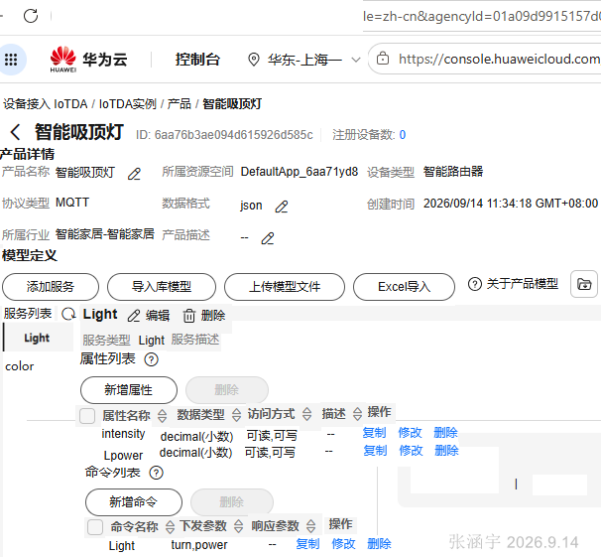
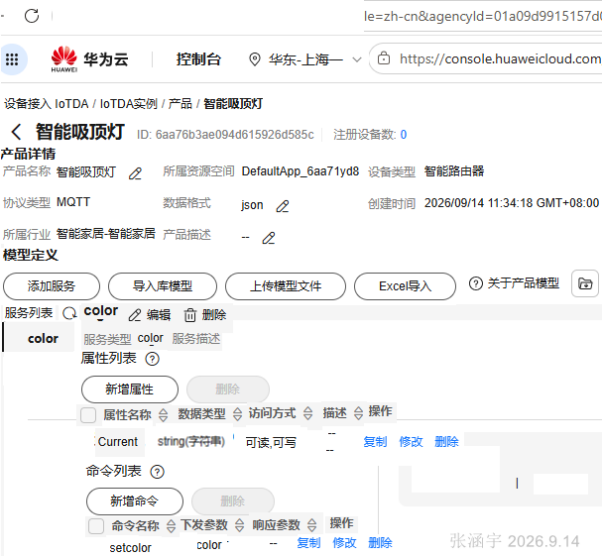
4.2 设备实例化应用
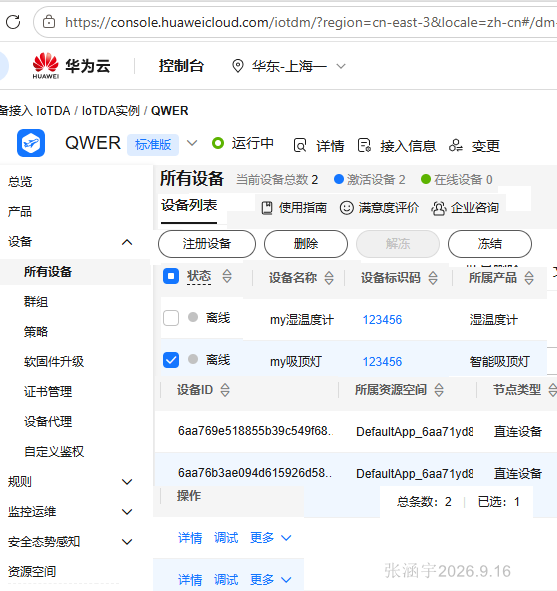
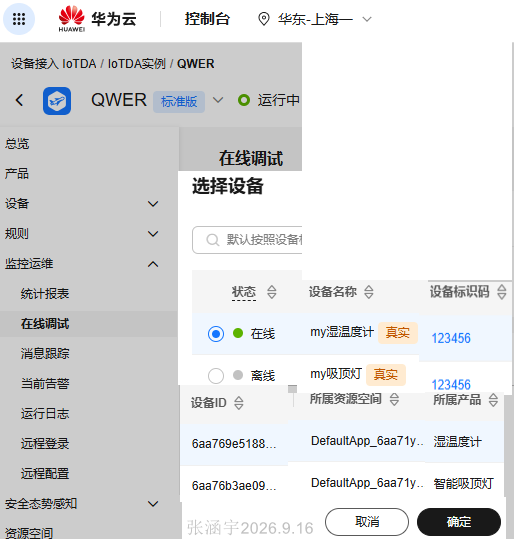
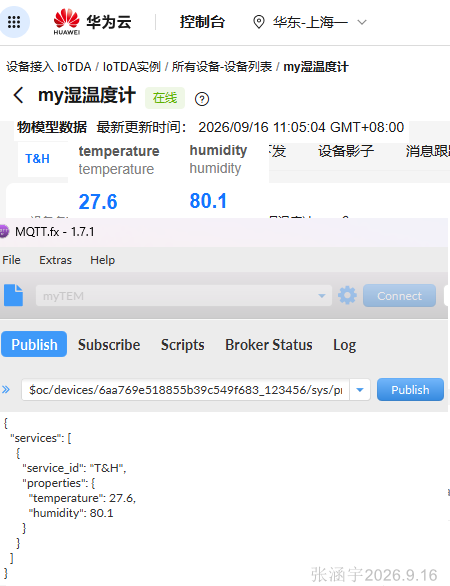
4.2.1 温湿度计设备注册及模拟测试
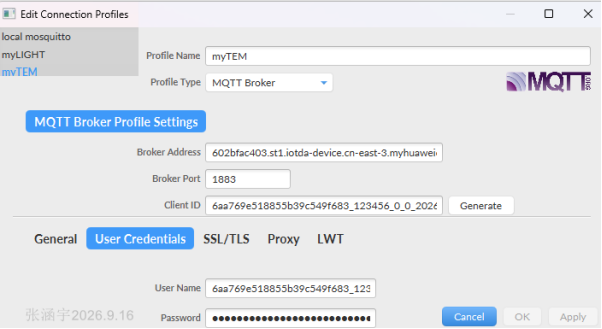
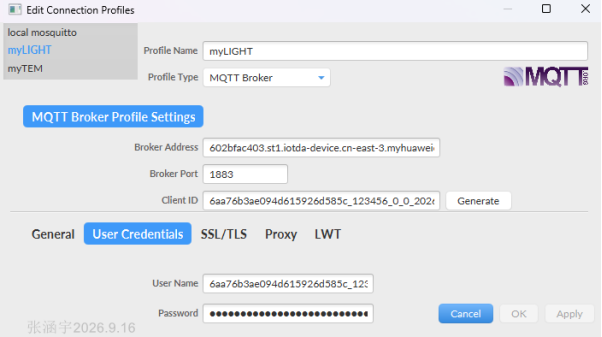
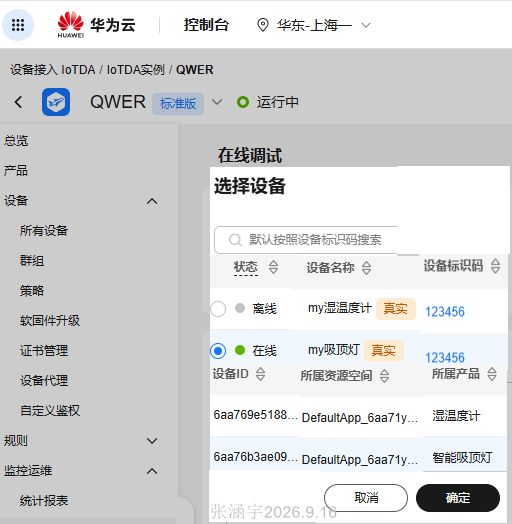
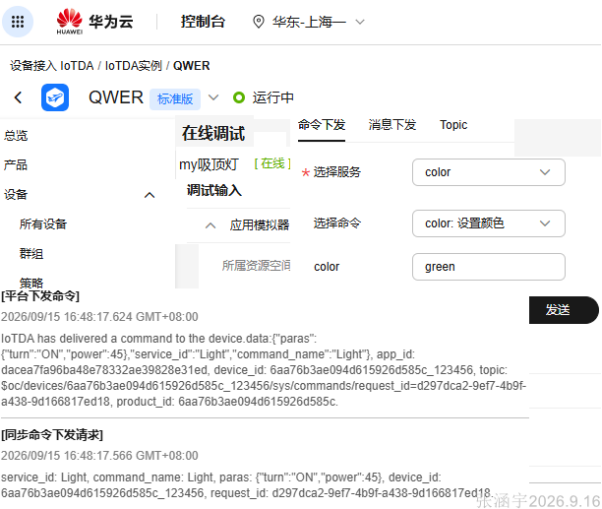
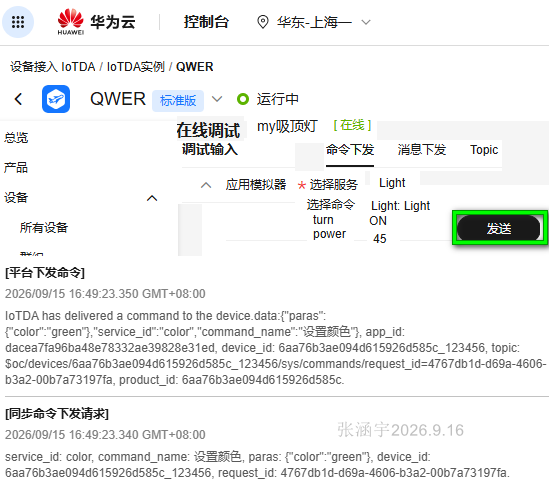
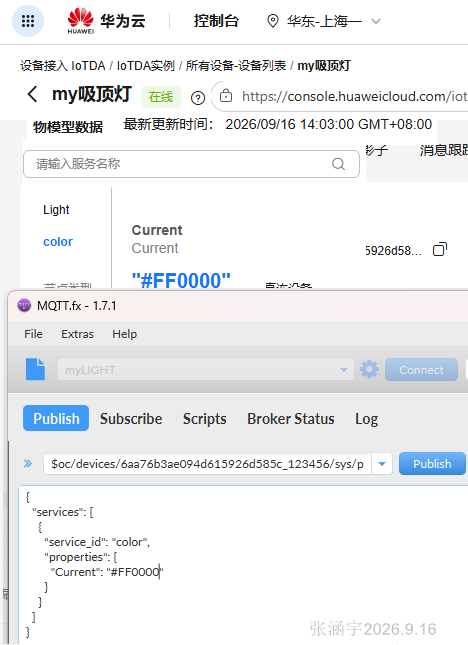
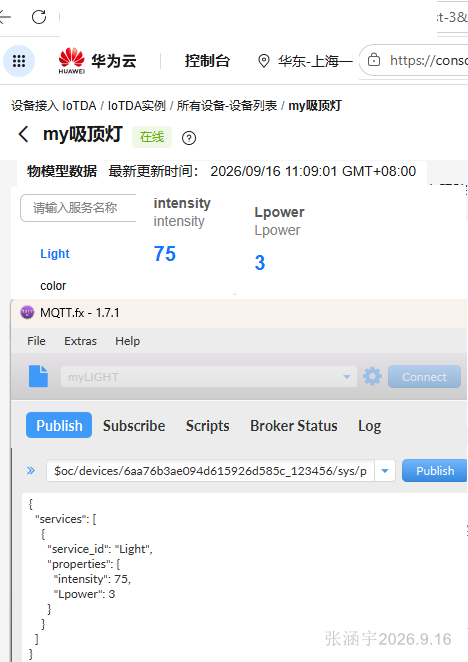
4.2.2 吸顶灯设备注册及模拟测试
5 CodeArts智慧路灯快速构建与部署
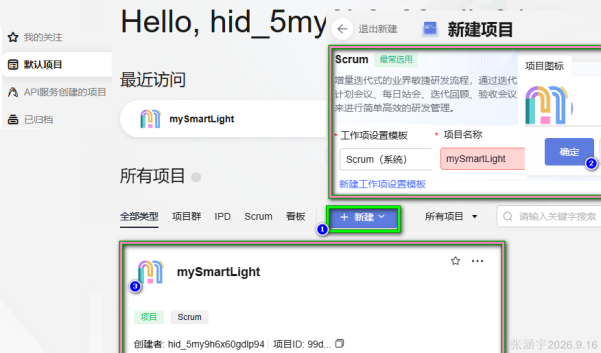
5.1 应用项目创建
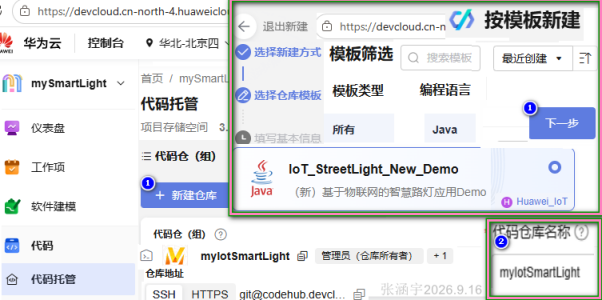
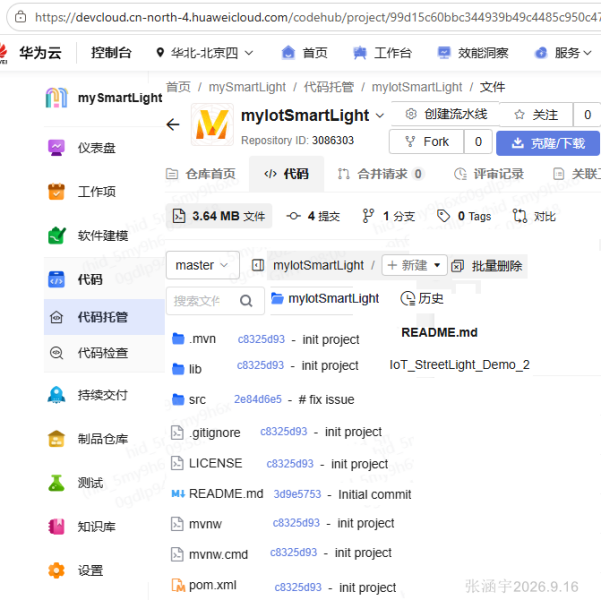
5.2 代码托管操作
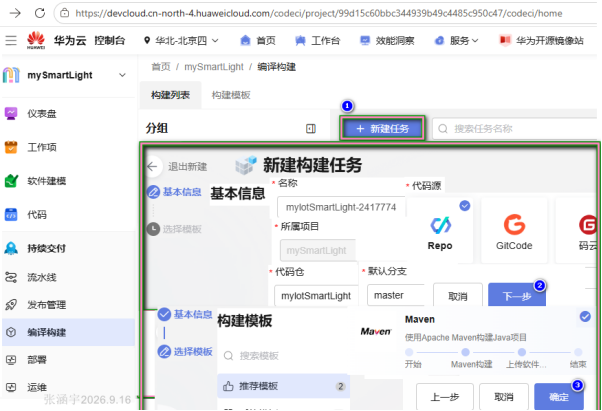
5.3 构建任务设立
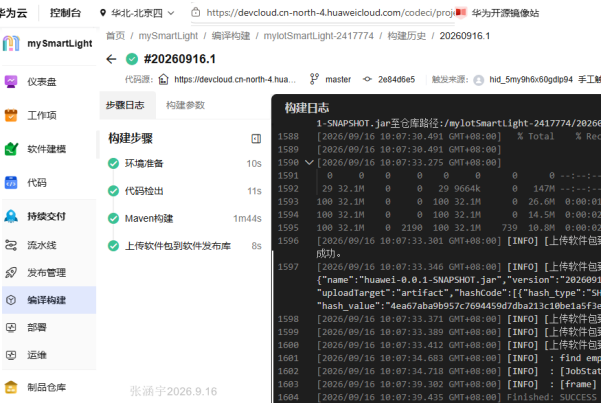
5.4 项目构建实现
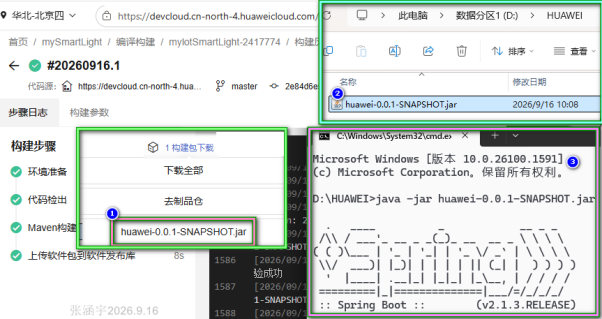
5.5 项目部署运行

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)