
别上云了,鲲鹏住我电脑里:DevKit AI 本地安装
一、本地环境
● window11版本以上
● QEMU (开源硬件模拟器,提供 aarch64 (ARM64) 架构的虚拟机运行环境)
● 系统镜像 openEuler 22.03
● ollama(安装:qwen3-coder:30b 和 bge-m3:latest 模型)
● 独立显卡(非必须,有的话更快)
● 参考文档
注意:需要提前在虚拟机上安装好openEuler 22.03的aarch64 版本以及ollama模型服务(具体安装步骤这里就不做描述,因为每个人电脑环境有差异,安装步骤可能不一样)。
二、安装套件
2.1 下载安装包
● 下载地址
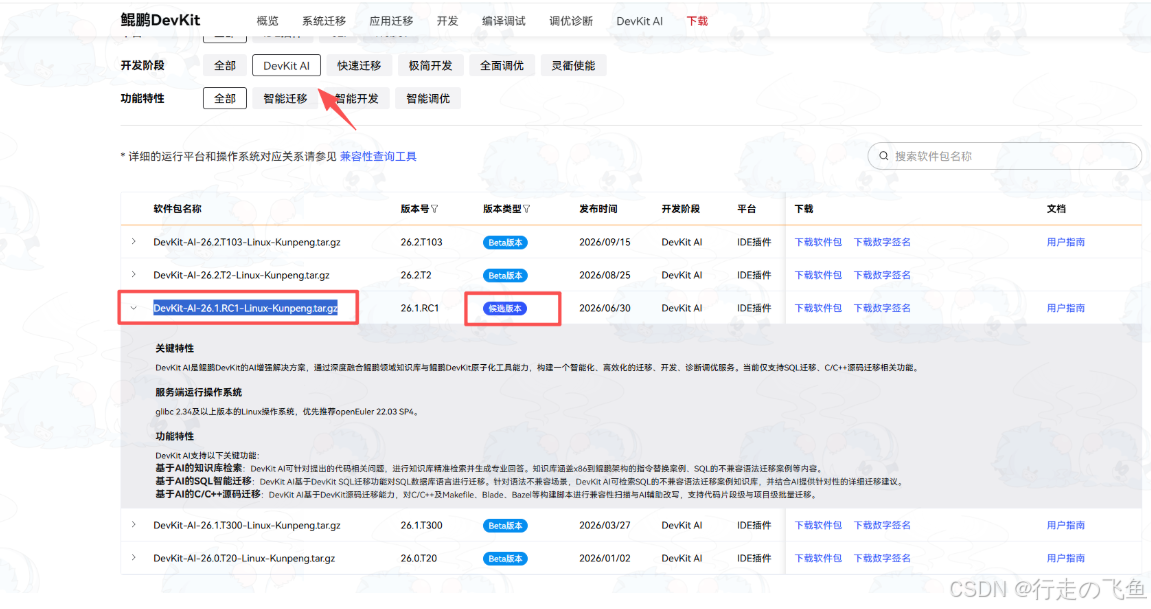
● 包名:DevKit-AI-26.1.RC1-Linux-Kunpeng.tar.gz
注意:下载候选版本(因为Beta版本缺少一些文件,官方教程也不是用的Beta版本)
2.2 部署服务
把安装包DevKit-AI-26.1.RC1-Linux-Kunpeng.tar.gz上传到服务器(博主上传的是/opt/路径下)
解压安装tar -xvzf DevKit-AI-26.1.RC1-Linux-Kunpeng.tar.gz
tar -xvzf DevKit-AI-26.1.RC1-Linux-Kunpeng.tar.gz
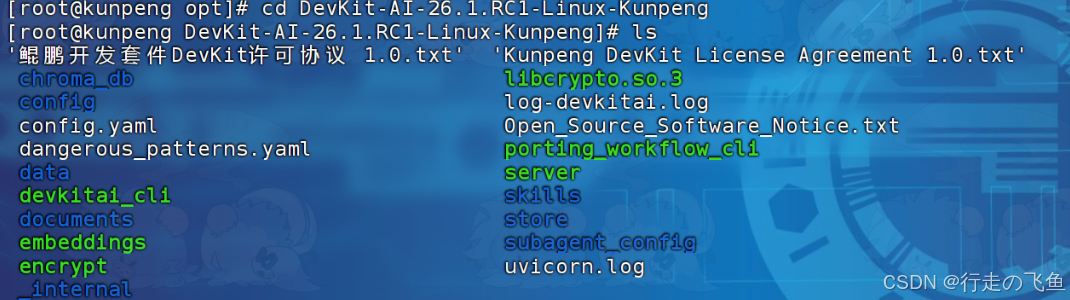
解压后的文件夹
进入文件夹
cd DevKit-AI-26.1.RC1-Linux-Kunpeng
ls
执行工具前导入环境变量
export LD_LIBRARY_PATH=/opt/DevKit-AI-26.1.RC1-Linux-Kunpen:$LD_LIBRARY_PATH
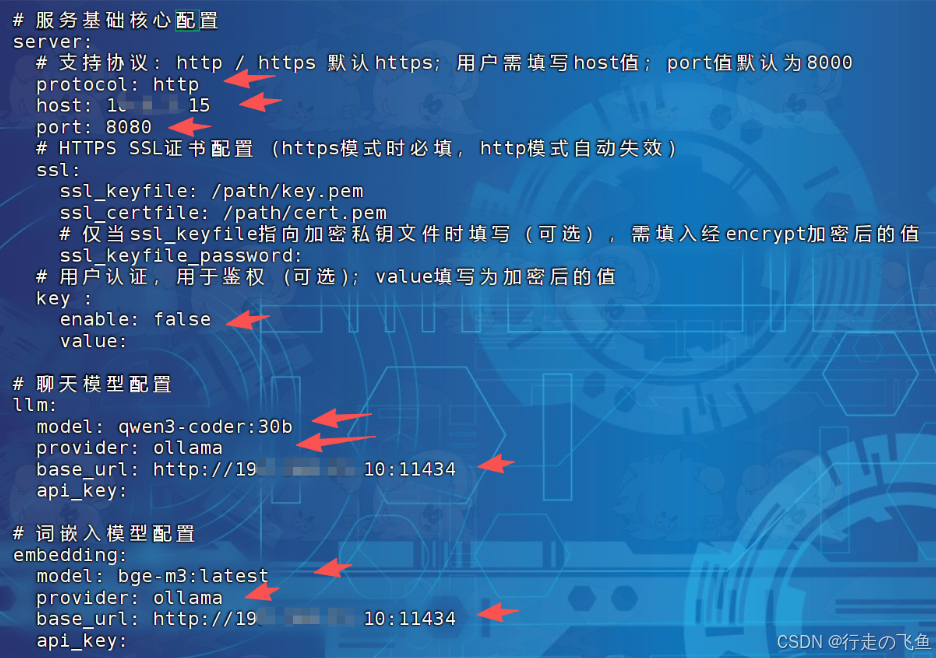
配置config.yaml文件
vim config.yaml
进入INSERT模型进行配置
注意:
● host是主机ip必填
● 因为测试没使用https,用的http
● 端口8080
● 因为测试没有开启用户认证,用的false
● ollama模型是本地部署,参考官方教程使用的是qwen3-coder:30b和bge-m3:lastest。
进行文档的向量化和入库操作,执行embeddings文件。
./embeddings
执行完成后

注意:
● 如果ollama模型配置错误,会出现“文档嵌入/向量数据库入库过程中发生错误:time out”
● 如果llm模型的参数过低会导致执行时间过长导致失败。最好不低于30b
2.3启动服务
通过命令后台运行服务
nohup ./server > ./uvicorn.log 2>&1 &
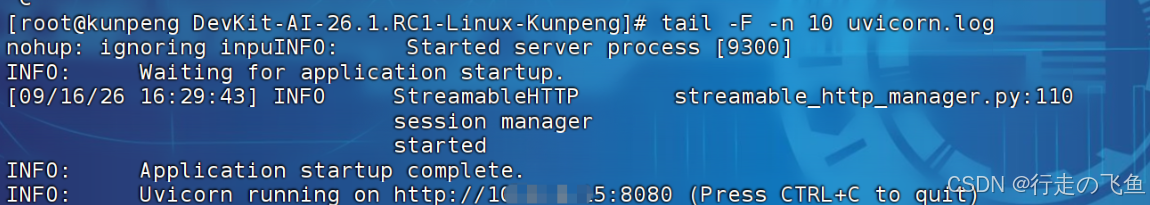
查看服务日志,等待服务启动
tail -F -n 10 uvicorn.log
服务启动完成
2.4 检查服务
检查服务
ss -tulpn | grep :8080

api服务(如果需要开启https和接口密钥,需要先通过“./encrypt”进行密钥生成,然后再配置config.yaml)
curl http://host的IP地址:8080

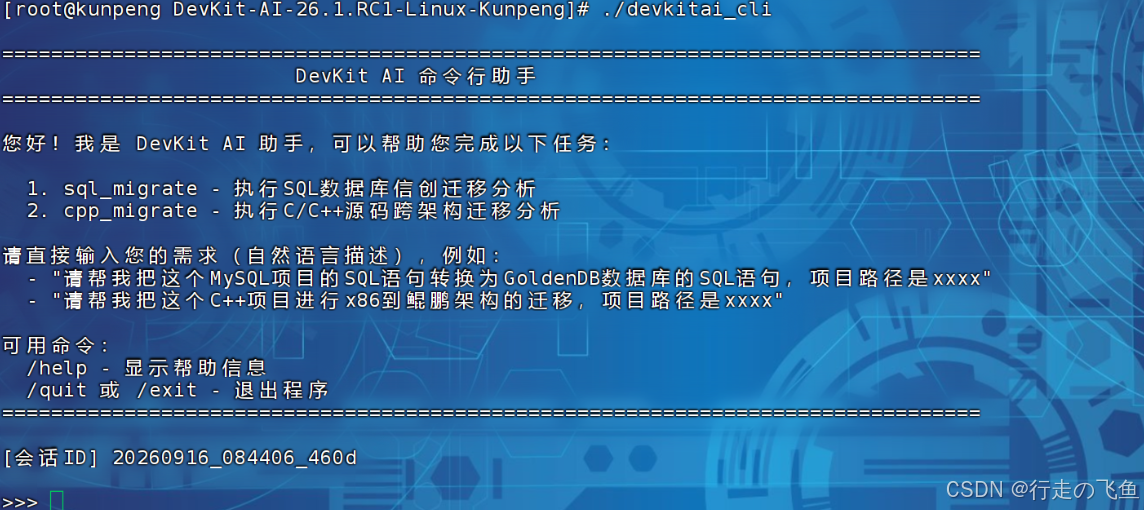
功能使用(命令行)
./devkitai_cli
关闭服务
# 具体的pid值通过“检查服务”获取
kill -9 {pid}
2.5 总结
到此整个安装过程就完成了,虽然中途遇到些问题,不过都解决了,最主要的是以行践言。

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)