
动态图qwen3.5 megatron与mindspore transformers精度对齐实践(dense+moe)
作者:昇腾实战派
知识地图:https://blog.csdn.net/Lumos_Lovegood/article/details/161601003
背景概述
在大模型训练中,不同硬件平台(Ascend NPU 与 NVIDIA GPU)以及不同训练框架(MindSpore 与 Megatron-LM)之间的精度对齐是确保模型迁移正确性的关键环节。本文记录了在 Qwen3.5 系列模型(包括 dense 和 MoE 两种架构)上,实现 MindSpore pynative 动态图模式(Ascend NPU)与 Megatron-LM(NVIDIA GPU,TransformerEngine 后端)之间 bf16 精度对齐的完整过程。对齐覆盖了主损失(lm_loss)和 MTP 损失(mtp_loss),并涉及 GatedDeltaNet 线性注意力、门控 GQA 全注意力、Partial RoPE、SwiGLU、RMSNorm 等核心组件。
对齐结果概述
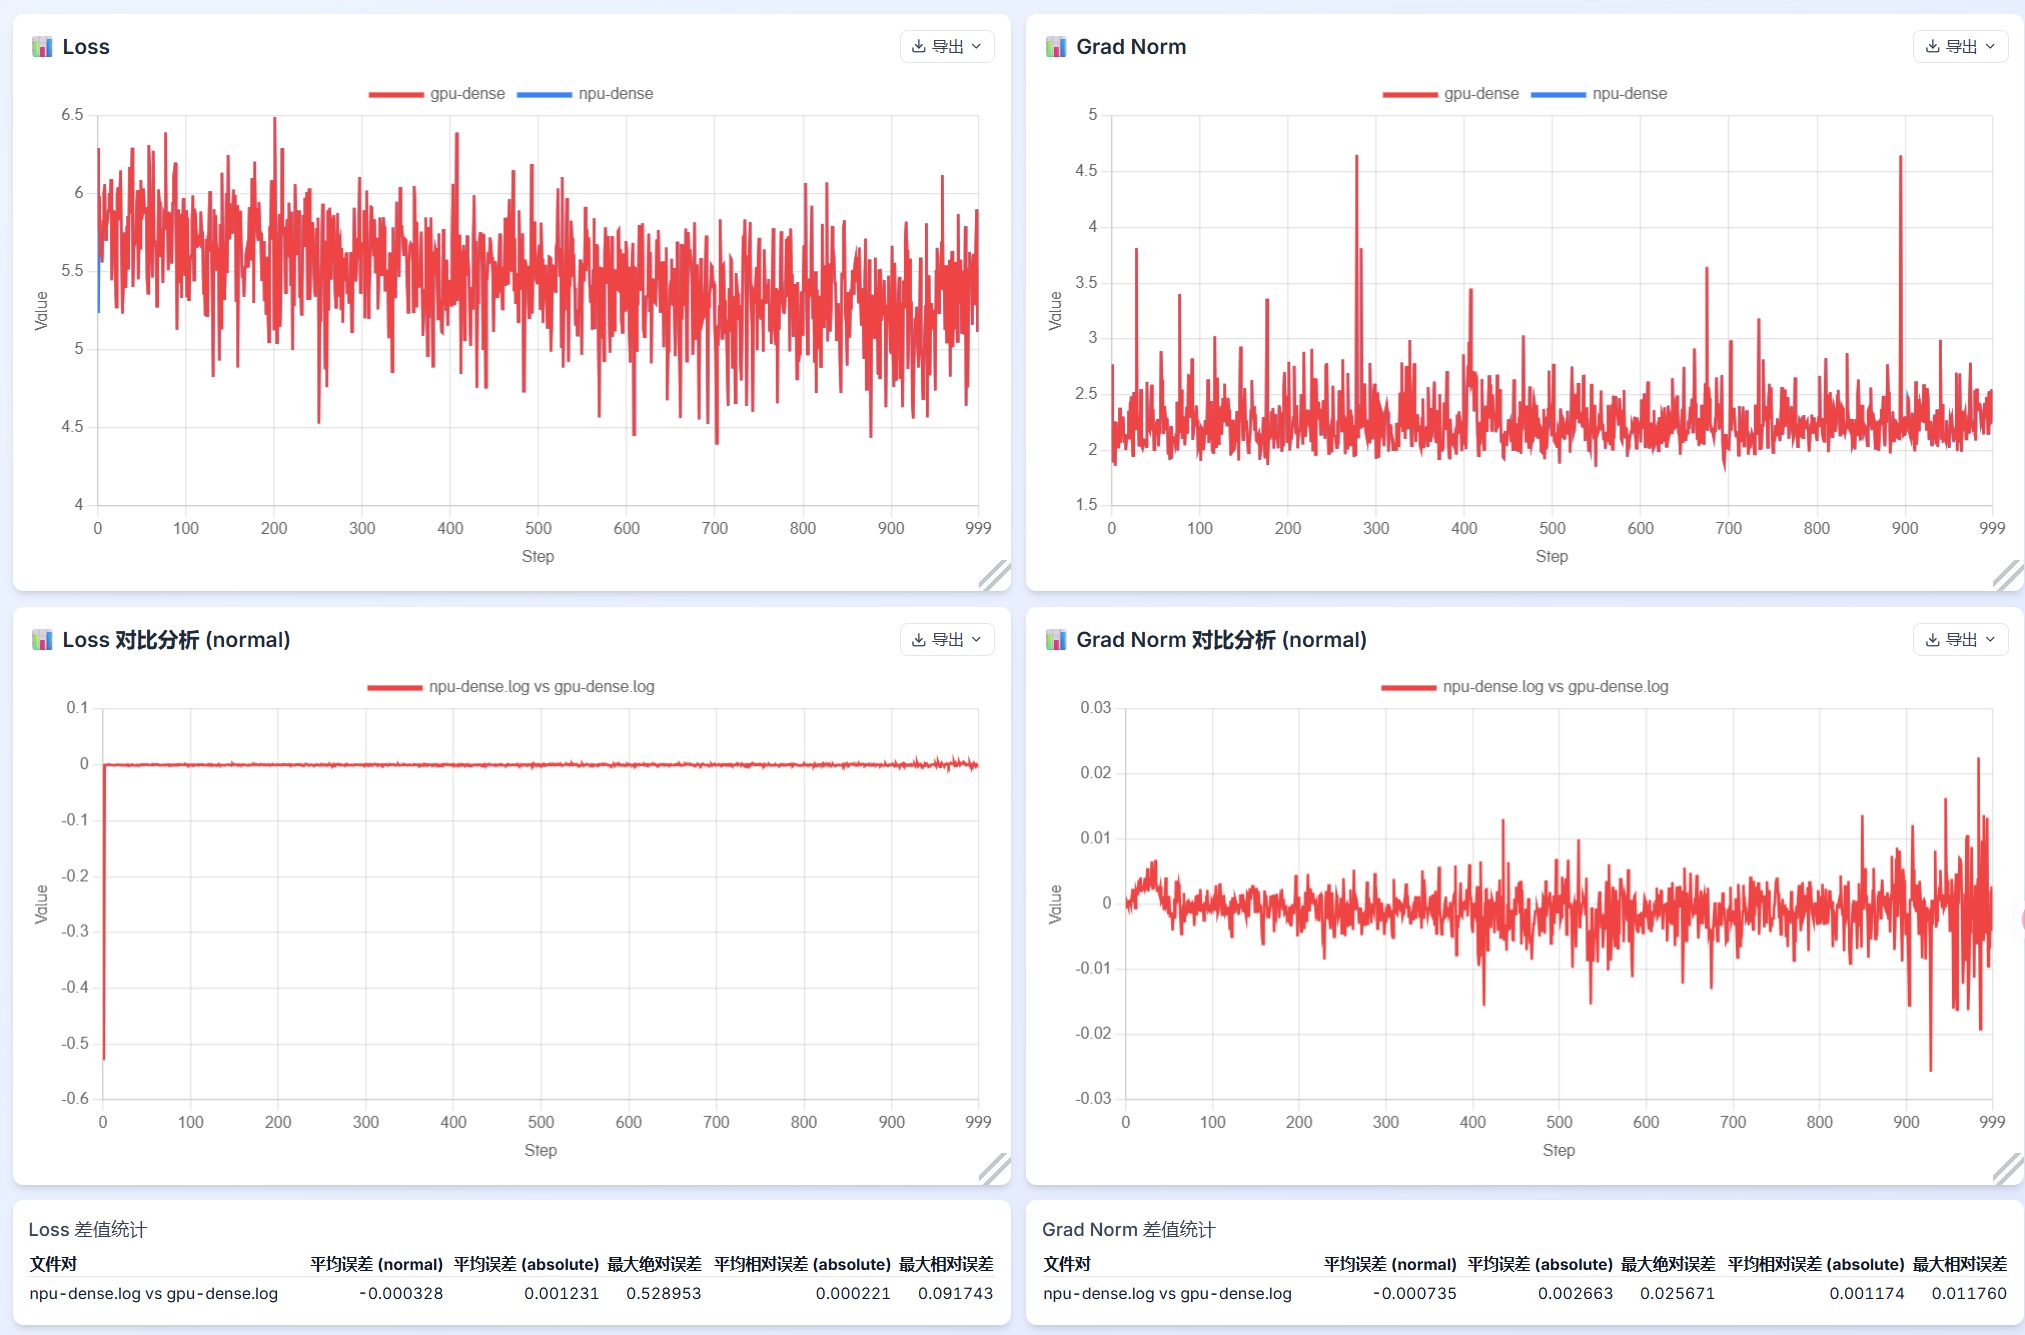
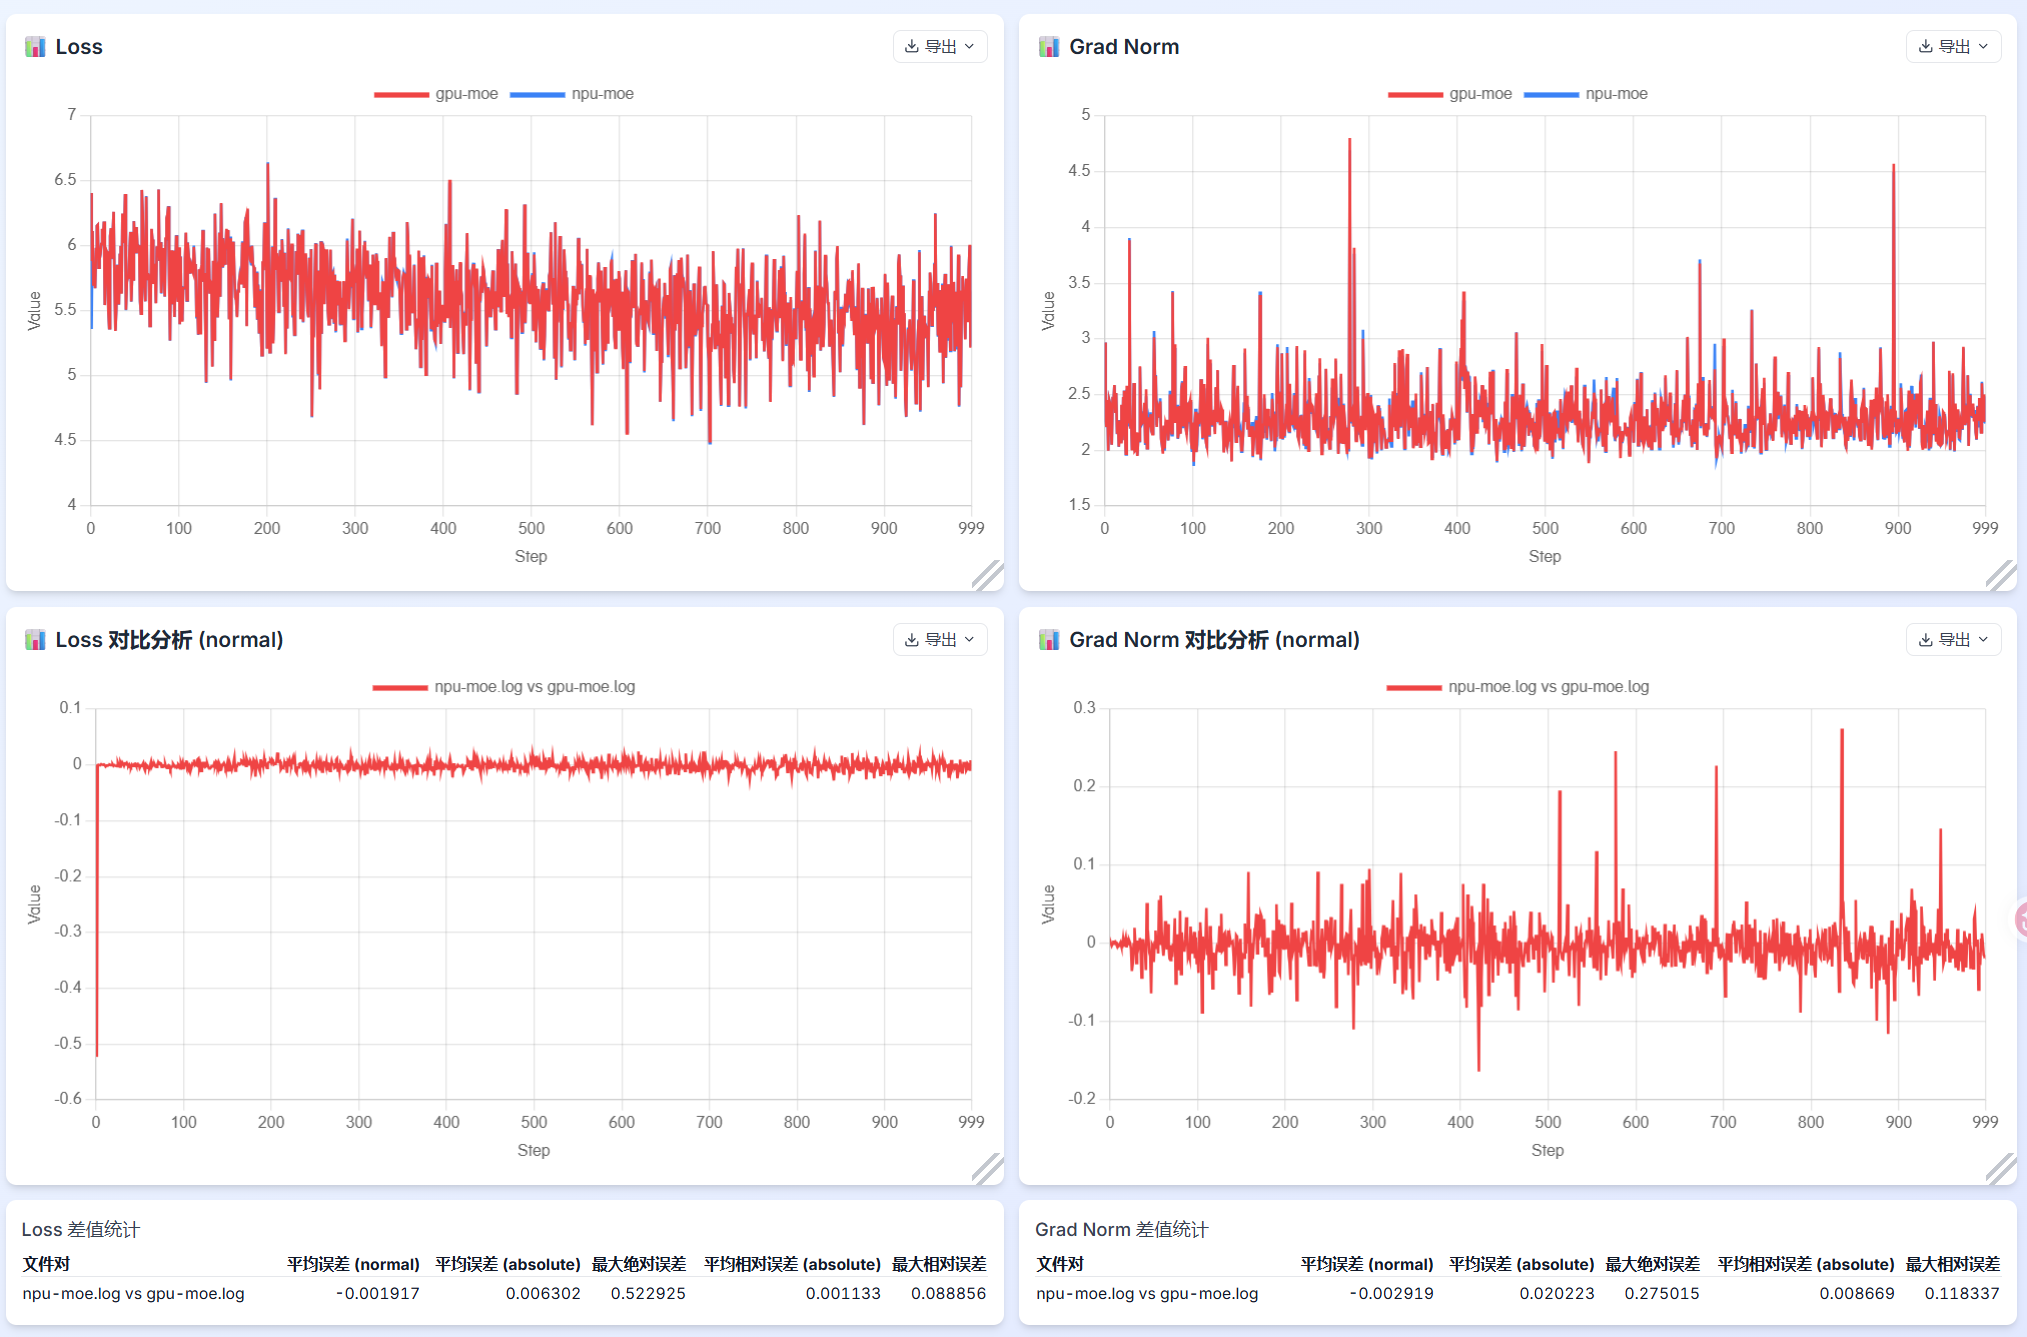
经过 1000 步训练验证,对齐结果如下(标准:首步 loss 相对误差 <0.5%,平均 <1%):
| 模型 | step1 lm 误差 | step1 mtp 误差 | 均值 lm (排除 step2) | 均值 mtp (排除 step2) |
|---|---|---|---|---|
| qwen35_dense (+MTP) | 0.0005% | 0.0004% | 0.018% | 0.015% |
| qwen35_moe (+MTP) | 0.0021% | 0.0031% | 0.070% | 0.049% |
- step1 双 loss 达到逐位级对齐,验证了权重转换、路由逻辑和 MTP 机制的正确性。
- 1000 步中仅 step2 超过 0.5%(lm/mtp 同步出现,为 Adam 优化器首步瞬态,step3 即恢复,详见后文分析)。
- 单卡 dense 与单卡 MoE 的 loss 曲线对比如下(图片链接保留原样):
1. 模型配置
dense 与 MoE 共用以下主干配置:
| 配置项 | 值 | 配置项 | 值 |
|---|---|---|---|
| hidden_size | 1024 | num_layers | 8 |
| num_attention_heads | 16 | num_query_groups (KV) | 4 |
| head_dim (kv-channels) | 256 | seq_length | 2048 |
| vocab / padded-vocab | 248320 | RMSNorm eps | 1e-5(标准 gamma) |
| linear_attention_freq | 4(3:1 混合,全注意力在 0-indexed 第 3、7 层) | Partial RoPE | rotary_base 1e6, rotary_percent 0.25 |
| dense FFN | ffn_hidden 3072(SwiGLU) | MoE FFN | 8 路由专家 top-2 + 1 共享专家,moe_ffn 512,shared 512 |
| MTP | 1 层,mtp_loss_scaling 1.0 | router(MoE) | softmax,norm_topk_prob=True,routed_scaling 1.0 |
全注意力层判定规则:0-indexed idx 满足 (idx+1)%4==0 的层(即第 3、7 层)使用全注意力,其余层使用 GDN(GatedDeltaNet)线性注意力。
2. Megatron 侧准备工作
2.1 依赖环境
- TransformerEngine (TE):必须使用
--transformer-impl transformer_engine,因为混合注意力 spec 对experimental_attention_variant的断言仅支持 TE 后端,且 GDN 的 in_proj 依赖 TE 融合的 LayerNorm+Linear。 - flash-linear-attention (fla):GDN 运行时必需(
chunk_gated_delta_rule/causal_conv1d/l2norm)。 - Megatron-LM 代码仓库(本仓库
Megatron-LM/)。
2.2 MTP+GDN 临时补丁
Megatron 原生 get_gpt_decoder_layer_specs 对 experimental_attention_variant 存在硬断言(gpt_layer_specs.py:572),导致 MTP + GDN 组合无法运行。解决方案:在 MTP 构建处(gpt.py 的 gpt_mtp_module_spec)当 experimental_attention_variant is not None 时,复用已建好的 experimental decoder spec 的最后一层(transformer_layer_spec.layer_specs[-1],即 3:1 混合中的全注意力层,与 MTP 头同构),绕过断言。
核心修改逻辑:
elif transformer_cfg.experimental_attention_variant is not None:
    spec = transformer_layer_spec.layer_specs[-1]   # 复用 experimental decoder 的全注意力层做 MTP 内部层
else:
    decoder_specs = get_gpt_decoder_layer_specs(...)  # 原路径
    spec = decoder_specs[-1]
完整 diff 见 shared/docs/megatron_mtp_gdn_patch.diff。在 GPU 运行前必须应用此补丁。
2.3 checkpoint 加载兼容性
若 --load 转换出的 model_optim_rng.pt 报 weights_only 错误,需在 checkpointing.py 中给两处 torch.load(...) 添加 weights_only=False 参数。
2.4 命令行参数说明
--experimental-attention-variant / --linear-* / --attention-output-gate / --qk-layernorm / --mtp-num-layers / --moe-* / --rotary-percent / --num-query-groups / --kv-channels 等参数由 argument_utils.py 从 TransformerConfig 自动生成(可通过 pretrain_gpt.py --help 查看)。注意:GQA 使用 --num-query-groups(而非 --num-key-value-heads);RMSNorm 固定使用标准 gamma(不添加 --layernorm-zero-centered-gamma)。
3. 精度对齐总流程
整个对齐流程分为六个步骤,涉及三台机器分工:
 【NPU/本机】                【CPU/本机】                 【GPU - 手动执行】
 步骤1 base 训练(1000步)  →  步骤2 base→bf16          步骤4 GPU Megatron 训练(1000步)
 run_mindformer.py          convert_bf16.py            run_qwen35_*_single.sh
 → qwen35_(moe)_base/       → _bf16/                   --load 转换产物 → single.log
        └────────────►  步骤3 bf16→Megatron  ─────────►
                        convert_qwen35_*_to_megatron.py
                        → qwen35_*_megatron/
 步骤5 MF pynative 加载 bf16 训练(1000步) → pynative.log
                        └────────────►  步骤6 双侧 lm_loss + mtp_loss 对比
两侧必须共享:同一份 mmap 数据集、同一份 tokenizer、同一种子采样顺序(seed 1234)、相同层布局、相同 lr/warmup 策略、dropout=0。
4. 步骤一:动态图 base 训练(NPU/本机)
使用 pretrain_qwen3_5_test.yaml(dense)或 pretrain_qwen3_5_moe_test.yaml(MoE)配置文件,开启保存、1000 步、单卡训练。
python mindformers/run_mindformer.py --mode 1 --config /home/g50057417/pretrain_qwen3_5_moe_test.yaml
产物路径:output/qwen35_(moe)_base/iteration_00001000/custom-model-*.safetensors。
5. 步骤二:base → bf16 转换(CPU/本机)
使用 convert_bf16.py(模型无关),读取 safetensors 文件,将所有参数转换为 bf16 后重新存储。注意:产物目录需要补充 common.json 文件(从 base 目录拷贝),MindSpore --load 需要该文件。
python shared/convert_bf16.py --input_dir output/qwen35_moe_base --output_dir output/qwen35_moe_base_bf16
cp output/qwen35_moe_base/iteration_*/common.json output/qwen35_moe_base_bf16/iteration_*/common.json
6. 步骤三:bf16(MindSpore) → Megatron 权重转换(CPU/本机)
使用 convert_qwen35_dense_to_megatron.py(dense)或 convert_qwen35_moe_to_megatron.py(MoE),读取 MindSpore safetensors 文件(无 model. 前缀),按照映射规则进行变换,输出 iter_{N:07d}/mp_rank_00/model_optim_rng.pt(fp32 存储,Megatron --bf16 加载时自动下转)。
6.1 通用映射规则(dense + MoE 一致)
RMSNorm 处理:标准 gamma 直接透传,不进行减 1 操作。MindSpore FusedRMSNorm 存储 plain w(初始值为 1),Megatron 不使用 --apply-layernorm-1p(零中心),两侧均为标准 gamma,因此 norm 直接透传。
| MindSpore 参数 | → | Megatron 参数 | 变换操作 |
|---|---|---|---|
embedding.word_embeddings.weight | → | 同名 | 直接透传 |
output_layer.weight | → | 同名 | 直接透传 |
decoder.final_layernorm.weight | → | 同名 | 直接透传(标准 gamma) |
| 全注意力层 (idx 3,7) | |||
self_attention.linear_qkv.weight (10240,1024) | → | self_attention.linear_qkv.weight | 直接透传(MindSpore 已是 [q,gate,k,v]/kv-group 交织格式,与 Megatron get_query_key_value_tensors 一致) |
input_layernorm.weight | → | self_attention.linear_qkv.layer_norm_weight | 直接透传(TE 将 input LN 融合进 linear_qkv) |
self_attention.q_layernorm.weight / k_layernorm.weight | → | 同名 | 直接透传 |
self_attention.linear_proj.weight | → | 同名 | 直接透传 |
| GDN 层 (idx 0,1,2,4,5,6) | |||
self_attention.in_proj.weight (8224,1024) | → | self_attention.in_proj.weight | 直接拷贝(已是单 fused 格式,split [qkv,z,beta,alpha],与 Megatron gated_delta_net.py 一致) |
input_layernorm.weight | → | self_attention.in_proj.layer_norm_weight | 直接透传(TE 融合) |
self_attention.conv1d.weight (6144,1,1,4) | → | (6144,1,4) | squeeze 第2维 |
self_attention.a_log | → | self_attention.A_log | 改名(小写→大写) |
self_attention.dt_bias | → | 同名 | 直接透传 |
self_attention.out_norm.weight (128,) | → | 同名 | 直接透传(注意是 value_head_dim=128,不是 hidden) |
self_attention.linear_proj.weight | → | self_attention.out_proj.weight | 改名(GDN 使用 out_proj,而非 linear_proj) |
GDN in_proj 的 dense/MoE 差异:MoE 盘上已是单 fused in_proj.weight(直接拷贝);dense 盘上是拆开的 4 张(in_proj_qkv/linear_g=z/linear_b=beta/linear_a=alpha),dense 转换器执行 cat([in_proj_qkv, linear_g, linear_b, linear_a]) 融合。最终两侧 Megatron 均为 [qkv,z,beta,alpha] 格式。
6.2 FFN 映射规则(dense vs MoE 不同)
dense FFN(mlp.linear_fc1/fc2)—— MindSpore pynative MLP 的 SwiGLU fc1 采用逐对交织格式 [g0,u0,g1,u1,...],Megatron 采用 [G;U] 两半格式:
| MindSpore 参数 | → | Megatron 参数 | 变换操作 |
|---|---|---|---|
mlp.linear_fc1.weight (gate|up 交织) | → | mlp.linear_fc1.weight | 去交织 cat([w[0::2], w[1::2]]) |
pre_mlp_layernorm.weight | → | mlp.linear_fc1.layer_norm_weight | 直接透传(TE 融合进 fc1) |
mlp.linear_fc2.weight | → | 同名 | 直接透传 |
MoE FFN(mlp.router / mlp.experts / mlp.shared_experts)—— MindSpore 使用 parallel_core(Megatron 移植),命名贴近 Megatron:
| MindSpore 参数 | → | Megatron 参数 | 变换操作 |
|---|---|---|---|
mlp.router.weight (8,1024) | → | mlp.router.weight | 直接拷贝 |
mlp.experts.weight1 (8,1024,1024) [E,H,2i] | → | mlp.experts.linear_fc1.weight | transpose(-1,-2) [E,2i,H](MindSpore [E,in,out]→TE [E,out,in];GLU [gate,up] 两侧一致不交换) |
mlp.experts.weight2 (8,512,1024) [E,i,H] | → | mlp.experts.linear_fc2.weight | transpose(-1,-2) [E,H,i] |
mlp.shared_experts.linear_fc1.weight (1024,1024) | → | mlp.shared_experts.linear_fc1.weight | 去交织(use_interleaved_weight_layout_mlp=True 默认 → 共享专家使用 MLPInterleaved,fc1 存储交织格式;Megatron 需要 [G;U]) |
mlp.shared_experts.linear_fc2.weight | → | 同名 | 直接拷贝 |
mlp.shared_experts.shared_experts_gate.weight (1,1024) | → | mlp.shared_experts.gate_weight | 改名(需 GPU 侧开启 --moe-shared-expert-gate) |
pre_mlp_layernorm.weight | → | pre_mlp_layernorm.weight | 直接拷贝(独立 key,不融合进 fc1;MoE 下 _get_moe_module_spec 返回 fuse_pre_mlp_layernorm=False) |
路由专家(GroupedMLP/FFNGroupedGEMM)的 2i 维为 [gate,up](来自 HF gate_up_proj),不需要去交织;只有共享专家(MLP 系列)受 use_interleaved_weight_layout_mlp 影响需要去交织。Megatron 的 load_state_dict 钩子会自动将 grouped [E,…] 拆分为 weight0…weight7,因此发送 grouped linear_fc1.weight 即可。
6.3 MTP 层映射规则(dense + MoE 一致;需应用 §2.2 补丁)
MTP 内部包含一个全注意力层 + FFN(dense 使用 dense FFN,MoE 使用 MoE FFN)+ MTP 专属组件。MindSpore 源前缀 mtp.layers.0.transformer_layer.* → Megatron mtp.layers.0.mtp_model_layer.*:
| MindSpore 参数 | → | Megatron 参数 | 变换操作 |
|---|---|---|---|
mtp.layers.0.eh_proj.weight | → | 同名 | 直接透传 |
mtp.layers.0.enorm/hnorm/final_layernorm.weight | → | 同名 | 直接透传 |
mtp.layers.0.transformer_layer.<全注意力层> | → | mtp.layers.0.mtp_model_layer.<…> | 前缀改名 + 按 §6.1 全注意力映射规则 |
mtp.layers.0.transformer_layer.mlp.<FFN> | → | mtp.layers.0.mtp_model_layer.mlp.<…> | 前缀改名 + 按 §6.2(dense/MoE 各自的 FFN 映射规则) |
dense 产物包含 91 个 key(76 decoder + 12 mtp + 3 global);MoE 产物包含 127 个 key(111 + 16 mtp)。
6.4 转换正确性自检(强烈建议)
权重转换是精度对齐中最易出错的环节。最可靠的验证方法:将转换产物通过 --load 加载进 Megatron 执行一次前向传播(sanity 2 步),检查 step1 lm loss(+ mtp loss)是否与 MindSpore step1 一致。本项目的金标准:step1 双 loss 相对误差 <0.005%(逐位级),即证明转换、路由和 MTP 全部正确。
7. 步骤四:GPU 拉起 Megatron 训练(1000 步)
将转换产物拷贝到 GPU 机器,运行 qwen35_dense/run_qwen35_dense_mtp_single.sh 或 qwen35_moe/run_qwen35_moe_single.sh(需修改顶部路径)。两个脚本的共通要点:
--transformer-impl transformer_engine(GDN 硬性要求 TE,不可改为 local)- 模型主干参数逐项对齐 MindSpore(hidden 1024 / 8层 / 16头 / 4KV / kv-channels 256 / vocab 248320 / RMSNorm eps 1e-5)
--experimental-attention-variant gated_delta_net --linear-attention-freq 4+ 5 个--linear-*+--attention-output-gate --qk-layernorm--position-embedding-type rope --rotary-base 1000000 --rotary-percent 0.25(必须显式指定 rope:MTP 断言在 rope 赋值前触发)--mtp-num-layers 1 --mtp-loss-scaling-factor 1.0- GQA:
--group-query-attention --num-query-groups 4 --kv-channels 256 --seed 1234 --dataloader-type single(逐样本对齐 MindSpore,详见 §11.1)--no-gradient-accumulation-fusion(对齐 DSv3 参考;TP=1/mb=1 下本为 no-op)--finetune --no-load-optim --no-load-rng --load <转换产物>--lr 3e-4 --lr-decay-style constant --lr-warmup-iters 10(与 MindSpore warmup_ratio 0.01 一致)- 不加
--apply-layernorm-1p(使用标准 gamma)
MoE 脚本额外参数:--num-experts 8 --moe-layer-freq 1 --moe-router-topk 2 --moe-ffn-hidden-size 512 --moe-shared-expert-intermediate-size 512 --moe-shared-expert-gate --moe-grouped-gemm --moe-token-dispatcher-type alltoall --moe-router-score-function softmax --moe-router-topk-scaling-factor 1.0 --moe-router-dtype fp32 --moe-router-load-balancing-type aux_loss --moe-aux-loss-coeff 0.001。
Megatron 日志会自动输出 lm loss、mtp_1 loss(MoE 还会输出 load_balancing_loss)。
8. 步骤五:MindSpore pynative 加载 bf16 训练(1000 步)
使用 pretrain_qwen3_5_align_mtp.yaml(dense)或 pretrain_qwen3_5_moe_align.yaml(MoE)配置文件:加载 §5 的 bf16 权重、开启确定性计算、1000 步、MTP=1、数据集 seed 1234、warmup_ratio 0.01。注意:模型需实现 get_mtp_loss 方法才能记录 mtp_loss(详见 §11.4)。
python mindformers/run_mindformer.py --mode 1 --config /home/g50057417/pretrain_qwen3_5_moe_align.yaml
9. 步骤六:对比与结论
使用 shared/compare_losses.py 将两侧的 lm loss 和 mtp_1 loss 绘制在同一图表中进行对比。本项目结论(§0):双侧 step1 达到逐位级对齐,1000 步均值误差 <0.07%(排除 step2),仅 step2 出现瞬态偏差。
10. 关键问题与解决方案
10.1 数据采样顺序不一致(首要问题)
现象:per-step loss 对不上、相关性差。
根因:MindSpore 数据集 seed=1234 与 Megatron --seed 使用的是同一份 Megatron-core GPTDataset 的 random_seed(两侧都无条件使用 numpy.random.RandomState(seed) 打乱文档/样本索引),但早期 Megatron 脚本写成 --seed 42,导致与 MindSpore 的 RandomState(1234) 产生完全不同的 shuffle_index,每步读取到不同样本。
解决方案:Megatron 使用 --seed 1234 --dataloader-type single(顺序读取 shuffle_index;勿用 cyclic,避免叠加 randperm(epoch) 的第二层随机)。两侧 shuffle_index.npy 逐字节相同。num_samples 不同不影响(num_epochs=1 时 shuffle_index 一致)。
10.2 MoE 路由专家权重方向
问题:MindSpore 专家 weight1/weight2 是 [E,in,out] 格式(由 HF gate_up_proj/down_proj 经 transpose(0,2,1) 得到),Megatron TE 专家线性层存储 [E,out,in] 格式。
解决方案:执行 transpose(-1,-2) 操作。weight1 是方阵 (1024²),转置对错从形状上无法判断,需通过 step1 前向数值验证。GLU [gate,up] 两侧一致,不交换。
10.3 MoE 共享专家 fc1 漏去交织
问题:use_interleaved_weight_layout_mlp=True(MindSpore 默认)→ 共享专家使用 SharedExpertMLPInterleaved,fc1 存储成交织格式 [g0,u0,…]。早期直接拷贝 → Megatron 按 [G;U] 解读 → gate/up 错位 → step1 前向偏差约 5%。
解决方案:共享专家 fc1 执行 cat([w[0::2],w[1::2]]) 去交织(路由专家使用 GroupedMLP 不受影响,保持 transpose 即可)。
10.4 MoE 路由 norm_topk_prob
问题:Megatron topk_routing_with_score_function 对 softmax+topk>1 总是进行 renorm(moe_utils.py:811,无开关);MindSpore 由 norm_topk_prob 控制(默认 False=不 renorm)→ 专家权重相差约 2 倍。
解决方案:MindSpore 配置 norm_topk_prob=True(与 Megatron 恒 renorm 一致,也符合 DSv3 参考)。另外:--moe-shared-expert-gate 必须开启(MindSpore 有 shared_experts_gate);MoE warmup_ratio=0.01(1000步→10步 warmup)须与 GPU --lr-warmup-iters 10 一致。
10.5 MTP + GDN 硬断言
问题:Megatron 原生不支持 MTP + experimental_attention_variant(gpt_layer_specs.py:572)。
解决方案:应用 §2.2 临时补丁(MTP 内部层复用 experimental decoder 的全注意力层)。
10.6 MindSpore mtp_loss 不记录
问题:loss_callback 通过 model.get_mtp_loss(...) 获取 mtp_loss,但 PyNativeQwen35(Moe)ForCausalLM 未暴露该方法(底层 GPTModel 有)。
解决方案:为两个 wrapper 添加 get_mtp_loss 方法(委托 self.model.get_mtp_loss(...))。另外:MTP 配置 recompute.mode 须为 "None"(非小写 "none")。
10.7 step2 约 10% 离群
现象:step1 前向逐位对齐,step3 立刻恢复。
分析:这是 Adam 优化器首步偏差校正(m̂=10m)放大 bf16 跨硬件反向传播的微小方向差,加上 step1 grad_norm(2.7~2.96) > clip1.0 裁剪边界,导致一步权重扰动,step2 前向(对扰动敏感的样本)偏大,step3 重新收敛。lm 与 mtp 的 step2 同步出现,印证是同一个优化器瞬态。这是 bf16 跨框架对齐的典型现象,属于良性偏差。

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)