
深度学习入门:全连接神经网络学习
(一)深度学习简要介绍
<一> 深度学习应用场景
深度学习与机器学习不同,不需要做人为的特征工程
1·语言,图像,语音
2·机器学习效果不行的场景,特征需要进行复杂处理
<二> 神经网络结构
1·输入层
2·隐藏层
3·输出层
特点:每个连接之间都有权值W;同一层神经元之间没有连接,神经元之间含有激活函数
(二)向量化编程引入
向量化编程(使用np.dot()等操作可以提升速度,减少使用for循环带来的时间消耗
如:
import numpy as np
import time
#创建向量
a = np.random.rand(10000)
b = np.random.rand(10000)
#for循环
c=0
start = time.time()
for i in range(10000):
    c+=a[i]*b[i]
end = time.time()
print("for循环:",(end-start))
#np.dot()
start = time.time()
np.dot(a,b)
end = time.time()
print("向量化运算:",(end-start))
(三)神经网络基础
<一>逻辑回归
1·逻辑回归本质上是线性回归,逻辑回归等于线性回归+sigmoid,主要针对二分类问题,先通过y=wTx+b(W与b初始值随机,不宜过大)得到每个样本的线性回归结果z,再通过sigmoid (σ(z)=1/(1+exp-z))函数映射为概率,再与阈值进行比较,判断结果为1或0
2·全部样本损失函数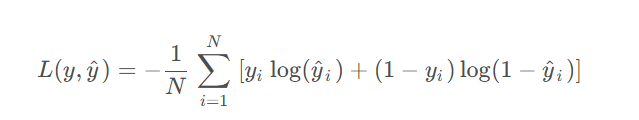
<二>梯度下降算法过程及公式
目的:使损失函数(即预测值与真实值的差距)的值变得最小,而L(y,y~)中真实值已知,但预测值y~=sigmoid(W.T*X + b ),所以损失函数L中未知数为W和b,所以L又可写作J(W,b)。若W和b都是一维实数,画出J(W,b)图像如下。函数的梯度表示函数在当前点增长最快的方向,那么按照梯度的负方向走,函数值降低得自然就最快。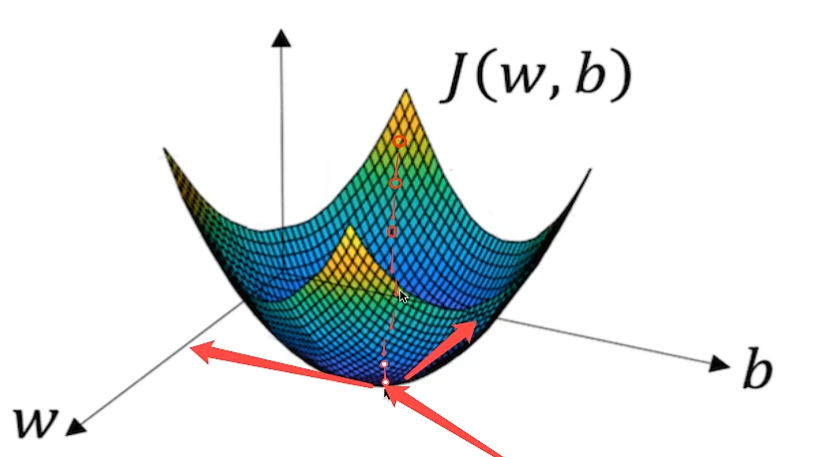
梯度下降法所做的一切都是为了更新参数W和b,使得损失变小,直至达到最大迭代次数或收敛。
参数更新公式:
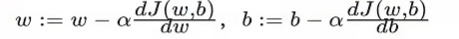
更直观一点的话:
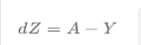
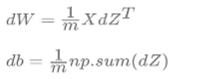
更新:
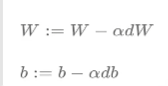
alpha为学习率,即每次更新的W和b的步伐长度。若alpha过大,可能出现一下子走过了的情况,可能会使函数无法收敛;过小会导致收敛速度过慢,训练时间过长。alpha的取值需要试探
<三>正向传播和反向传播
正向传播:从前往后计算出损失J(W,b)
反向传播:通过从后往前计算参数的梯度更新参数W,b的值直至迭代至收敛
(四)浅层神经网络
<一>前向计算过程
如图所示:隐藏层只有一层,且有多个神经元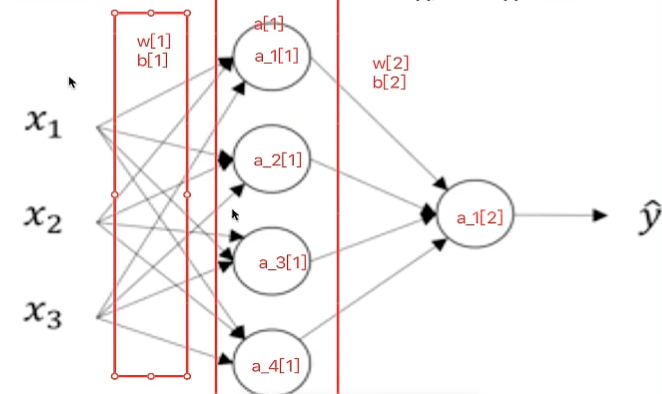
W[1]和b[1]是第一个隐层前的权重和偏置,W[1]为4*3的一个矩阵,b[1]为4*1的一个矩阵,若有m个样本,则输入层X为3*m的矩阵,通过线性回归得到z[1]=W[1]*x + b ,再使用一个激活函数(sigmoid,tanh,relu)得到a[1]=g(z[1])(隐层数据)为4*m的一个矩阵;W[2]为1*4的一个矩阵,b[2]为1*1的一个矩阵然后再次通过线性回归计算出z[2]为1*m的矩阵,最后再次通过一个激活函数输出a[2]
(注:在初次学习的过程中本人时常将样本和特征值数目混淆,此处的X为3*m其实当时并不是很理解,下来后多次查阅资料,反复观看视频才逐渐清晰:输入层的x1,x2...xn永远都是特征值,每次正向传播时应该都是以一个样本为单位进行传播,每次只会得到一个样本的结果,这里的X为3*m是想通过向量化编程快速得到m个样本的结果,所以如果有m个样本,X就应该有m列,其实W*X计算出来的每一列才是当前样本的特征值转换之后的结果,而这样的结果有m列即m个样本)
<二>激活函数选择
sigmoid:适用于二分类
tanh: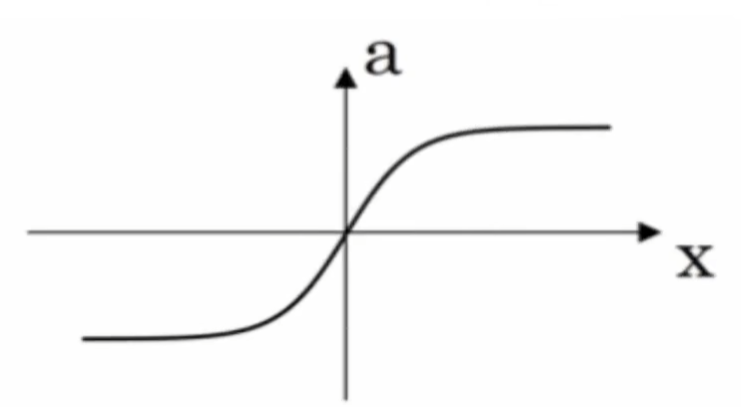
但是无论是sigmoid还是tanh函数,当z取值太大或太小时,此时的导数也就是梯度太小了,所以每次的更新程度就很小,训练就会很慢。因此引出了relu函数
relu:
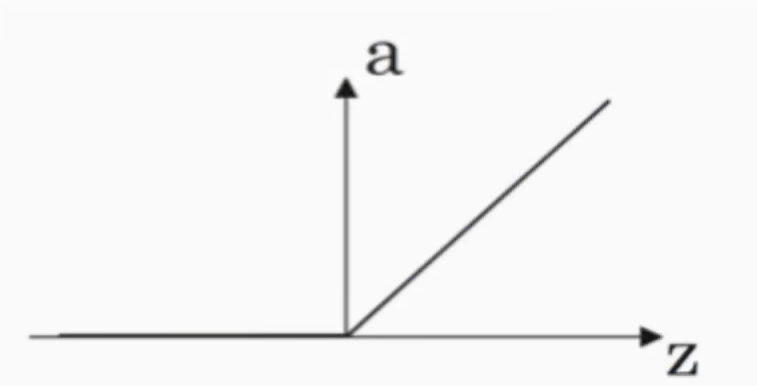
这样的话收敛速度就很快,就能够提升神经网络基于梯度算法的运算速度。z<0时虽然梯度一直为0,但在实际中影响不是很大。
leaky relu:
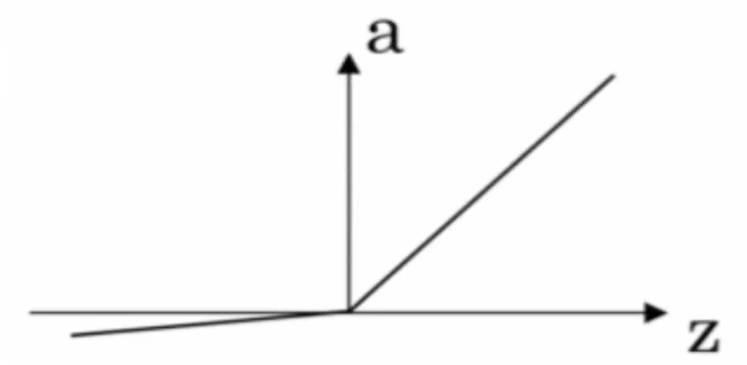
虽然解决了relu中z<0的缺陷,但是实际效果并不是总好于relu所以不常用
< 三>反向传播过程

网络存在两层,从后往前进行求导,得到每个参数的梯度即dw2,db2,dw1,db1然后进行更新,与单个神经元神经网络类似,计算过程相当于求导中的复合函数求导,嵌套了两层
<四>浅层神经网络代码实现
中间激活函数使用tanh,输出层使用sigmoid,部分代码如下
import numpy as np
import time
import h5py
import scipy
from PIL import Image
from scipy import ndimage

#定义sigmoid函数
def sigmoid(x):
    return 1/(1+np.exp(-x))

#定义网络结构
def layer_size(x,y):
    n_x = x.shape[0]
    n_h = 4
    n_y = y.shape[0]
    return (n_x,n_h,n_y)
#初始化参数,并将参数装入字典中
def initialize_parameters(n_x,n_h,n_y):
    w1 = np.random.randn(n_h,n_x)*0.01
    b1 = np.zeros(n_h,1)
    w2 = np.random.randn(n_y,n_h)*0.01
    b2 = np.zeros(n_y,1)
    paraters = {'w1':w1,
                'b1':b1,
                'w2':w2,
                'b2':b2
    }
    return paraters
#正向传播
def forward_propagation(x,paraters):
    w1=paraters['w1']
    w2=paraters['w2']
    b1=paraters['b1']
    b2=paraters['b1']
    z1 = np.dot(w1,x)+b1
    a1 = np.tanh(z1)
    z2 = np.dot(w2,a1)+b2
    a2 = sigmoid(a2)
    cache={'z1':z1,
           'a1':a1,
           'z2':z2,
           'a2':a2
          }
    return a2,cache
#计算损失cost
def compute_cost(a2,y):
    logpro = np.mutiply(np.log(a2),y)+np.mutiply((1-y),np.log(1-a2))
    cost = -1/y.shape[1]*np.sum(logpro)
    return cost
#反向传播得到参数梯度
def backward_propagatition(paraters,cache,x,y):
    m = x.shape[1]
    w1=paraters['w1']
    w2=paraters['w2']
    z1=cache['z1']
    z2=cache['z2']
    a1=cache['a1']
    a2=cache['a2']
    dz2 = a2-y
    dw2 = 1/m*np.dot(dz2,a1.T)
    db2 = 1/m*np.sum(dz2,axis=1)
    dz1 = np.dot(w2.T,dz2)*(1-np.power(a1,2))
    dw1 = 1/m*np.dot(dz1,x.T)
    db1 = 1/m*np.sum(dz1,axis=1)
    grads={'dz2':dz2,
           'dw2':dw2,
           'db2':db2,
           'dz1':dz1,
           'dw1':dw1,
           'db1':db1
          }
    return grads
#更新参数
def update_parameters(paraters,grads,learning_rate=0.01):
    w1=paraters['w1']
    w2=paraters['w2']
    b1=paraters['b1']
    b2=paraters['b1']
    dw2 = grads['dw2']
    dw1 = grads['dw1']
    db2 = grads['db2']
    db1 = grads['db1']
    w1 = w1 - learning_rate*dw1
    w2 = w2 - learning_rate*dw2
    b1 = b1 - learning_rate*db1
    b2 = b2 - learning_rate*db2
    paraters = {'w1':w1,
                'b1':b1,
                'w2':w2,
                'b2':b2
               }
    return paraters
#对模型进行封装
def nn_model(x,y,num_iteration=10000):
    n_x,n_h,n_y= layer_size(x,y)
    parameters = initialize_parameters(n_x,n_h,n_y)
    w1=paraters['w1']
    w2=paraters['w2']
    b1=paraters['b1']
    b2=paraters['b1']
    for i in num_iteration:
        a2,cache = forward_propagation(x,parameters)
        cost = compute_cost(a2,y)
        grads = backward_propagatition(parameters,cache,x,y)
        parameters = update_parameters(parameters,grads,learning_rate=0.01)
    return parameters
(五)深层神经网络(了解前向传播和反向传播)
深层神经网络就是在浅层神经网络的基础上加隐层的层数,随着层数的增加,特征是由整体到局部,由简单到复杂
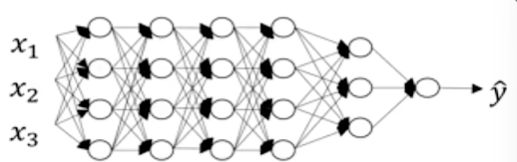
计算过程与浅层一致:
<一>前向传播和反向传播
线性计算 激活函数
z[1] = W[1]*x +b[1],a[1]=g[1](z[1])
z[2] = W[2]*x +b[2],a[2]=g[2](z[2])
z[3] = W[3]*x +b[3],a[3]=g[3](z[3])
z[4] = W[4]*x +b[4],a[4]=g[4](z[4]) (这里的*都是矩阵相乘,g[i]表示第i层的激活函数,传播过程本质上与单神经元网络,浅层神经网络一致,就是在前者基础上叠加层数,类似于不停嵌套。)
反向传播过程于浅层神经网络一致,根据具体的激活函数求得各参数的梯度再进行参数更新
<二>一些额外的补充:参数初始化与超参数
超参数:学习率alpha,迭代次数N,隐藏层层数L,每一层神经元的个数,激活函数选择。
超参数的最优值往往不能确定,需要尝试。
参数初始化(W,b):
W参数要进行随机初始化:两个隐层神经元参数不可以初始化为相同值,因为他们的特征值是一样的,权重W如果一样,这样的影响就是一样的,和只有一个神经元效果是一样的。b随便。
W参数不可过大:z = Wx + b,W小则z就小,趋近于0。那么在sigmoid函数和tanh函数中,z处的导数也就是梯度就大,更新速度才会快,训练过程因此加快。(而使用relu和leaky relu时不存在这种问题)
(六)深度学习进阶
<一>一些基础和原理
(1)softmax回归(用于多分类问题)
到目前为止接触的都是二分类问题,所以输出层都只有一个神经元,输出y^表示是正类的概率P(y=1|x),若
y^ >0.5,则为正类,反之判断为负类。那么对于N分类问题呢,我们自然而然想到在输出层必须用N个神经元来表示N个种类,每个神经元的输出对应当前样本是这N个类别里是某一个类别的概率。
输出层即为: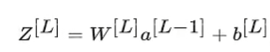 ,Z的输出个数为类别个数,a[L-1]为上一层经过激活函数后的输出,W[L]和b[L]是当前层的权重和偏置。
那么对当前层的这样一个Z结果进行softmax激活可以得到
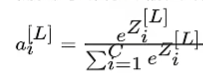 ,ai中i从1到N,即可以得到当前这个样本是每个类别的概率,最后进行比较,取出最大的ai对应着最可能是的类别。
那么下面让我们来看一下softmax是怎样将Z[L]映射成为ai[L]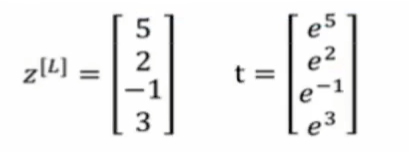 ,
那么ai[L]就等于t中每一个e^x次方除以每一个e^x次方之和:
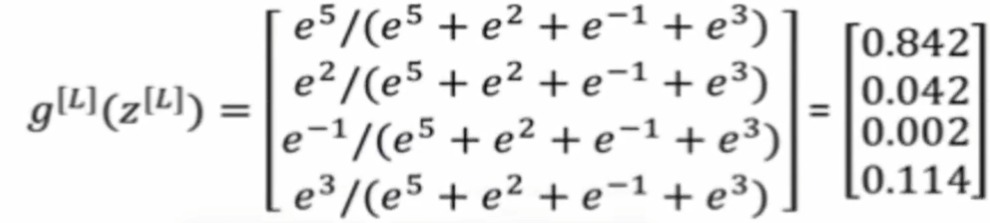
所以经过softmax映射之后这些数值就有这样一些特点:1.所有概率之和为1。2.每一个值都<1。
那么每一行的值我们就可以理解成当前样本是第i个类别(i从1到N)的概率了。
(2)交叉熵损失原理
对于普通的二分类而言,在前向传播之后我们需要得到损失函数(即预测值与真实值的差距),那么对于多分类而言,我们也需要求到损失函数来衡量损失,也就是这里提到的交叉熵损失。
损失函数: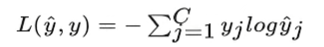
总损失函数: 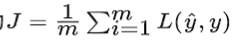 ,对每个样本损失求平均值
原理解释:交叉熵损失其实是逻辑回归代价函数的一个推广,两者其实是一个东西。我们来看一下,在逻辑回归中总损失函数是长这个样子的: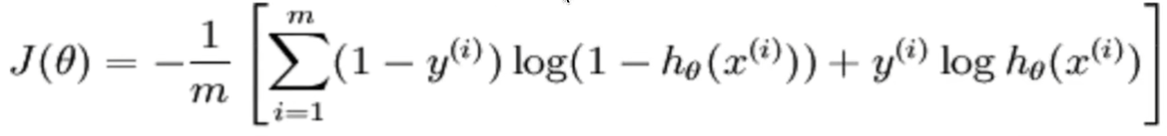 ,h(x)是通过sigmoid得出来的二分类的概率,因为是二分类问题,所以真实值y^(i)只可能是0或1。那么当y^(i)==1时,J = log h(x);当y^(i)==0时,J = log (1-h(x))。那接下来我们把这个公式进行变形,写得更统一点,使用一个式子来表示,而不是表示成a+b的这种形式,就可以得到:
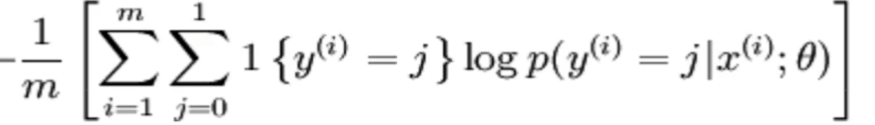
我们来具体看一下这个变形后的式子: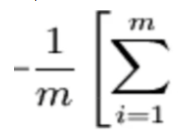 这一项表示的是对m个样本进行求平均值,我们可以不看这一项。那么整个式子的理解就在于后面:
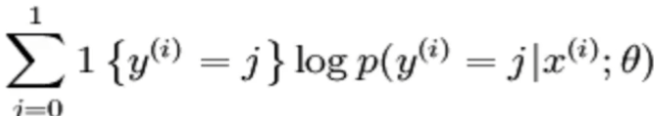
这里的y^(i)表示的是预测值,j表示的是真实值 是1或0。在变形之前的式子中:当y^(i)==1时,J = log h(x);当y^(i)==0时,J = log (1-h(x)) ,而变形之后的式子中log p(...)就表示了当 预测值y^(i)=1时和=0时的两种情况。所以推广到多分类 J = y^(j)logy^(j) 以上的推导只是希望能加深对于原理的理解,实际应用中不会用到这些数学上的推导。
softmax图解: 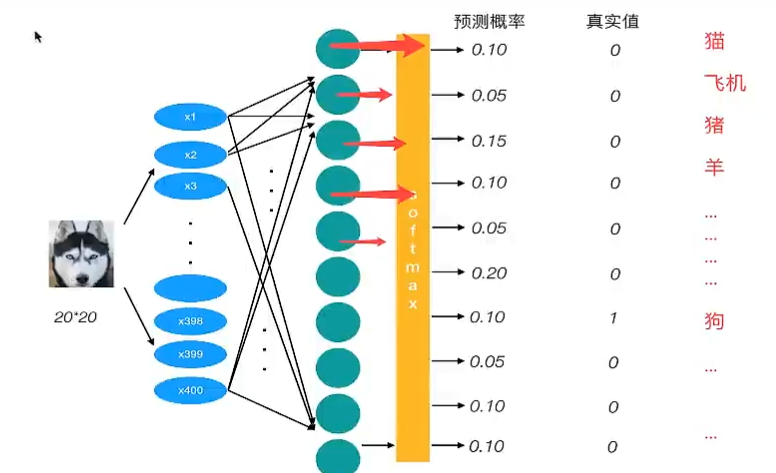
预测概率是由softmax得到的,真实值是这样的一列数字一个N*1的矩阵,我们称之为独热编码(one hot),就等价于一个注释,真实值置为1.
图片是一只狗,但是在我们的预测概率这里y ^(i)才只有0.1,所以我们在这里需要衡量预测概率和真实值之间的一个损失,也就是交叉熵损失。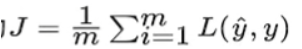
所以J = 0*log0.1+0*log0.05+...+1*log0.1+.... = log0.1,所以要让J变小,就需要调整网络模型,使得预测概率要变大。
<二>简单了解tensorflow基础知识,学会运用tensorflow来简单搭建神经网络
<三>梯度下降算法优化
在网络中的一些参数如学习率的调整当中并不一定都会得到预期的结果,特别在一些大型数据上,网络的效果其实并不好,训练速度太慢了。所以为了解决这些问题,我们可以先对算法进行优化。先不看最后模型预测的准确率,而是先提升我们的计算效率——也就是梯度算法优化
(1)优化遇到的问题:
(1)梯度消失理解:比如alpha太大了,更新的程度过大,导致损失越来越大,无法收敛。我们简单假设一个激活函数为g(z)=z也就是输出原始值,b[L]=0将偏置默认为0,第一层的输出就是W[1]*X,第二层就是W[2]*W[1]*X,那么一直这样做下去对于最终的预测值y^ 就=W[L]*W[L1]*...*W[1]*X,为了简单理解,假设这里的W都是一维的,如果每一层的W[l]都是>0的那么多个W(极端点,假如所有的W都是10)相乘在一起就会造成激活函数g的值指数级增加;反之如果每一层的W都比较小,比如说是0.001,相乘在一起的结果就会造成激活函数的值指数级减小。因为每一层都会有一个激活函数,那么每一层的激活函数的值指数级增加或减小将会导致最后一层的输出值要么特别大要么特别小。那么在计算梯度时,梯度函数也会呈现出指数级增大或减小(因为比如说sigmoid函数中dw就含有一项A-Y,A就是最终的输出值,它会影响到梯度的计算 ),那么步伐长度就要么非常大要么非常小,训练就会变得很困难,
(2)局部最优理解:因为参数W,b的值一开始是随机的,通过梯度下降更新之后的参数可能使得loss的值只是局部最小而并非全局最小。而梯度更新结束的条件是梯度为0,也就是此处导数为零的时候,也就是鞍点,所有减少损失或者说是优化算法的难度就来自于误差曲面J(W,b)中的鞍点。(并不是说不可能发生局部最优点,只是在训练较大的网络的过程中有大量的参数,所有成本函数J的维度就会很高,基本上这种困在局部最优的情况不会发生,所有我们往往忽略这种情况,主要关注解决鞍点的问题)。下面让我们来具体看一下如何对梯度下降算法进行优化:
(2)解决办法
解决办法(1)初始化参数策略,将w随机初始化且尽量使值很小
批量梯度下降算法(batch)
在每一次训练的时候,把所有的样本都拿进来训练,即每一步的梯度下降会对所有样本进行一次,如果数据集很大,训练速度就太慢了。但是我们可以采用每一次都只处理训练数据的一部分来进行梯度下降。
小批量梯度下降(mini-batch)每次处理同样大小的数据集。如果每次都只使用一个样本进行训练,就是随机梯度下降算法。
(这两中办法提到的对样本进行梯度下降处理是什么意思呢,如果你不太清楚的话,可以这么想:我们的目的是进行参数更新,而参数的更新过程是需要求得每个参数W[1]W[2]W[3].....,b[1],b[2]..... 的梯度,求得这些梯度又需要前向传播过程中的一些值,比如中间激活函数的值g[L],预测值y^,.....等等,而这些值都是来自于输入层吧,输入层的x1,x2,x3都是某一个样本的特征吧。假定特征只有3个,如果输入层是3*1的一个矩阵输入,意思就是我只有1个样本,这个样本有3个特征吧,然后通过前向传播反向传播n次来更新我的参数吧,这就是随机梯度下降但这样的话相当于丢掉了向量化带来的计算加速,而且每次迭代的样本不一样会有很多噪声;同理那如果一共有m个样本,我只拿10个出来进行训练,输入层是3*m的一个矩阵,你的W和b的形状也会随之改变,这就是小批量下降,如果我拿m个出来这就是批量。)
下降时的区别:
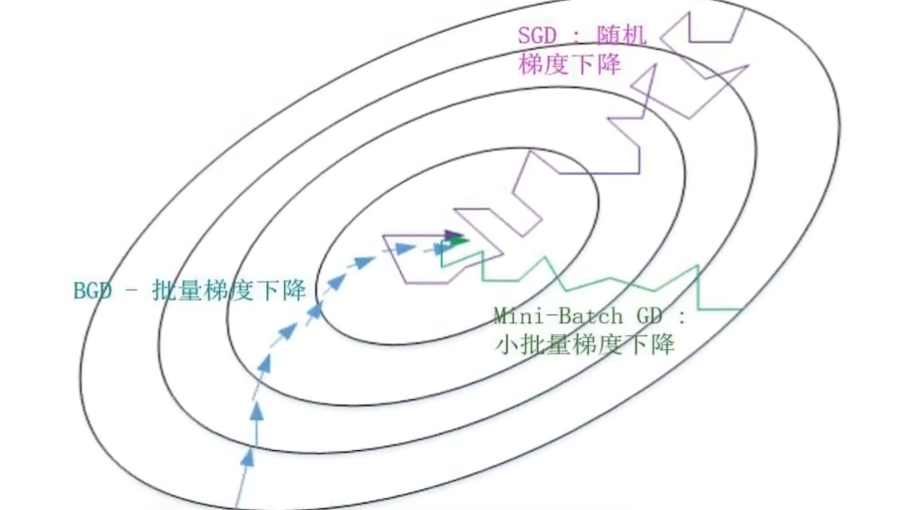
如何进行算法的选择,根据经验: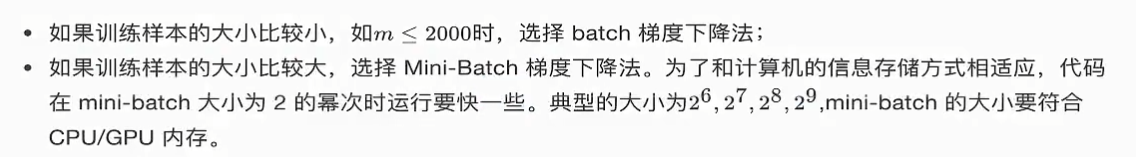
解决办法(2):指数加权平均(针对序列问题,如预测天气,金融等)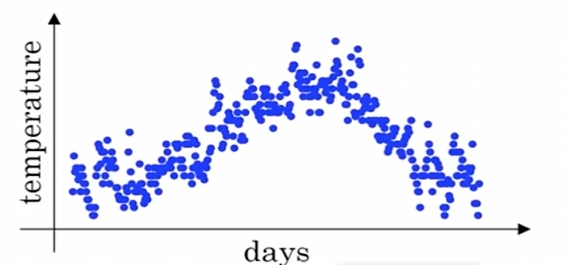
这里可能会出现某一天的气温太高了从而影响模型的判断,所以使用加权公式
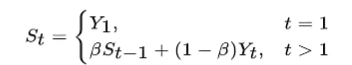 让函数变得平缓一些,beta是权重
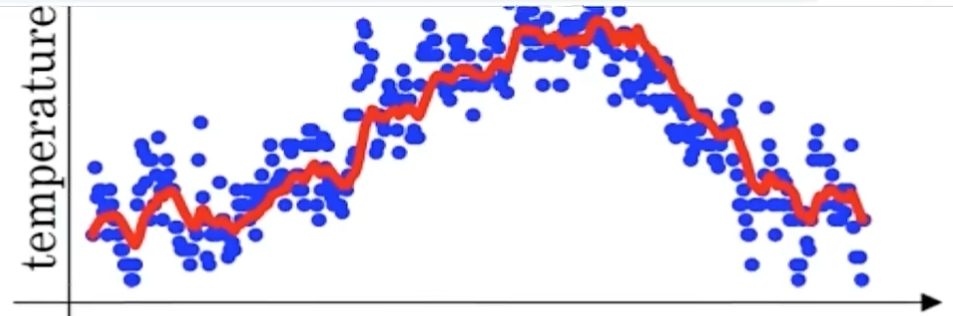
这条红线就是经过加权之后得到的
解决办法(3)动量梯度下降
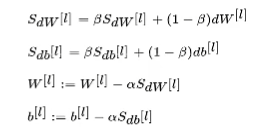
解决办法(4)RMSPropS
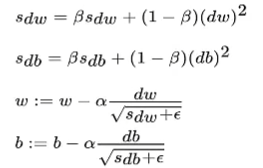
解决办法(4)Adam
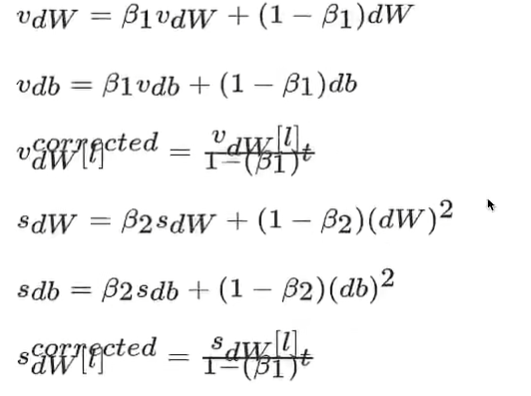
<四>正则化
如果说优化算法是为了提高训练的速度,那么考虑正则化就是为了添加一个惩罚项来惩罚模型的复杂度,防止网络过拟合太过专注于训练集的数据。
L1正则化: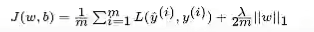
L2正则化: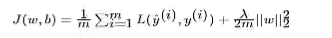
<五>dropout
在训练的过程中每一层都随机丢弃几个神经元不使用,但在测试的时候全部神经元都会使用
keep_prob = 0.8
dl = np.random.rand(al.shape[0],al.shape[1]) < keep_prob
al = np.multiply(al,dl)


al/=keep_Prob
dropput可以起到和L2正则化类似的效果,dropout本身意在减少神经元对某一个特征的依赖。
<六>BN——批标准化
BN的提出是因为网络中的参数太多太难调整。
对隐层的输入进行标准化,不是对a[L]而是对还没有经过激活函数的z[L]
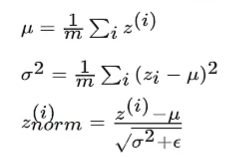
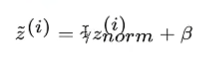

鲲鹏昇腾开发者社区是面向全社会开放的“联接全球计算开发者,聚合华为+生态”的社区,内容涵盖鲲鹏、昇腾资源,帮助开发者快速获取所需的知识、经验、软件、工具、算力,支撑开发者易学、好用、成功,成为核心开发者。
更多推荐
 34
 0
- 0


 已为社区贡献1条内容

所有评论(0)